
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
3DV-TON: 확산 모델 기반 비디오 가상 피팅 생성 프레임워크
小编 ·

3DV-TON: 확산 모델 기반 비디오 가상 피팅 생성 프레임워크
3DV-TON이란 무엇인가요?
3DV-TON(Textured 3D-Guided Consistent Video Try-on via Diffusion Models)은 확산 모델(diffusion model)을 기반으로 한 새로운 비디오 가상 피팅 기술로, 기존의 비디오 가상 피팅 방법이 복잡한 의류 패턴과 다양한 인간 자세에 대응할 때 고품질이면서 시간적으로 일관된 결과를 생성하기 어려웠던 문제를 해결합니다.
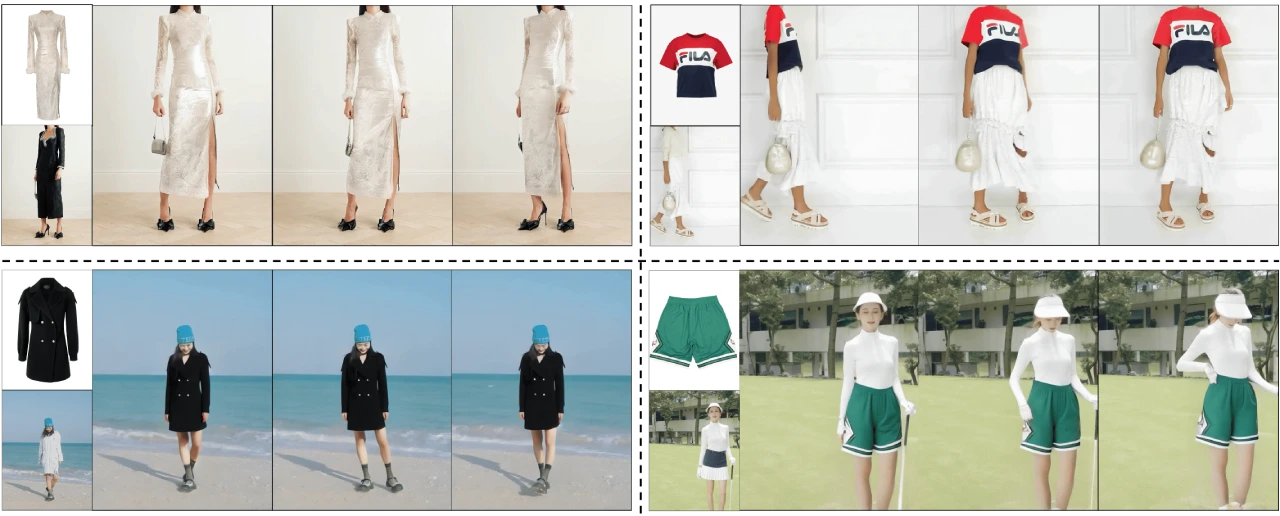
3DV-TON 핵심 기술
3D 텍스처 가이드: 3DV-TON은 생성된 애니메이션 텍스처 3D 메시를 프레임 단위 가이드로 활용하여 의류 텍스처가 인간의 기하학적 디테일(주름 및 음영 효과 등)에 정확히 맞도록 보장합니다.
비디오 일관성: HunyuanVideo 또는 Stable Video Diffusion과 같은 비디오 확산 모델을 통해 동적 장면에서 여러 프레임의 의류 시공간 일관성을 유지하여 깜박임이나 변형을 방지합니다.
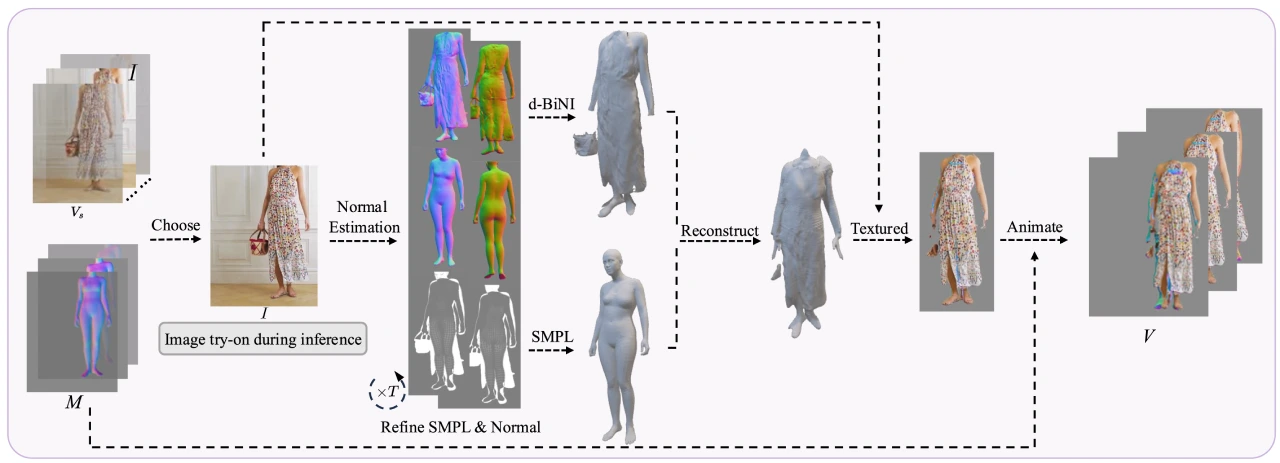
적응형 생성 파이프라인: 이 기술은 적응형 파이프라인을 채택하며, 먼저 하나의 키프레임을 선택하여 초기 2D 이미지 가상 피팅을 수행한 다음, 원본 비디오 자세와 동기화된 텍스처 3D 메시를 재구성하고 애니메이션화합니다.
사각형 마스크 전략: 동적인 인간과 의류 움직임 과정에서 의류 정보 누설로 인한 아티팩트 전파를 효과적으로 완화하는 강력한 사각형 마스크 전략을 도입합니다.
3DV-TON 특징
고충실도 시각 효과: 4K 해상도 출력을 지원하며, 의류 텍스처 디테일(예: 직물 소재 및 패턴)이 사실적이어서 복잡한 동작과 다각도 표시에 적합합니다.
다양한 시나리오 적용: 단일 의류 이미지로부터 동적 가상 피팅 비디오 생성을 지원하며, 전자상거래 전시, 가상 코디 게임, AR/VR 애플리케이션에 적합합니다.
사용자 친화적 인터페이스: API와 시각적 도구를 제공하여 개발자와 디자이너가 텍스트 프롬프트나 이미지 입력을 통해 빠르게 가상 피팅 비디오를 생성할 수 있도록 합니다.
데이터셋
비디오 가상 피팅 연구를 촉진하기 위해 3DV-TON 팀은 또한 HR-VVT를 공개했습니다. 이는 130개의 비디오를 포함하는 고해상도 벤치마크 데이터셋으로, 다양한 의류 유형과 시나리오를 포괄합니다.
3DV-TON 방법
3DV-TON은 생성된 애니메이션 가능한 텍스처 3D 메시를 명시적인 프레임 단위 가이드로 활용하여 모델이 외관 충실도에 과도하게 집중하여 운동 일관성을 소홀히하는 것을 방지하며, 적응형 파이프라인을 통해 동적 3D 가이드를 생성합니다. 먼저 키프레임을 선택하여 초기 2D 이미지 의류 교체를 수행한 다음, 원본 비디오 자세와 동기화된 텍스처 3D 메시를 재구성하고 애니메이션화합니다. 또한 강력한 사각형 마스킹 전략을 도입하여 동적인 인간과 의류 움직임에서 의류 정보 누설로 인한 아티팩트 전파를 줄입니다.
3DV-TON 적용 시나리오
전자상거래: Shopify 및 Amazon과 같은 전자상거래 플랫폼을 위한 동적 의류 가상 피팅 비디오 생성.
가상 패션 및 메타버스: VR/AR 가상 피팅 경험을 지원하여 가상 환경에서 디지털 의류를 입어볼 수 있게 합니다.
영화 및 애니메이션: 디지털 캐릭터의 사실적인 의류 애니메이션을 생성하여 CG 제작 비용을 절감합니다.
개인 맞춤화: 사용자가 업로드한 신체 데이터와 의류 이미지를 결합하여 개인화된 가상 피팅 비디오를 생성합니다.
프로젝트 홈페이지: https://2y7c3.github.io/3DV-TON/
논문: https://2y7c3.github.io/pdfs/3dvton.pdf









