
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
Muyan-TTS: Muyan에서 출시한 팟캐스트 전용 오픈소스 학습 가능 TTS 모델
小编 ·

Muyan-TTS: Muyan에서 출시한 팟캐스트 전용 오픈소스 학습 가능 TTS 모델
Muyan-TTS란 무엇인가요?
Muyan-TTS는 베이징 Muyan Zhiyu(沐言智语)에서 출시한 오픈 소스 및 학습 가능한 TTS 모델로, 팟캐스트를 위해 특별히 설계되었으며 예산은 5만 달러 이내로 통제됩니다. Muyan-TTS는 10만 시간 이상의 팟캐스트 오디오 데이터로 사전 학습되어 제로샷 TTS 합성을 지원하며, 고품질 음성을 생성할 수 있고, 수십 분 분량의 목표 음성을 통한 화자 적응 조정도 가능합니다.
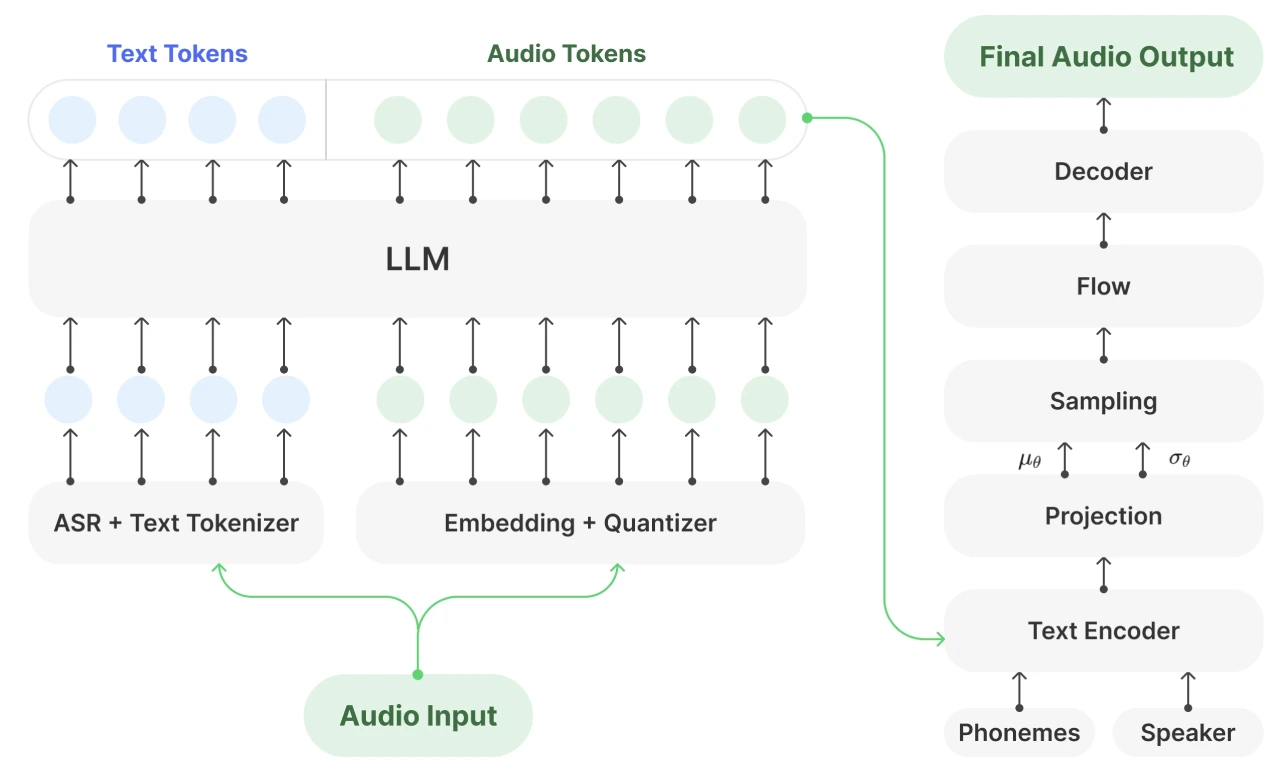
Muyan-TTS 모델 특징
대규모 사전 학습: Muyan-TTS는 Llama-3.2-3B 모델을 기반으로 하며, 10만 시간 이상의 팟캐스트 오디오 데이터를 사용하여 사전 학습되어 제로샷 텍스트 음성 변환ai 합성을 구현하고 고품질 음성을 생성할 수 있습니다.
화자 적응 지원: 수십 분 분량의 목표 화자 음성 데이터를 통해 Muyan-TTS는 특정 화자의 음성 특징에 추가로 적응할 수 있어 높은 수준의 맞춤화된 음성 합성을 실현합니다.
아키텍처 설계: Muyan-TTS는 GPT-SoVITS의 2단계 구조를 채택하며, 언어 모델 부분은 Llama-3.2-3B를 backbone으로 계속 사전 학습되고, 디코더 부분은 SoVITS 아키텍처를 사용하여 LLM의 의미 모델링 능력과 VITS 모델의 음소-음소(G2P) 특성을 결합하여 환각 현상을 효과적으로 줄였습니다.
데이터 처리: 10만 시간 이상의 고품질 음성과 해당 전사 내용이 포함된 병렬 코퍼스를 구축했으며, 팟캐스트 등 긴 오디오 시나리오의 TTS 학습에 적합합니다.
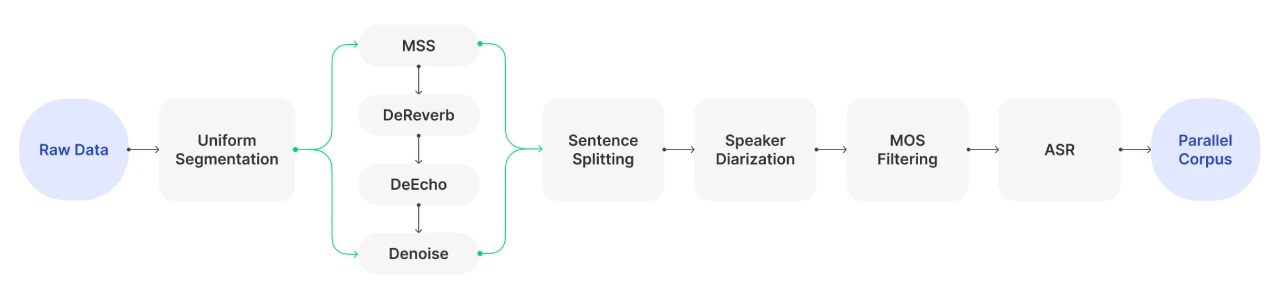
오픈 소스 및 학습
오픈 소스 정보: Muyan-TTS는 완전한 오픈 소스로, 완전한 데이터 수집 및 처리流程, 자세한 학습 방법 및 최적화된 추론 프레임워크를 제공합니다. 해당 코드와 모델은 GitHub에서 찾을 수 있습니다.
학습 비용: 학습 비용 측면에서 A10 및 A100 GPU의 임대 가격이 각각 시간당 0.5달러와 1달러라고 가정하면, Muyan-TTS의 총 학습 비용은 약 50,540달러입니다.
성능表现
제로샷 합성: LibriSpeech 데이터 세트에서 Muyan-TTS의 제로샷 합성 성능은出色하며, 단어 오류율은 CosyVoice2에 이어 두 번째이며, 평균 의견 점수는 Spark-TTS 및 GPT-SoVITS v3보다 높습니다.
지도 미세 조정 모델: 지도 미세 조정을 거친 Muyan-TTS-SFT는 음성 품질 및 화자 유사도에서 기본 모델보다 우수하지만, WER에서는 약간 감소합니다.
추론 속도: Muyan-TTS의 추론 속도는 테스트된 모든 모델 중 가장 빠르며, 1초의 음성을 합성하는 데 0.33초만 필요하여 실시간 음성 생성 시나리오에 적합합니다.
Muyan-TTS 응용 시나리오
Muyan-TTS는 진행자 내레이션, 인터뷰 재현, 음성 요약 등 다양한 오디오 콘텐츠 형식에 적합합니다. 합성 품질, 개인화 능력 및 运行 효율성을兼顾하여 팟캐스트 등 긴 오디오 시나리오에 적합합니다.
제한 사항
디코더의 G2P 모듈에 의존하여 완전한 음소 시퀀스가 있어야 합성할 수 있으며, 스트리밍 추론은 구현할 수 없습니다.
학습 데이터가 주로 영어이므로, 다국어 음성 합성 능력은 제한적입니다.
학습 말뭉치에 지시문 수준의 레이블이 부족하기 때문에, Muyan-TTS는 현재 지시문 따르기 TTS 작업을 지원하지 않습니다.
Muyan-TTS 설치 및 사용
설치 단계
1. 저장소를 복제하고 가상 환경을 생성합니다:
git clone https://github.com/MYZY-AI/Muyan-TTS.git
cd Muyan-TTS
conda create -n muyan-tts python=3.10 -y
conda activate muyan-tts
make build
2. FFmpeg 설치(Ubuntu 시스템):
sudo apt update
sudo apt install ffmpeg
3. 모델 다운로드:
Muyan-TTS 및 Muyan-TTS-SFT 모델은 Hugging Face 또는 ModelScope에서 다운로드할 수 있습니다.
또한 chinese-hubert-base의 가중치를 다운로드해야 합니다.
다운로드한 모든 모델을 pretrained_models 디렉토리에 둡니다.
사용 방법
음성 합성을 위해 다음 명령을 실행합니다:
python tts.py
핵심 추론 코드는 다음과 같습니다:
async def main(model_type, model_path):
tts = Inference(model_type, model_path, enable_vllm_acc=False)
wavs = await tts.generate(
ref_wav_path="assets/Claire.wav",
prompt_text="Although the campaign was not a complete success, it did provide Napoleon with valuable experience and prestige.",
text="Welcome to the captivating world of podcasts, let's embark on this exciting journey together."
)
output_path = "logs/tts.wav"
with open(output_path, "wb") as f:
f.write(next(wavs))
print(f"Speech generated in {output_path}")
github 저장소:https://github.com/MYZY-AI/Muyan-TTS









