
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
Alibaba, Qwen3 출시: 두 가지 사고 모드와 다국어 지원
小编 ·

Alibaba, Qwen3 출시: 두 가지 사고 모드와 다국어 지원
알리바바가 2025년 4월 29일 공식적으로 Qwen3 시리즈 모델을 출시했습니다. 이는 Qwen 시리즈 대규모 언어 모델의 최신 멤버로, 플래그십 모델 Qwen3-235B-A22B와 소형 MoE 모델 Qwen3-30B-A3B 등 여러 모델이 코드, 수학, 일반 능력 등 벤치마크 테스트에서 뛰어난 성능을 보였습니다. Qwen3은 여러 모델 가중치를 오픈소스로 공개했으며, 다양한 플랫폼에서 사용할 수 있도록开放했습니다.
Qwen3은 두 가지 사고 모드를 지원하고, 다국어 능력을 갖추고 있으며, Agent 및 코드 능력이 최적화되었습니다. 사전 학습 데이터량은 약 36조 개 token이며, 사전 학습은 세 단계로 진행되고, 사후 학습은 4단계 학습 프로세스를 채택했습니다.
모델 하이라이트
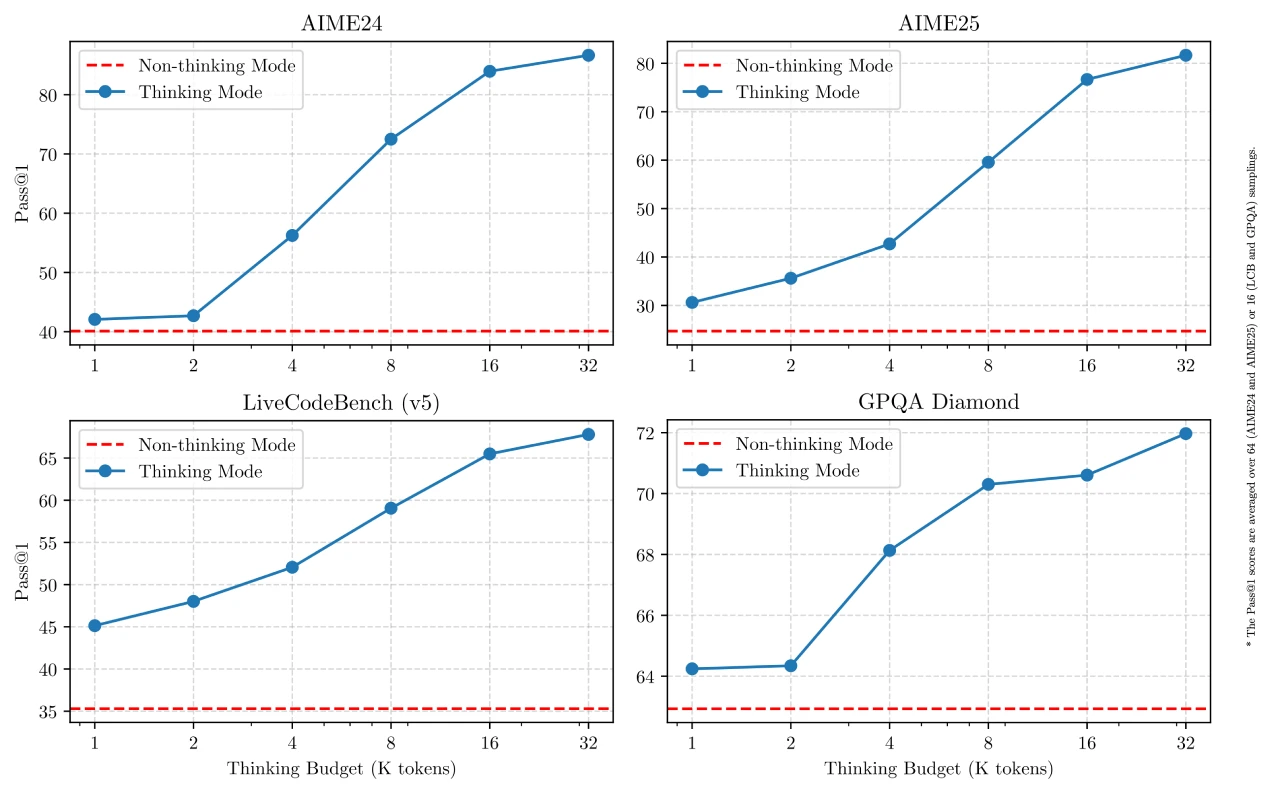
다양한 사고 모드: 사고 모드와 비사고 모드, 두 가지 모드를 지원합니다. 사고 모드는 복잡한 문제에 적합하며 모델이 단계별로 추론합니다. 비사고 모드는 간단한 문제에 적합하며 빠르게 응답할 수 있습니다. 두 가지 모드의 결합은 "사고 예산" 제어 능력을 강화하여, 사용자가 필요에 따라 구성할 수 있게 합니다.
다국어 능력: 119개 언어와 방언을 지원하며, 인도유럽어족, 한티베트어족 등 다양한 어족을 포괄하여 국제 응용에 가능성을 제공합니다.
강화된 Agent 능력: Agent 및 코드 능력이 최적화되었으며, MCP 지원이 강화되었습니다. Qwen-Agent를 통해 도구 호출의 코드 복잡성을 낮출 수 있습니다.
Qwen3 성능表现
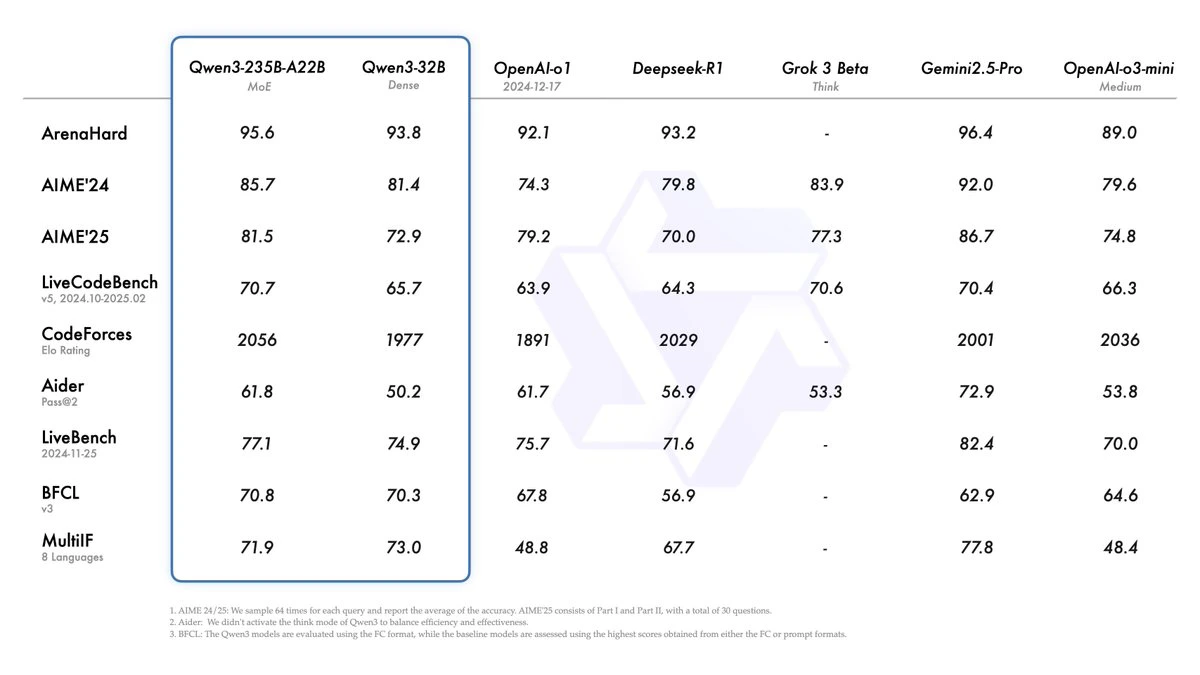
플래그십 모델: Qwen3-235B-A22B는 이 시리즈의 플래그로로, 총 2,350억 개의 파라미터와 220억 개의 활성 파라미터를 보유하고 있습니다. 코드, 수학, 일반 능력 등 벤치마크 테스트에서 DeepSeek-R1, Openai의 o1 및 o3-mini, 머스크의 Grok-3, 구글의 Gemini-2.5-Pro 등 최상위 모델들과 비교하여 매우 경쟁력 있는 결과를 보였습니다.
소형 모델: 소형 MoE 모델 Qwen3-30B-A3B의 활성 파라미터 수는 QwQ-32B의 10%이지만, 더 우수한 성능을 보입니다. 또한 Qwen3-4B와 같은 소형 모델도 Qwen2.5-72B-Instruct의 성능에 필적할 수 있습니다.
Qwen3 기술 특징
하이브리드 추론 모델: Qwen3은 국내 최초의 "하이브리드 추론 모델"로, "빠른 사고"와 "느린 사고"를 동일한 모델에 통합했습니다. 이러한 설계는 복잡한 문제를 해결할 때 심층 추론을 수행하고, 간단한 요청을 처리할 때 빠르게 응답할 수 있게 합니다.
다국어 지원: Qwen3은 119개 언어를 지원하며, 약 36조 개의 token(토큰)으로 학습되었으며, 학습 데이터 양은 Qwen2.5의 두 배입니다.
컨텍스트 길이: Qwen3은 최대 256K의 컨텍스트 길이를 지원하여, 긴 문서 분석, 코드 생성, 다轮 대화 등 복잡한 작업을 처리할 수 있습니다.
Qwen3 모델 성능과 비용
플래그십 버전 Qwen3-235B-A22B: 총 파라미터 수는 2,350억, 활성 파라미터는 220억입니다. DeepSeek-R1과 비교하여 총 파라미터 수는 후자의 3분의 1에 불과하며, 배포 비용은 절반 이상 절약될 것으로 예상됩니다. 또한 이 모델은 필요에 따라 "심층 사고" 모드를 활성화할 수 있으며, H20 GPU 4장만으로 로컬 배포가 가능합니다.
Qwen3-30B-A3B: 총 파라미터 수는 300억, 활성 파라미터는 30억이며, 전반적인 성능은 Qwen2.5-32B에 필적합니다.
Qwen3 기능 특징
MCP 프로토콜 네이티브 지원: Qwen3 시리즈는 도구 호출 능력을 갖추고 있으며, 자체 Qwen-Agent 프레임워크와 결합하여 프로그래밍 복잡성을 크게 낮추었습니다. 스마트폰 및 PC에서 Agent 작업 등을 구현할 수 있도록 지원하여, AI가 대화에서 실행으로 나아가는 것을推动합니다.
다국어 지원: 중국어, 영어, 프랑스어, 스페인어, 러시아어, 아랍어 등 119개 언어를 지원합니다.
오픈소스 모델: Qwen3 시리즈는 총 8개 모델을 오픈소스로 공개했으며, 다음을 포함합니다:
6개의 Dense 모델: 0.6B, 1.7B, 4B, 8B, 14B, 32B
2개의 MoE 모델: Qwen3-30B-A3B와 플래그십 버전 Qwen3-235B-A22B
최소 모델 Qwen3-0.6B: 경량으로 설계되어 스마트폰 등 에지 디바이스 배포에 매우 적합하며, 동시에 우수한 이해 및 생성 능력을 유지하여 에지 지능형 애플리케이션에 적합합니다.
학습 과정
사전 학습: 데이터셋은 Qwen2.5 대비 크게 확장되어 약 36조 개의 token에 달하며, 이는 Qwen2.5의 두 배입니다. 데이터 출처에는 웹, PDF 문서 등이 포함되며, 전문가 모델을 활용하여 수학 및 코드 데이터를 합성합니다. 사전 학습은 세 단계로 진행되며, 기본 언어 기술 학습에서 지식 집약적 데이터 학습 추가, 그리고 컨텍스트 길이를 32K token으로 확장하는 단계까지 포함합니다.
사후 학습: 사고 추론과 빠른 응답 능력을 동시에 갖춘 하이브리드 모델을 개발하기 위해, 4단계 학습 프로세스를 채택합니다. 여기에는 긴 사고 사슬 콜드 스타트, 긴 사고 사슬 강화 학습, 사고 모드 융합, 일반 강화 학습이 포함됩니다.
사용 방법
기본 사용: Hugging Face의 transformers에서 Qwen3-30B-A3B를 사용하는 표준 예제 코드가 있으며, enable_thinking 파라미터를 수정하여 사고 모드를 전환할 수 있습니다.
배포: sglang>=0.4.6.post1 또는 vllm>=0.8.4를 사용하여 OpenAI API와 호환되는 API endpoint를 생성할 수 있으며, 특정 파라미터를 제거하면 사고 모드를 비활성화할 수 있습니다.
로컬 개발: ollama, LMStudio, llama.cpp, ktransformers 등 도구를 사용하여 로컬 개발을 진행할 수 있습니다.
고급 사용법: 소프트 스위치 메커니즘을 제공하며, 사용자 프롬프트나 시스템 메시지에 /think 및 /no_think를 추가하여 매 차례 사고 모드를 전환할 수 있습니다.
관련 링크
블로그:https://qwenlm.github.io/zh/blog/qwen3/
HF:https://huggingface.co/collections/Qwen/qwen3-67dd247413f0e2e4f653967f
github:https://github.com/QwenLM/Qwen3
Demo:https://huggingface.co/spaces/Qwen/Qwen3-Demo
Qwen Chat:https://chat.qwenlm.ai









