
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
LiveCC: ByteDance와 싱가포르 국립대학이 공동 개발한 실시간 해설 가능 비디오 LLM
小编 ·

LiveCC: ByteDance와 싱가포르 국립대학이 공동 개발한 실시간 해설 가능 비디오 LLM
LiveCC란 무엇인가요?
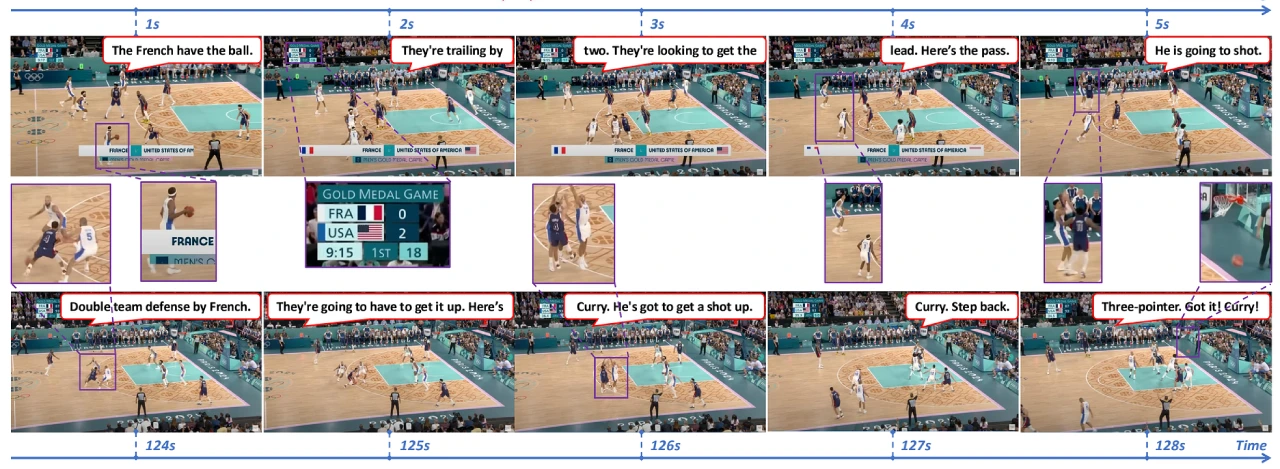
LiveCC는字节跳动과 싱가포르 국립대학교가 공동으로 개발한 비디오 대규모 언어 모델로, 실시간으로 비디오 내용을 해설할 수 있습니다. 자동 음성 인식(ASR) 전사 데이터를 기반으로 학습되어 비용이 낮고 효율이 높습니다. 연구팀은 새로운 스트리밍 학습 방법과 데이터 생산 파이프라인을 개발했으며, Live-CC-5M과 Live-WhisperX-526K이라는 두 가지 데이터셋을 구축했습니다. 고품질 지도 미세 조정을 거치지 않았음에도 불구하고, LiveCC-7B-Base 모델은 비디오 질의응답과 실시간 해설에서 뛰어난 성능을 보입니다. LiveSports-3K 벤치마크 테스트를 통해 평가한 결과, 최종 LiveCC-7B-Instruct 모델은 실시간 해설 품질에서 72B급 최첨단 모델을 능가했으며, VideoMME 및 OVOBench와 같은 비디오 질의응답 벤치마크에서도 최고의 성과를 달성했습니다.
LiveCC의 핵심 특징
모델 학습 방법
혁신적인 학습 방식: 비디오-ASR 스트리밍 학습이라는 새로운 방법을 제안합니다. 타임스탬프에 따라 ASR 단어와 비디오 프레임을 밀접하게交织(뒤섞어) 배치하여 ASR의 스트리밍 특성에 부합하도록 함으로써, 모델이 시간 정렬 및 세밀한 시각-언어 모델링을 학습할 수 있게 합니다.
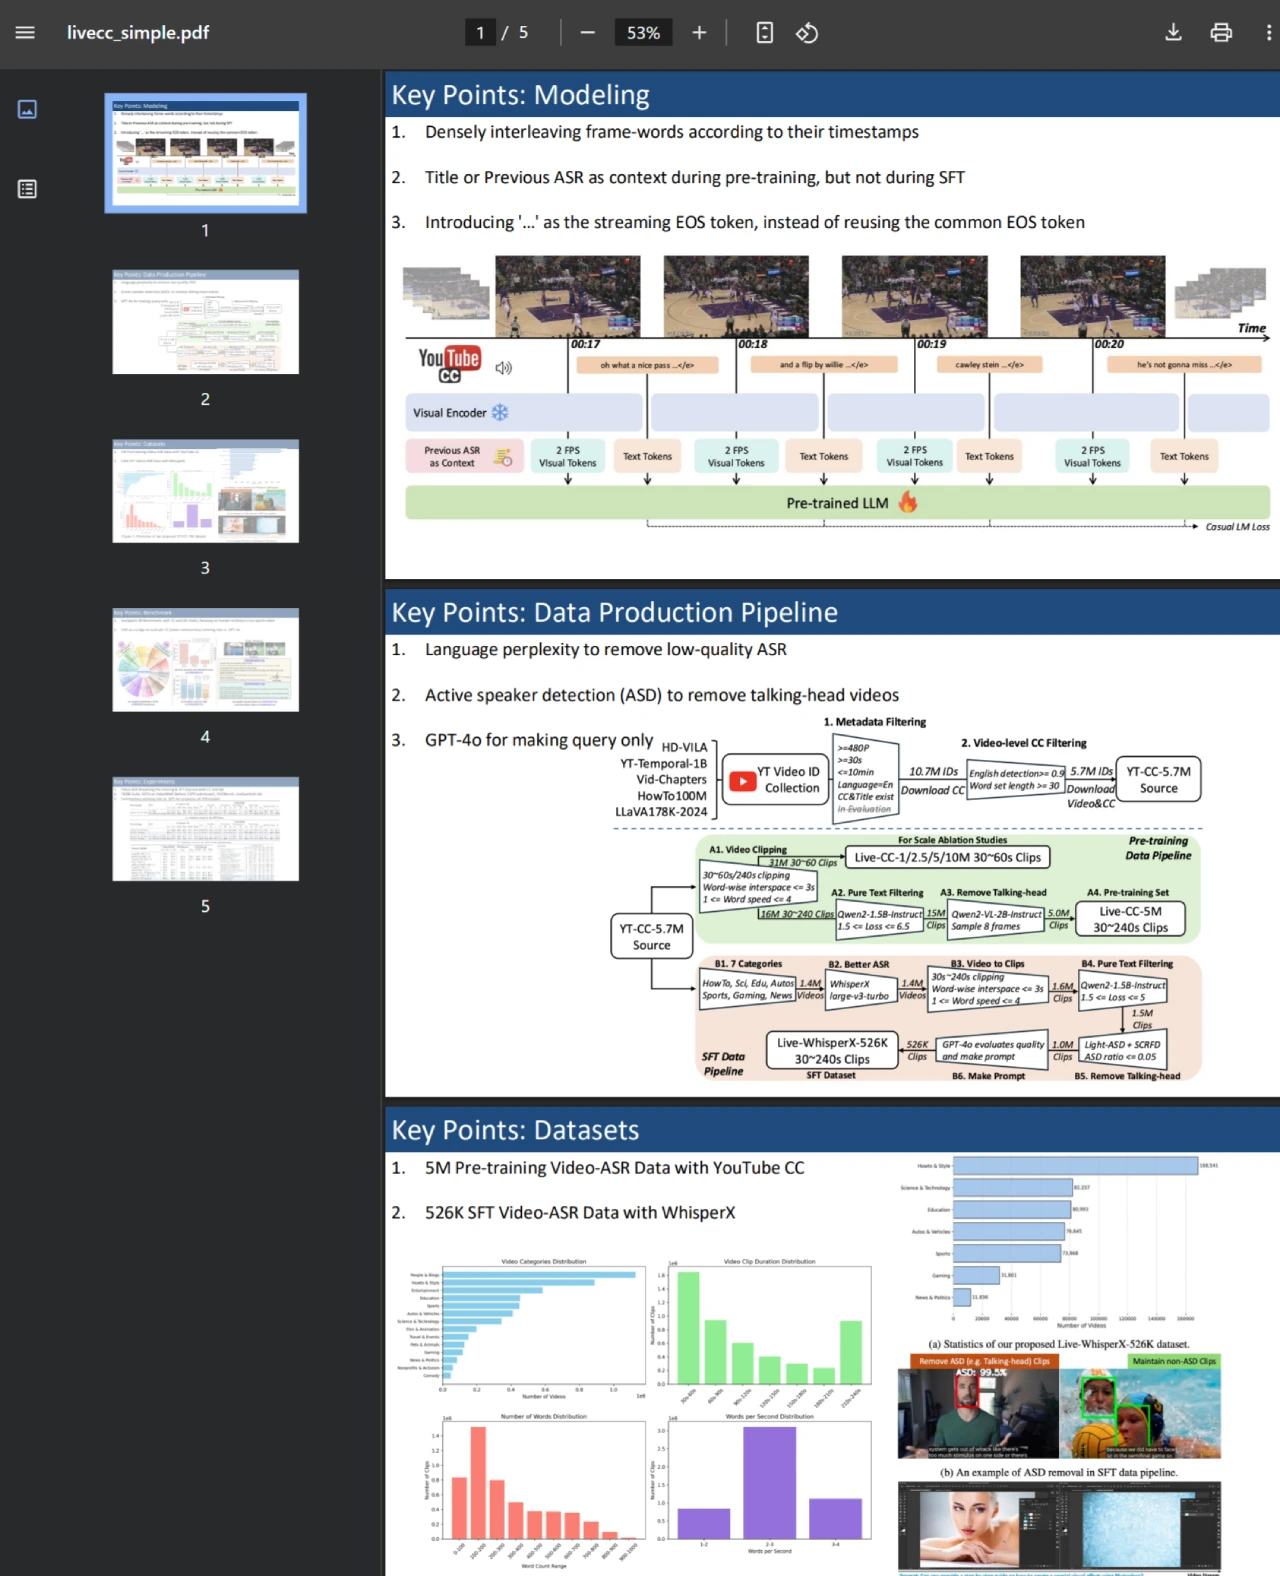
데이터 생산 및 데이터셋 구축: YouTube 비디오와 그 자막(CC, ASR과 동일)을 처리하는 데이터 생산 파이프라인을 도입하여, 사전 학습용 Live-CC-5M 데이터셋과 고품질 지도 미세 조정(SFT)용 Live-WhisperX-526K 데이터셋을 구축했습니다.
모델 성능
LiveCC-7B-Base 모델: SFT를 거치지 않았음에도 불구하고, 이 모델은 범용 비디오 질의응답 작업에서 경쟁력 있는 성능을 보여주었으며, 실시간 비디오 해설이라는 새로운 능력을 갖추고 있습니다.
LiveCC-7B-Instruct 모델: 정교하게 설계된 LiveSports-3K 벤치마크 테스트(자유 형식 해설을 측정하기 위해 LLM을 평가 기준으로 사용)를 통해 평가한 결과, 이 모델은 실시간 모드에서 Qwen2.5-VL-72B-Instruct, LLaVA-Video-72B와 같은 72B급 최첨단 모델을 능가하는 해설 품질을 보였습니다. VideoMME 및 OVOBench와 같은 인기 있는 비디오 질의응답 벤치마크에서 7B/8B 규모로 최첨단 성과를 달성하여, 해당 방법론의 광범위한 범용성을 입증했습니다.
LiveCC 활용 분야
LiveCC는 비디오 콘텐츠의 실시간 해석, 스포츠 경기의 실시간 중계, 교육용 비디오의 인터랙티브 설명 등 다양한 분야에서 널리 활용될 수 있습니다.
자주 묻는 질문
질문: LiveCC는 다른 비디오 대규모 언어 모델과 비교하여 학습 데이터 확보 측면에서 어떤 차이점이 있나요?
답변:LiveCC는 비용이 저렴한 자동 음성 인식(ASR) 전사 데이터를 활용하여 대규모 학습을 수행하는 반면, 다른 모델들은 종종 값비싼 수동 주석이나 GPT-4o와 같은 독점 모델 API에 의존합니다. 이러한 차이 덕분에 LiveCC는 학습 데이터의 비용과 규모 면에서 더 큰 장점을 가집니다.
질문: Live-CC-5M과 Live-WhisperX-526K 데이터셋은 각각 어떤 역할을 하나요?
답변:Live-CC-5M 데이터셋은 모델의 사전 학습에 사용되어 모델이 범용적인 시각-언어 특징과 지식을 학습하도록 돕습니다. Live-WhisperX-526K 데이터셋은 고품질 지도 미세 조정(SFT)에 사용되어 모델이 특정 작업에서 더 나은 성능을 발휘하고 전반적인 성능을 향상시킵니다.
질문: LiveCC-7B-Instruct 모델이 실시간 해설에서 72B 모델을 능가한다는 것은 어떤 의미가 있나요?
답변:이는 LiveCC의 학습 방법과 모델 아키텍처가 효과적이며, 더 적은 파라미터 수로도 더욱 효율적인 실시간 해설 기능을 구현할 수 있음을 보여줍니다. 이는 스포츠 경기 실시간 중계와 같은 실시간 애플리케이션 시나리오에서 비디오 대규모 언어 모델의 보급을 위한更具(보다) 비용 효율적인 솔루션을 제공합니다.
관련 링크
GitHub 저장소 주소:https://github.com/showlab/livecc
Releases 페이지:https://github.com/showlab/livecc/releases
프로젝트 홈페이지:https://showlab.github.io/livecc/
논문 링크:https://arxiv.org/abs/2504.06885
온라인 데모:https://huggingface.co/spaces/chenjoya/LiveCC









