
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
No-OCR: OCR 텍스트 추출이 필요 없는 문서 처리 도구
小编 ·

No-OCR: OCR 텍스트 추출이 필요 없는 문서 처리 도구
No-OCR이란 무엇인가요?
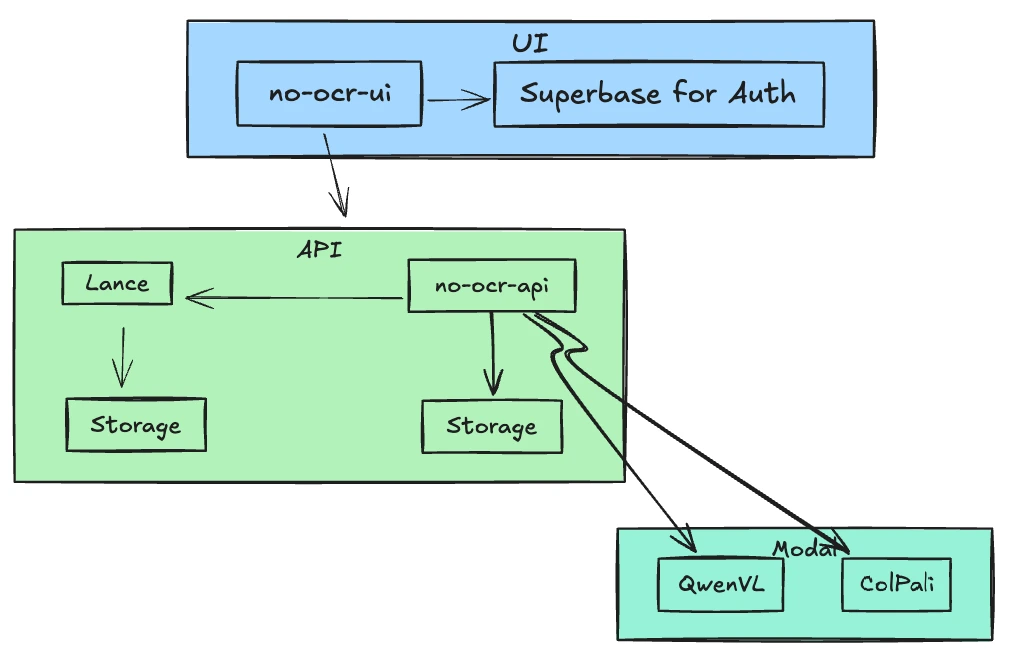
No-OCR은 복잡한 OCR 텍스트 추출이 필요 없는 문서 처리 도구로, PDF 파일을 업로드하기만 하면 여러 문서 모음에서 빠르게 콘텐츠를 검색하거나 조회할 수 있습니다. 전통적인 OCR 기술에 의존하지 않아 문서 분석 효율을 높일 수 있습니다. PDF/문서 모음을 생성하고 관리하는 기능을 지원하며, "케이스"별로 분류하여 정리하고 Hugging Face 스타일의 데이터셋도 자동으로 구축합니다. 또한 No-OCR은 벡터 기반의 PDF 페이지 및 관련 이미지 검색 기능(LanceDB 사용)을 제공하며, Qwen2-VL을 통해 이미지와 차트에 대한 시각적 질의응답을 구현합니다. 텍스트와 시각적 쿼리의 혼합 검색을 지원하며, Docker를 통해 빠르게 배포할 수 있고 설정이 간단하며 자세한 개발 및 설치 안내도 제공합니다.
No-OCR 특징
OCR 불필요: OCR 기술에 전혀 의존하지 않으며, 시각적 콘텐츠가 풍부한 PDF 파일에 적합합니다.
간단하고 사용하기 쉬움: PDF 파일을 업로드하면 바로 검색할 수 있으며, 복잡한 시각적 콘텐츠(테이블, 차트, 레이아웃 등)도 지원합니다.
오픈 소스 모델: 오픈 소스 LLM(대규모 언어 모델)을 기반으로 콘텐츠 검색 및 해석을 수행합니다.
배포 가능성: Docker 배포를 지원하며, 모든 기업 환경에 적용할 수 있습니다.
No-OCR 사용 시나리오
적용 시나리오: 문서에 테이블, 차트, 레이아웃 등 풍부한 시각적 콘텐츠가 포함된 경우, No-OCR은非常好的 선택입니다.
적용하기 어려운 시나리오: 문서가 주로 일반 텍스트로 구성된 경우, 전통적인 BM25 검색이 더 적합할 수 있습니다.
혼합 콘텐츠: 문서에 텍스트와 시각적 콘텐츠가 혼합된 경우, 필요에 따라 솔루션을 조정해야 할 수 있습니다.
No-OCR 아키텍처 설계
간단한 아키텍처: 데이터베이스나 메시지 큐에 의존하지 않으며, 모든 영구화 작업은 파일 시스템을 기반으로 합니다.
주요 서비스:
Modal: LLM 배포에 사용됩니다.
Qdrant: 다중 벡터 검색에 사용됩니다.
Supabase: 사용자 인증 및 권한 관리에 사용됩니다.
케이스 생성: 사용자가 PDF 파일을 업로드하고 케이스 이름을 지정하면, 시스템이 PDF를 데이터셋으로 변환하여 Qdrant에 업로드합니다.
검색 프로세스: 사용자가 검색 쿼리를 입력하면, 시스템이 LLM을 통해 관련 페이지를 식별하고 콘텐츠를 해석합니다.
No-OCR LLM 모델
ColPali 제품군: 이미지를 검색 가능한 형식으로 변환하여 이미지 검색에 사용됩니다.
Qwen2-VL 제품군: 시각적 콘텐츠 추론에 사용되며, 특히 Qwen2-VL-7B-Instruct 모델은 현재 가장先进的 오픈 소스 시각 모델 중 하나입니다.
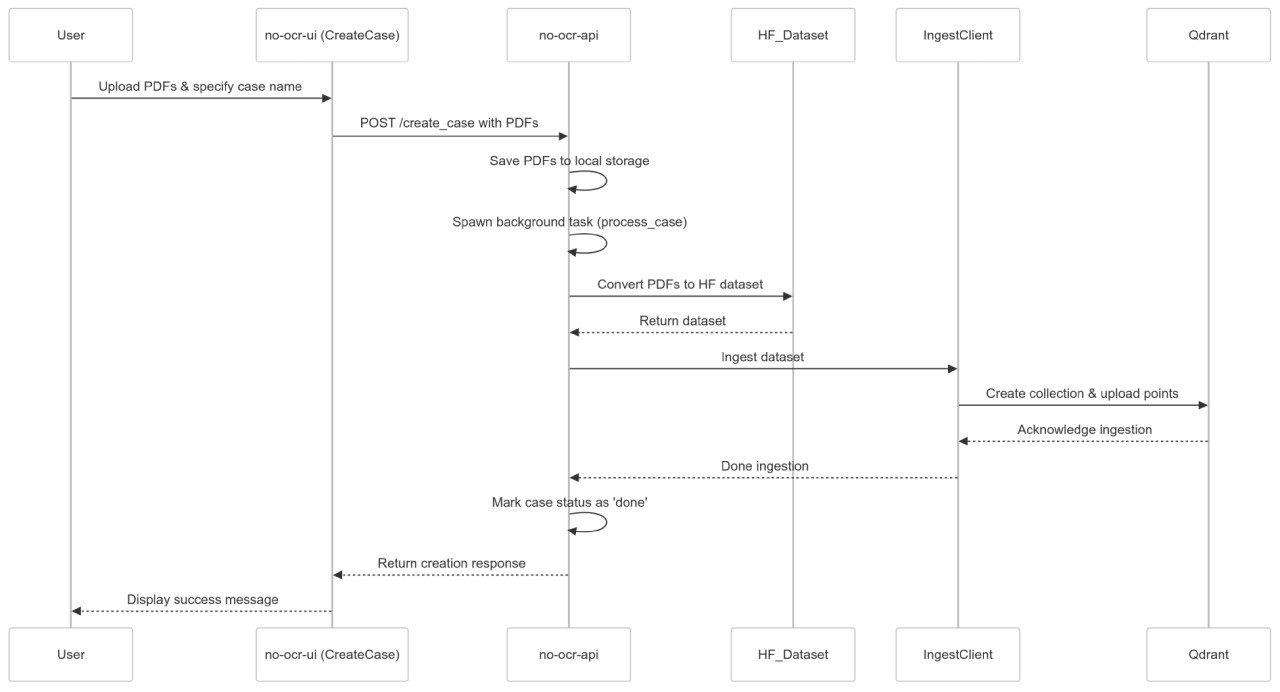
케이스 생성 프로세스
작동 원리
No-OCR 플랫폼은 간소화된 RAG 방식을 채택하여, 사용자는 PDF 파일을 업로드하여 케이스를 생성하기만 하면 시스템이 해당 파일을 처리하여 검색 가능하게 만듭니다. 사용자는 시각적 요소에 대한 질문을 포함하여 어떤 질문이든 할 수 있으며, 플랫폼은 최고의 오픈 소스 추론 모델을 활용하여 답변을 제공합니다.
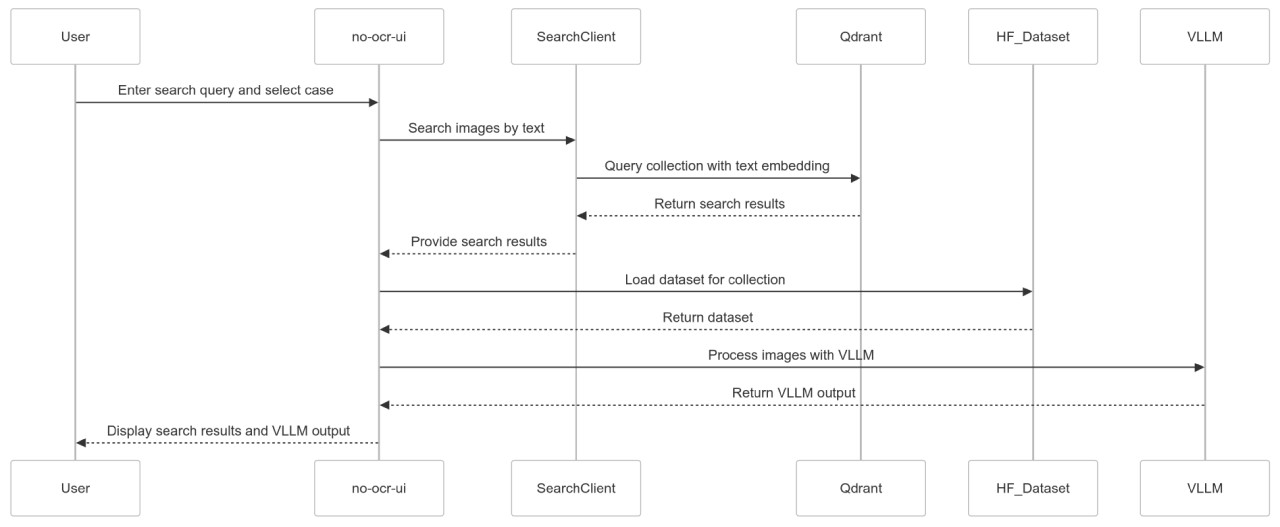
검색 프로세스
No-OCR 사용 단계
복잡한 PDF 업로드 및 처리: 사용자가 까다로운 PDF 파일을 업로드하여 새 케이스를 생성하면, 시스템이 복잡한 OCR 처리 없이 임베딩을 생성합니다.
검색 가능하게 만들기: 처리가 완료되면 사용자는 텍스트 기반 쿼리를 실행하여 관련 페이지와 인용을 빠르게 찾을 수 있으며, PDF 레이아웃이 얼마나 복잡하든 상관없습니다.
시각적 관련 질문하기: 플랫폼이 관련 페이지를 빠르게 찾은 다음, 전용 오픈 소스 시각 모델을 통해 답변을 추가로 정제하여, PDF에 차트나 그래프가 포함되어 있더라도 컨텍스트를 인지하는 통찰력을 제공합니다.
TLDR:https://no-ocr.com/about
Github:https://github.com/kyryl-opens-ml/no-ocr









