
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
Video-R1: 홍콩중문대학과 칭화대학이 공동 출시한 세계 최초의 비디오 버전 R1 모델
小编 ·

Video-R1: 홍콩중문대학과 칭화대학이 공동 출시한 세계 최초의 비디오 버전 R1 모델
Video-R1이란 무엇인가요?
Video-R1은 홍콩중문대학교와 칭화대학교가 공동으로推出的한 세계 최초의 비디오 버전 R1 모델로, 강화학습을 통해 다중모드 대형 언어 모델(MLLMs)의 비디오 추론 능력을 향상시킬 수 있습니다.
Video-R1 기능
시간 인지 추론: Video-R1은 T-GRPO 알고리즘을 도입하여 순서가 뒤바뀐 입력과 순서대로 입력된 비디오 프레임을 비교함으로써, 모델이 시간 정보를 활용하여 추론하도록 장려하고, 비디오 내 시계열 관계를 더 잘 이해할 수 있게 합니다.
혼합 데이터 학습: 고품질 비디오 추론 데이터 부족 문제를 해결하기 위해, Video-R1은 이미지와 비디오 혼합 데이터셋을 활용해 학습하며, 여기에는 Video-R1-COT-165k(SFT 콜드 스타트용)와 Video-R1-260k(RL 학습용)가 포함되어 모델이 정적 이미지 추론 능력에서 동적 비디오 추론으로 능력을 전환할 수 있게 합니다.
다양한 출력 유형: Video-R1은 객관식, 수치, OCR, 자유 형식, 회귀 등 다양한 답안 출력 유형을 지원합니다.
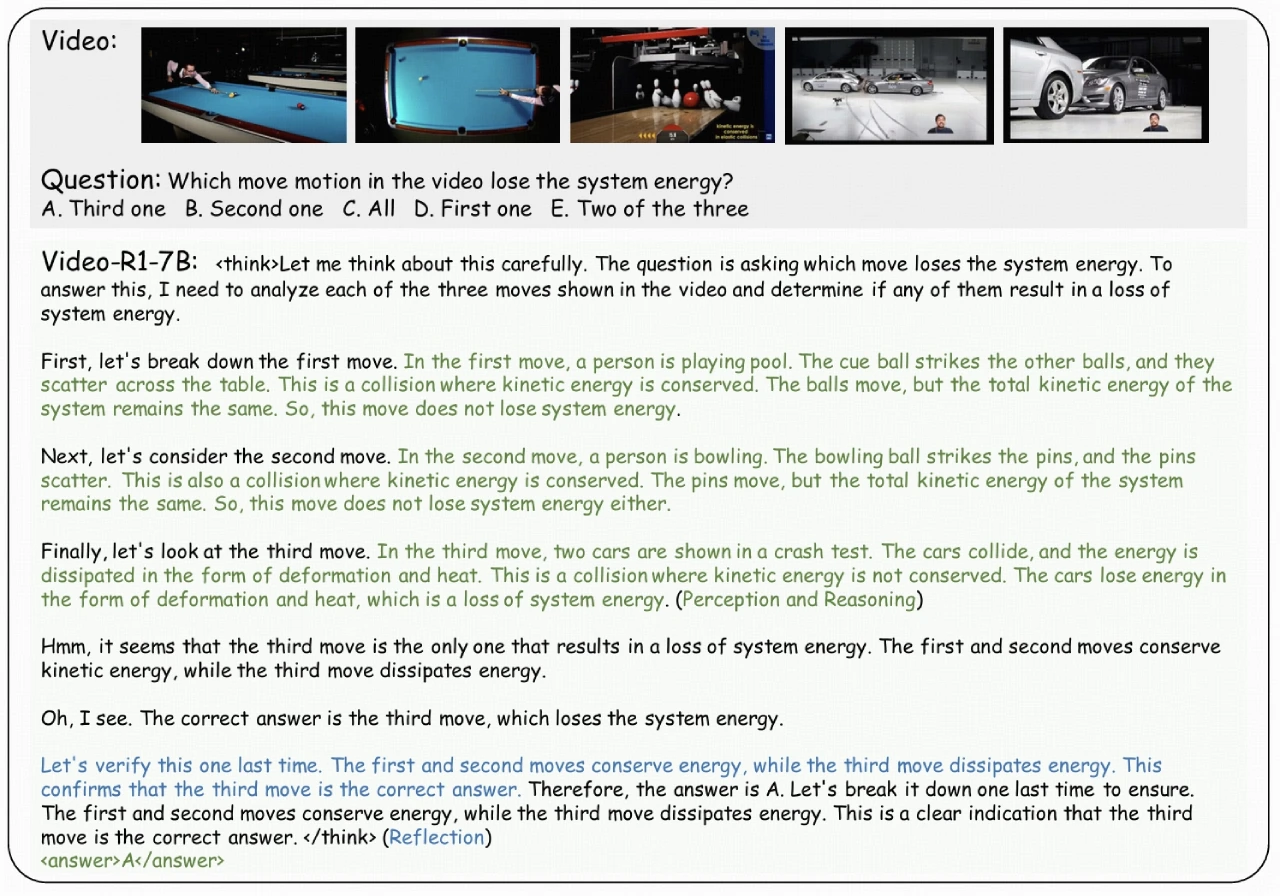
자기 성찰 추론 행동: 모델은 추론 과정에서 자기 성찰을 수행하고, 더 정확한 결론에 도달하기 위해 추론 방향을 조정합니다. 이러한 "아하 모먼트"는 모델이 내부 피드백 루프를 적극적으로 수행하고 있음을 보여줍니다.
Video-R1 기술
시간 인지 알고리즘 T-GRPO: 이 알고리즘은 모델의 시계열 이해 능력을 강화하여 이벤트 간의 인과 관계를 깊이 사고할 수 있게 합니다. 전통적인 GRPO 알고리즘과 비교하여, T-GRPO는 보상 메커니즘을 통해 시간 이해를 결합하여, 모델이 순서대로 입력된 데이터에서 더 높은 정답률을 보일 때만 보상을 받도록 합니다.
이미지-비디오 혼합 데이터셋: 연구팀은 Video-R1-COT-165k(이미지 중심)와 Video-R1-260k(고품질 비디오 중심)라는 두 개의 고품질 데이터셋을 구축하여 비디오 추론 데이터 부족 문제를 해결했습니다. 이러한 혼합 학습 방식은 모델을 단순히 "그림 보고 말하기"에서 "비디오 깊이 사고하기"로 진화시켜 진정한 다중모드 이해를 실현합니다.
강화학습 훈련 전략: Video-R1은 강화학습 훈련을 통해, 모델이 훈련 과정에서 점차 차선의 추론 패턴을 버리고 보다 효율적이고 논리적인 표현 경로를 형성하게 합니다.
Video-R1 응용
비디오 콘텐츠 분석: Video-R1은 비디오 내 동적 콘텐츠를 효율적으로 분석하고 이해할 수 있으며, 핵심 비디오 클립 자동 생성, 행동 인식, 스마트 태그 생성 등의 기능에 활용될 수 있습니다.
비디오 검색 및 추천: 심층 추론을 통해 Video-R1은 사용자 요구를 보다 정확히 이해하고, 사용자 관심사에 더 부합하는 비디오 콘텐츠 추천을 제공할 수 있습니다.
자율주행 시각 이해: 모델은 비디오 내 시계열 관계와 인과 논리를 이해할 수 있어, 자율주행 시스템이 도로 환경을 더 잘 인지하고 예측하는 데 도움이 됩니다.
비디오 모니터링 및 보안: Video-R1은 모니터링 비디오의 실시간 분석에 활용되어 이상 행동이나 이벤트를 빠르게 식별하고 공공 안전을 향상시킬 수 있습니다.
교육 및 훈련: 교육 분야에서 Video-R1은 지능형 튜터링 시스템에 활용될 수 있으며, 교육 비디오 콘텐츠를 분석하여 학생에게 개인화된 학습 조언을 제공합니다.
스마트 홈: 이 모델은 스마트 홈 시스템에 통합되어 비디오 분석을 통해 보다 지능적인 환경 인지 및 자동화 제어를 구현할 수 있습니다.
GitHub 주소:https://github.com/tulerfeng/Video-R1
논문:https://arxiv.org/abs/2503.21776









