
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
GPT-4.1 시리즈는 GPT-4o와 비교해 무엇이 개선되었는가? 주요 차이점 정리
小编 ·

GPT-4.1 시리즈는 GPT-4o와 비교해 무엇이 개선되었는가? 주요 차이점 정리
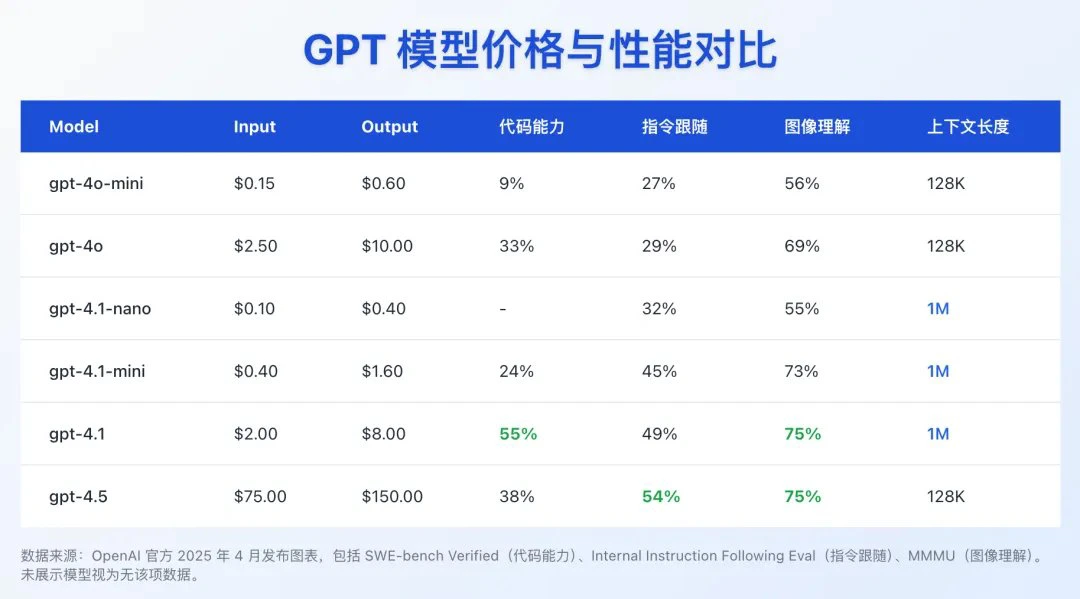
Openai가 어젯밤 GPT-4.1 시리즈를 출시했습니다. GPT-4.1은 4o를 대체하며 (OpenAI 체계 내에서) 가성비가 매우 높습니다. 1M의 초장문 컨텍스트를 갖추고 있으며 성능이 뛰어나고, 4.1 nano와 mini 버전은 가격이 저렴하여 대량의 장문 텍스트 작업을 처리하는 데 적합합니다. 코딩 능력은 GPT-4.5를 능가하지만 o1 등 추론 모델보다는 미치지 못합니다. GPT-4.1은 여러 면에서 GPT-4o에 비해明显的提升, 즉明显的 개선이 있으며, 주요 차이점은 다음과 같습니다:
1. 성능 향상
코딩 능력:
GPT-4.1: SWE-bench Verified 코딩 벤치마크 테스트에서 54.6%의 점수를 기록하여 GPT-4o 대비 21.4% 향상되었습니다.
GPT-4o: 동일한 테스트에서 33.2%의 점수를 기록했습니다.
개선점: GPT-4.1은 코드 저장소 처리, 작업 완료, 실행 가능하며 테스트를 통과하는 코드 생성에서 뛰어난 성능을 보입니다.
지시문 준수:
GPT-4.1: Scale의 MultiChallenge 벤치마크 테스트에서 38.3%의 점수를 기록하여 GPT-4o 대비 10.5% 향상되었습니다.
GPT-4o: 동일한 테스트에서 27.8%의 점수를 기록했습니다.
개선점: GPT-4.1은 복잡한 지시문 준수, 출력 형식 지정, 잘못된 동작 회피 등에서 더 나은 성능을 보입니다.
장문 텍스트 이해:
GPT-4.1: Video-MME 장문 텍스트 이해 벤치마크 테스트에서 72.0%의 점수를 기록하여 GPT-4o 대비 6.7% 향상되었습니다.
GPT-4o: 동일한 테스트에서 65.3%의 점수를 기록했습니다.
개선점: GPT-4.1은 긴 동영상(자막 없음) 및 긴 문서를 처리할 때 핵심 정보를 더 잘 이해하고 추출할 수 있습니다.
2. 컨텍스트 윈도우
GPT-4.1: 100만 토큰의 컨텍스트 윈도우를 지원하여 GPT-4o의 12.8만 토큰보다 크게 확장되었습니다.
GPT-4o: 12.8만 토큰의 컨텍스트 윈도우를 지원합니다.
개선점: GPT-4.1은 더 큰 코드베이스, 다중 문서 작업 및 장문 텍스트를 처리할 수 있으며, 법률, 프로그래밍, 고객 지원 등 다양한 분야에 적용할 수 있습니다.
3. 모델 효율성
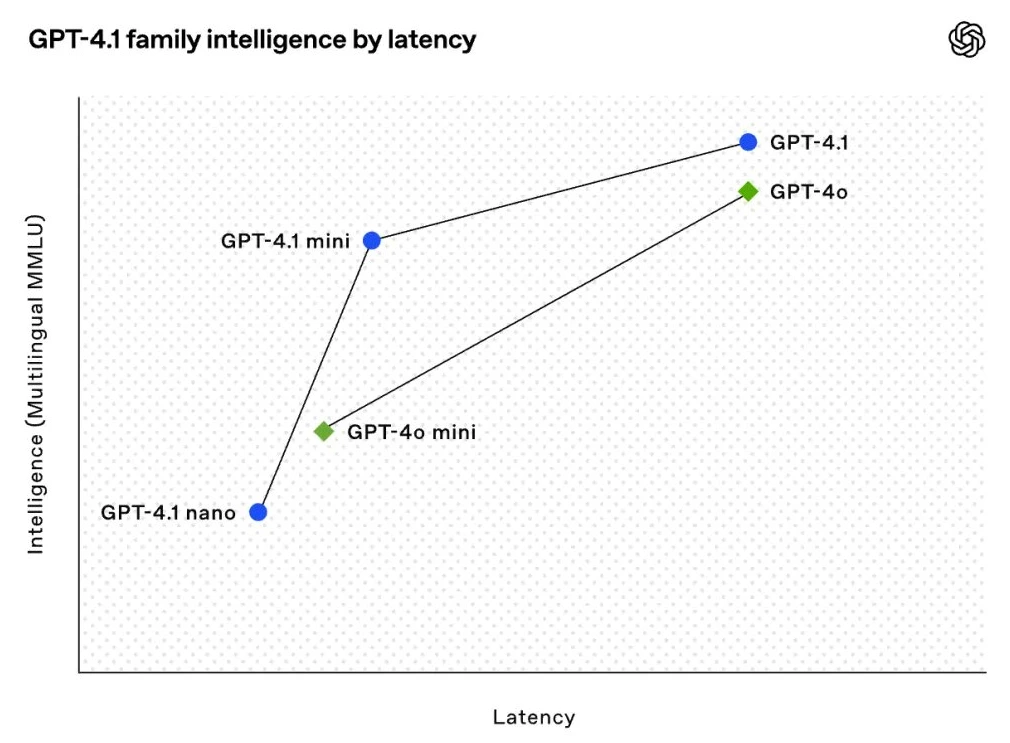
GPT-4.1: 추론 효율성이 크게 향상되어 지연 시간이 줄고 비용이 낮아졌습니다.
GPT-4.1 mini: 지연 시간이 거의 절반으로 줄어들고 비용이 83% 감소했습니다.
GPT-4.1 nano: 가장 빠른 모델로 지연 시간이 매우 낮아 저지연 요구 사항이 있는 작업에 적합합니다.
GPT-4o: 특히 대규모 컨텍스트를 처리할 때 추론 효율성이 상대적으로 낮습니다.
4. 이미지 이해
GPT-4.1: 특히 멀티모달 작업에서 이미지 이해 능력이 뛰어나습니다.
GPT-4.1 mini: MMMU 이미지 이해 벤치마크 테스트에서 72.7%의 점수를 기록하여 GPT-4o의 68.7%보다 우수한 성능을 보입니다.
GPT-4o: 이미지 이해 작업에서 성능이 상대적으로 약합니다.
5. 비용
GPT-4.1: 입력 토큰 100만 개당 $2.00, 출력 토큰 100만 개당 $8.00의 비용이 청구됩니다.
GPT-4.1 mini: 입력 토큰 100만 개당 $0.40, 출력 토큰 100만 개당 $1.60의 비용이 청구됩니다.
GPT-4.1 nano: 입력 토큰 100만 개당 $0.10, 출력 토큰 100만 개당 $0.40의 비용이 청구됩니다.
GPT-4o: 입력 토큰 100만 개당 비용이 더 높으며 구체적인 수치는 명시되지 않았으나, GPT-4.1 시리즈가 비용 면에서 더 유리합니다.
6. 활용 시나리오
GPT-4.1: 강력한 컴퓨팅 능력과 복잡한 작업 처리가 필요한 시나리오에 적합하며, 예를 들어 전문 소프트웨어 개발, 법률 문서 분석, 대규모 데이터 처리 등이 있습니다.
GPT-4.1 mini: 일반 개인용 컴퓨터, 소형 서버 등 자원이 제한된 환경에서 사용하기에 적합합니다.
GPT-4.1 nano: 주로 모바일 및 임베디드 장치를 대상으로 하며, 빠른 텍스트 분류, 자동 완성 등 응답 속도에 대한 요구가 높고 자원이 제한된 시나리오에 적합합니다.
GPT-4o: 일반적인 용도에 적합하지만, 대규모 컨텍스트 및 복잡한 작업을 처리할 때 성능이 상대적으로 약합니다.
더 많은 테스트 지표는 OpenAI 블로그를 참고하세요: https://openai.com/index/gpt-4-1/.









