
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
WeClone: WeChat 대화 기록으로 LLM을 파인튜닝해 개인 디지털 트윈 만들기
小编 ·

WeClone: WeChat 대화 기록으로 LLM을 파인튜닝해 개인 디지털 트윈 만들기
WeClone이란 무엇인가?
WeClone은 웨이신(微信) 채팅 기록으로 LLM을 미세 조정하고, 웨이신 음성 메시지와 대규모 모델을 결합하여 고품질의 음성 클로닝을 구현하며, 최종적으로 웨이신 봇에 연결하여 개인의 AI 디지털 분신을 구현하는 것을 목표로 하는 오픈소스 프로젝트입니다.
WeClone 기능
웨이신 채팅 기록으로 LLM 미세 조정: 사용자의 웨이신 채팅 기록을 통해 언어 모델을 미세 조정하여 개인의 언어 스타일과 습관에 더 잘 맞도록 합니다.
고품질 음성 클로닝: 웨이신 음성 메시지와 0.5B 대규모 모델을 결합하여 고품질의 음성 클로닝을 구현합니다.
웨이신 봇 연결: 미세 조정된 모델을 웨이신 봇에 연결하여 자동 응답 등의 기능을 구현하고, 개인의 디지털 분신을 형성합니다.
WeClone 특징
하드웨어 요구 사항: 기본적으로 chatglm3-6b 모델을 사용하며, LoRA 방법 미세 조정에는 약 16GB의 VRAM이 필요합니다. 다른 모델과 방법은自行 구성할 수 있습니다.
소프트웨어 요구 사항: Python 3.10 사용을 권장하며, 특정 버전의 PyTorch, Transformers 등의 라이브러리가 필요합니다.
환경 구축: Git으로 프로젝트를 클론한 후 Conda를 사용하여 환경을 생성하고 의존성을 설치합니다.
데이터 준비: PyWxDump를 사용하여 웨이신 채팅 기록을 추출하고 CSV 형식으로 내보냅니다.
데이터 전처리: 민감한 정보를 제거하며, 다양한 데이터 처리 방식을 지원합니다.
모델 다운로드: Hugging Face 또는 魔搭 커뮤니티에서 ChatGLM3 모델을 다운로드할 것을 권장합니다.
모델 미세 조정: settings.json 구성 파일의 매개변수를 수정하여 단일 또는 다중 GPU 학습을 수행합니다.
추론 및 테스트: 브라우저 데모와 API 추론 기능을 제공하며, 일반적인 채팅 문제 테스트를 지원합니다.
웨이신 봇 배포: QR 코드 로그인을 통해 1대1 채팅 및 그룹 채팅에서 봇 상호작용을 지원합니다.
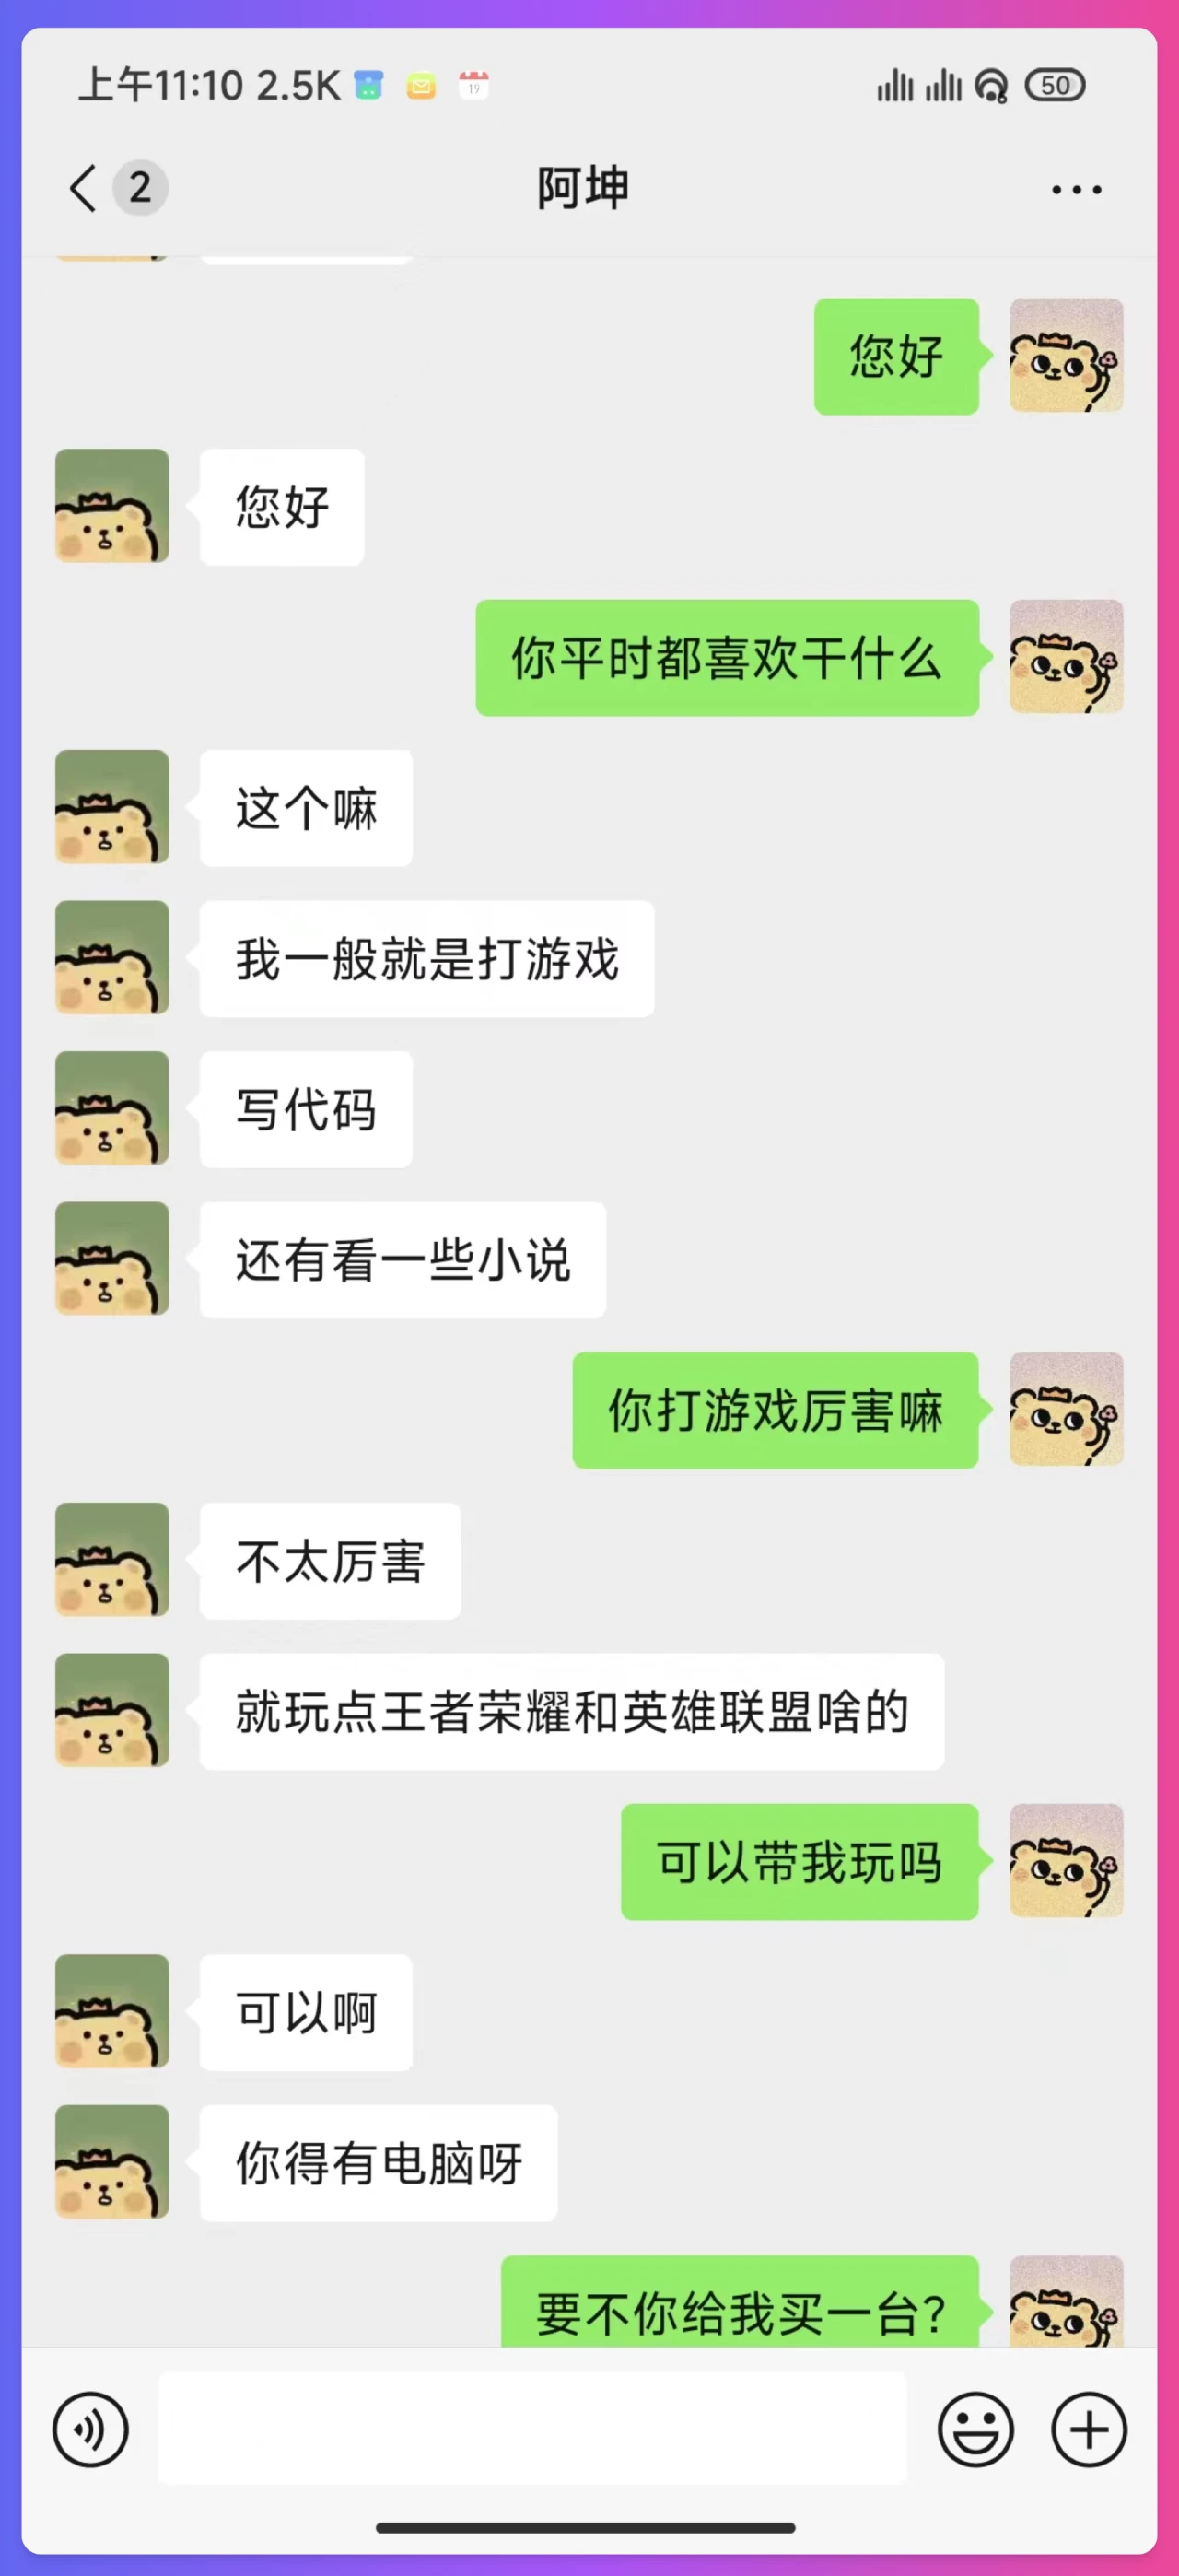
WeClone 사용 단계
환경 구축
프로젝트 클론: 터미널에서 다음 명령을 실행하여 WeClone 프로젝트를 로컬로 클론합니다.
git clone https://github.com/xming521/WeClone.git
가상 환경 생성 및 활성화: Conda를 사용하여 새로운 Python 환경을 생성하고 활성화합니다.
conda create -n weclone python=3.10
conda activate weclone
의존성 설치: 프로젝트 디렉터리로 이동하여 프로젝트에 필요한 의존성 패키지를 설치합니다.
cd WeClone
pip install -r requirements.txt
데이터 준비
웨이신 채팅 기록 추출: PyWxDump 소프트웨어를 사용하여 웨이신 채팅 기록을 추출합니다. 해당 소프트웨어를 다운로드하고 설치한 후 데이터베이스 복호화를 진행하고, 채팅 백업을 클릭하여 내보내기 유형을 CSV로 선택합니다. 여러 연락처 또는 그룹 채팅의 채팅 기록을 내보낼 수 있습니다.
데이터 배치: wxdump_tmp/export 위치에 내보낸 csv 폴더를 프로젝트 디렉터리 아래의 ./data 디렉터리에 배치합니다. 즉, 여러 사람의 채팅 기록 폴더를 함께 ./data/csv에 둡니다. 예시 데이터는 data/example_chat.csv에 있습니다.
데이터 전처리
민감한 정보 제거: 프로젝트는 기본적으로 데이터에서 휴대전화 번호, 신분증 번호, 이메일, 웹사이트 등의 민감한 정보를 제거합니다. 또한 차단어 사전인 blocked_words가 제공되며, 필터링이 필요한 단어나 문장을自行 추가할 수 있고, 프로그램은 기본적으로 차단어가 포함된 전체 문장을 제거합니다.
데이터 형식 처리: ./make_dataset/csv_to_json.py 스크립트를 실행하여 데이터를 처리합니다. 동일인이 연속으로 여러 문장을 답하는 경우, 다음 세 가지 처리 방식 중 하나를 선택할 수 있습니다.
csv_to_json.py 사용: 여러 문장의 답변을 쉼표로 연결합니다.
csv_to_json-单句回答.py 사용(더 이상 사용되지 않음): 가장 긴 답변 하나만 최종 데이터로 선택합니다.
csv_to_json-单句多轮.py 사용: 여러 문장의 답변을 프롬프트의 'history'에 넣습니다.
모델 다운로드
Hugging Face 우선 사용: Hugging Face에서 ChatGLM3 모델을 다운로드합니다. Hugging Face 모델 다운로드 중 문제가 발생하면 魔搭 커뮤니티의 모델을 사용할 수 있습니다.
魔搭 커뮤니티 사용: 魔搭 커뮤니티의 모델을 사용하기로 선택한 경우, 먼저 다음 명령을 실행하여 魔搭 커뮤니티 모델을 사용해야 합니다.
export USE_MODELSCOPE_HUB=1 # Windows uses `set USE_MODELSCOPE_HUB=1`
git lfs install
git clone https://www.modelscope.cn/ZhipuAI/chatglm3-6b.git
주의: 魔搭 커뮤니티의 modeling_chatglm.py 파일은 Hugging Face의 것으로 교체해야 합니다.
매개변수 구성 및 모델 미세 조정
구성 파일 수정: 학습 및 추론 관련 구성은 settings.json 파일에 통합되어 있습니다. 필요에 따라 다음 매개변수를 수정할 수 있습니다.
per_device_train_batch_size 및 gradient_accumulation_steps를 수정하여 VRAM 사용량을 조정합니다.
데이터셋의 수량과 품질에 따라 num_train_epochs, lora_rank, lora_dropout 등의 매개변수를 수정합니다.
(선택 사항) settings.json을 수정하여 로컬에서 다운로드한 다른 모델을 선택합니다.
단일 GPU 학습: 다음 명령을 실행하여 sft 단계 미세 조정을 수행합니다.
python src/train_sft.py
저자는 자신의 loss가 약 3.5 정도까지만 떨어졌다고 말하며, 너무 많이 떨어지면 과적합이 발생할 수 있다고 했습니다. 약 2만 개의 통합된 유효 데이터를 사용했다고 합니다.
다중 GPU 학습: 여러 GPU가 있는 경우 deepspeed를 사용하여 다중 GPU 학습을 수행할 수 있습니다. 먼저 deepspeed를 설치한 후 다음 명령을 실행합니다.
pip install deepspeed
deepspeed --num_gpus=사용할 GPU 수 src/train_sft.py
추론 및 테스트
브라우저 데모를 사용한 간단한 추론: 프로젝트에서 브라우저 데모를 제공하며, 간단한 추론 테스트를 수행할 수 있습니다.
API를 사용한 추론: 다음 명령을 실행하여 API 서비스를 시작합니다.
python ./src/api_service.py
일반적인 채팅 문제로 테스트: 다음 명령을 실행하여 일반적인 채팅 문제 테스트를 수행합니다.
python ./src/test_model.py
웨이신 채팅 봇 배포
API 서비스 시작: 먼저 다음 명령을 실행하여 API 서비스를 시작합니다.
python ./src/api_service.py
웨이신 봇 스크립트 실행: 다음 명령을 실행하여 웨이신 채팅 봇을 시작합니다.
python ./src/wechat_bot/main.py
기본적으로 터미널에 QR 코드가 표시되며, 스캔하여 로그인하면 사용할 수 있습니다. 1대1 채팅 또는 그룹 채팅에서 봇을 @하여 사용할 수 있습니다.
주의 사항: 웨이신은 계정이 정지될 위험이 있으므로, 부계정을 사용할 것을 권장하며, 반드시 은행카드를 연동해야 사용할 수 있습니다.
eferrer noopener">음성 클로닝 모듈(WeClone-audio)
Spark-TTS 방안(권장):
관련 모듈을 가져옵니다.
import SparkTTS
from SparkTTS import SparkTTS
모델을 초기화합니다.
model = SparkTTS("WeClone-audio/pretrained_models/Spark-TTS-0.5B", "cuda")음성 클로닝 추론을 수행합니다.
with torch.no_grad():
wav = model.inference(
text="要生成的文本内容",
prompt_speech_path="示例音频路径",
prompt_text="示例音频对应的文本",
)
Llasa 방안:
관련 모듈을 가져옵니다.
from text_to_speech import TextToSpeech
초기화하고 추론을 수행합니다.
tts = TextToSpeech(sample_audio_path, sample_audio_text)
result = tts.infer("要生成的文本内容")
Github 주소:https://github.com/xming521/WeClone









