
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
PDF Document Layout Analysis: Docker 기반 PDF 문서 레이아웃 분석 및 PDF OCR 서비스
小编 ·

PDF Document Layout Analysis: Docker 기반 PDF 문서 레이아웃 분석 및 PDF OCR 서비스
PDF Document Layout Analysis란 무엇인가요?
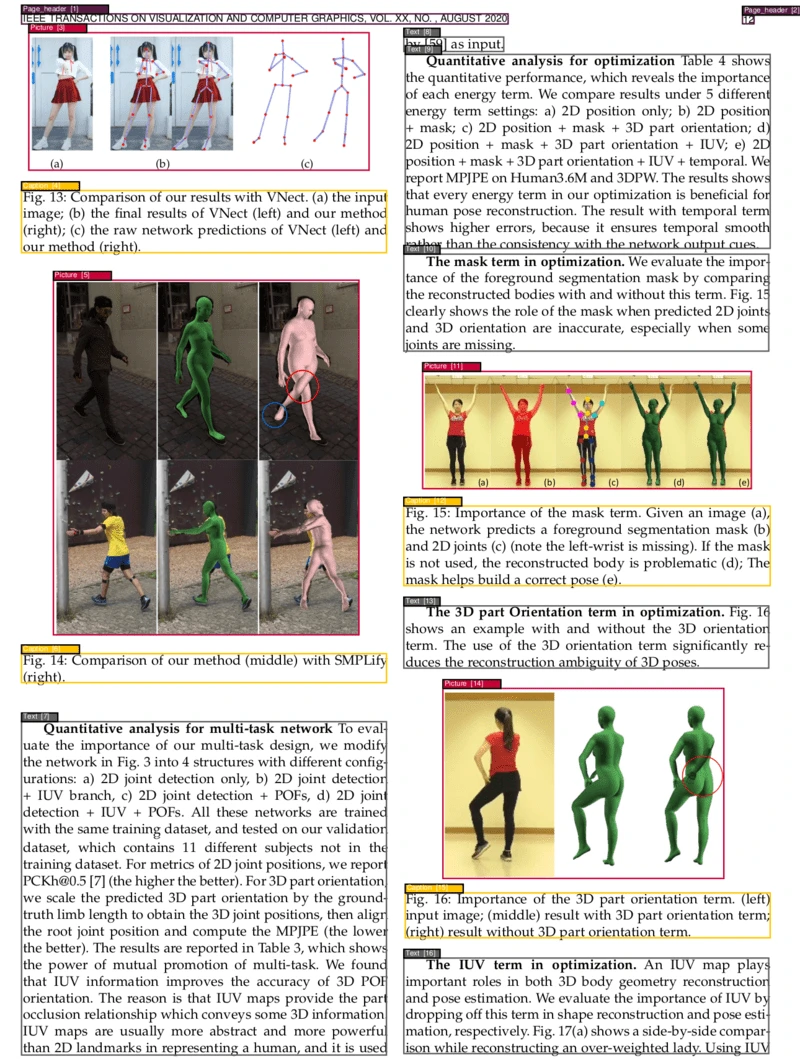
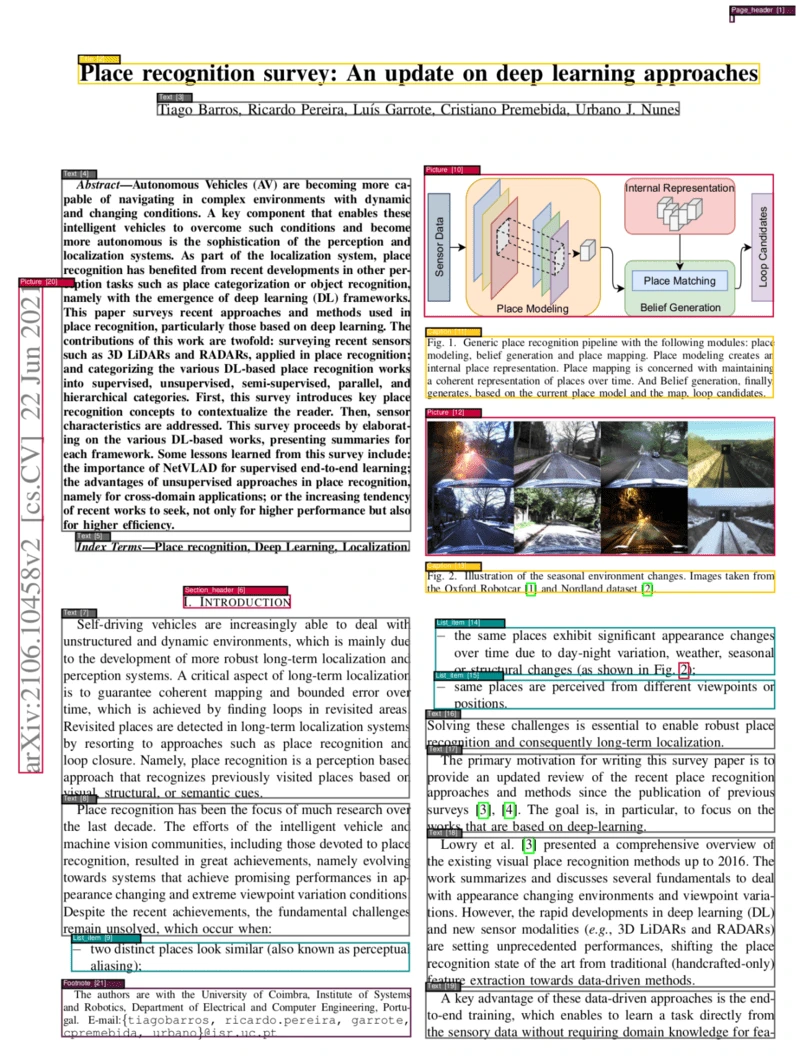
PDF Document Layout Analysis는 PDF 문서의 레이아웃을 분석하기 위한 Docker 기반 서비스입니다. PDF 페이지의 다양한 부분을 분할하고 분류하여 PDF 페이지 내의 텍스트, 제목, 이미지, 표 등의 요소를 정확하게 자동으로 식별하고 이러한 요소의 올바른 순서를 결정할 수 있습니다.
PDF Document Layout Analysis 기능 특징
1. OCR 기능
다국어 지원: 다양한 언어의 OCR 기능을 지원하며, 사용자는 언어 매개변수를 지정하여 다양한 언어의 PDF 문서를 처리할 수 있습니다.
텍스트 추출: PDF 내의 이미지 또는 검색할 수 없는 텍스트를 검색 가능한 텍스트 형식으로 변환하여 후속 처리 및 분석을 용이하게 합니다.
2. 페이지 분할 및 분류
다양한 요소 식별: PDF 페이지 내의 다양한 요소를 식별하고 분류할 수 있습니다.
텍스트: 일반 텍스트 내용.
제목: 문서의 제목 및 소제목.
이미지: 페이지 내의 이미지.
표: 표 내용.
수식: 수학 공식, LaTeX 형식 출력을 지원.
목록 항목: 순서가 있는 목록 또는 순서가 없는 목록.
머리글과 바닥글: 페이지의 머리글과 바닥글.
각주: 문서 내의 각주.
기타: 이미지 캡션, 표 제목 등.
정확한 분류:先进的视觉模型(如 Vision Grid Transformer - VGT) 및 기계 학습 모델(如 LightGBM)을 사용하여 고정밀 분류 결과를 보장합니다.
3. 요소 정렬
논리적 순서: 페이지 레이아웃과 요소 유형에 따라 요소의 논리적 순서를 자동으로 결정하여 출력 결과가 문서의 읽기 순서와 일치하도록 보장합니다.
맞춤 정렬 규칙: Poppler의 초기 읽기 순서와 단락 유형을 결합하여 요소를 정렬하여 출력의 논리성과 일관성을 보장합니다.
4. 시각적 출력
시각적 PDF: 분석 결과를 새로운 PDF 파일로 시각화하는 것을 지원하며, 사용자는 분할 및 분류 결과를 직관적으로 확인할 수 있습니다.
주석 기능: 시각적 출력에서 다양한 유형의 요소가 다양한 색상이나 스타일로 주석 처리되어 구분하기 쉽습니다.
5. 표 및 수식 추출
표 추출: 표를 Markdown, LaTeX 또는 HTML 등 다양한 형식으로 추출하는 것을 지원하여 추가 처리 및 분석을 용이하게 합니다.
수식 추출: 수식은 LaTeX 형식으로 출력되어 학술 및 엔지니어링 문서에서 사용하기 편리합니다.
PDF Document Layout Analysis 활용 시나리오
학술 연구: 연구 논문에서 텍스트, 차트, 표 및 참고 문헌을 추출 및 정리하여 문헌 검토 및 데이터 분석을 용이하게 합니다.
법률 문서 분석: 법률 파일, 계약 및 사례 파일을 분석 및 구조화합니다.
비즈니스 보고서: 재무 데이터, 차트 및 핵심 지표를 자동으로 추출하여 통찰력 및 요약 생성을 용이하게 합니다.
아카이브 및 디지털화: 역사적 문서, 원고 및 아카이브를 디지털화 및 분류하여 검색하기 쉬운 형식으로 보존합니다.
출판 및 미디어: 원고, 기사 및 보고서의 내용을 정리 및 형식화하여 일관성과 품질을 보장합니다.
빠른 시작
서비스 실행: GPU 및 비 GPU 모드를 지원합니다.
OCR 기능: 다양한 언어를 지원하며, curl 명령을 통해 호출됩니다.
분할 결과 가져오기: curl 명령을 통해 PDF 파일을 보내고 분할된 결과를 가져옵니다.
서비스 중지: 서버 중지 명령을 제공합니다.
종속성 및 요구 사항
Docker Desktop: Docker Desktop 4.25.0 이상을 설치해야 합니다.
GPU 지원: GPU 가속이 필요한 경우 해당 GPU 지원 소프트웨어를 설치해야 합니다.
하드웨어 요구 사항: 최소 2GB 메모리가 필요하며, GPU를 사용하는 경우 5GB GPU 메모리가 필요합니다.
모델
시각 모델(Vision Grid Transformer - VGT): 기본 모델로, 알리바바 연구팀에서 훈련시켰으며, 더 복잡한 레이아웃 분석을 지원하지만 더 많은 리소스가 필요합니다.
LightGBM 모델: 비시각 모델로, Poppler가 추출한 XML 정보를 사용하여 분류 및 분할을 수행하며, 속도가 더 빠르고 리소스 점유가 더 적습니다.
데이터
훈련 데이터: DocLayNet 데이터 세트를 사용하며, 제목, 각주, 수식, 목록 항목 등 11가지 범주를 포함합니다.
사용 방법
기본 명령: curl 명령을 통해 PDF 파일을 보내고 시각 모델 또는 비시각 모델 사용을 선택합니다.
시각적 출력: 분석 결과를 PDF 파일로 시각화하는 것을 지원합니다.
표 및 수식 추출: 표 및 수식을 다양한 형식(예: LaTeX, Markdown)으로 추출하는 것을 지원합니다.
출력 순서
정렬 규칙: Poppler의 초기 읽기 순서와 단락 유형을 기반으로 정렬하여 출력의 논리적 순서를 보장합니다.
성능 및 속도
성능: VGT 모델은 PubLayNet 데이터 세트에서 뛰어난 성능을 보이며, 평균 정확도가 96%를 초과합니다.
속도: 비시각 모델은 CPU에서 페이지당 0.42초, 시각 모델은 GPU에서 1.75초, CPU에서 13.5초로 처리됩니다.
관련 링크
GitHub:https://github.com/huridocs/pdf-document-layout-analysis
DockerHub:https://hub.docker.com/r/huridocs/pdf-document-layout-analysis









