
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
Crawl4AI: 오픈소스 AI 친화적 웹 크롤러 및 스크래퍼
小编 ·

Crawl4AI: 오픈소스 AI 친화적 웹 크롤러 및 스크래퍼
Crawl4ai란 무엇인가요?
Crawl4AI는 오픈 소스 AI 친화형 웹 크롤러 및 스크래퍼로, GitHub에서 인기 있는 프로젝트이며, LLM, AI 에이전트 및 데이터 파이프라인을 위해 설계되었습니다. 빠르고 유연한 웹 데이터 추출을 지원하며, LLM에 적합한 Markdown 형식의 데이터를 생성하고, 구조화된 데이터 추출, 브라우저 통합, 동적 콘텐츠 처리 등의 기능을 제공합니다.
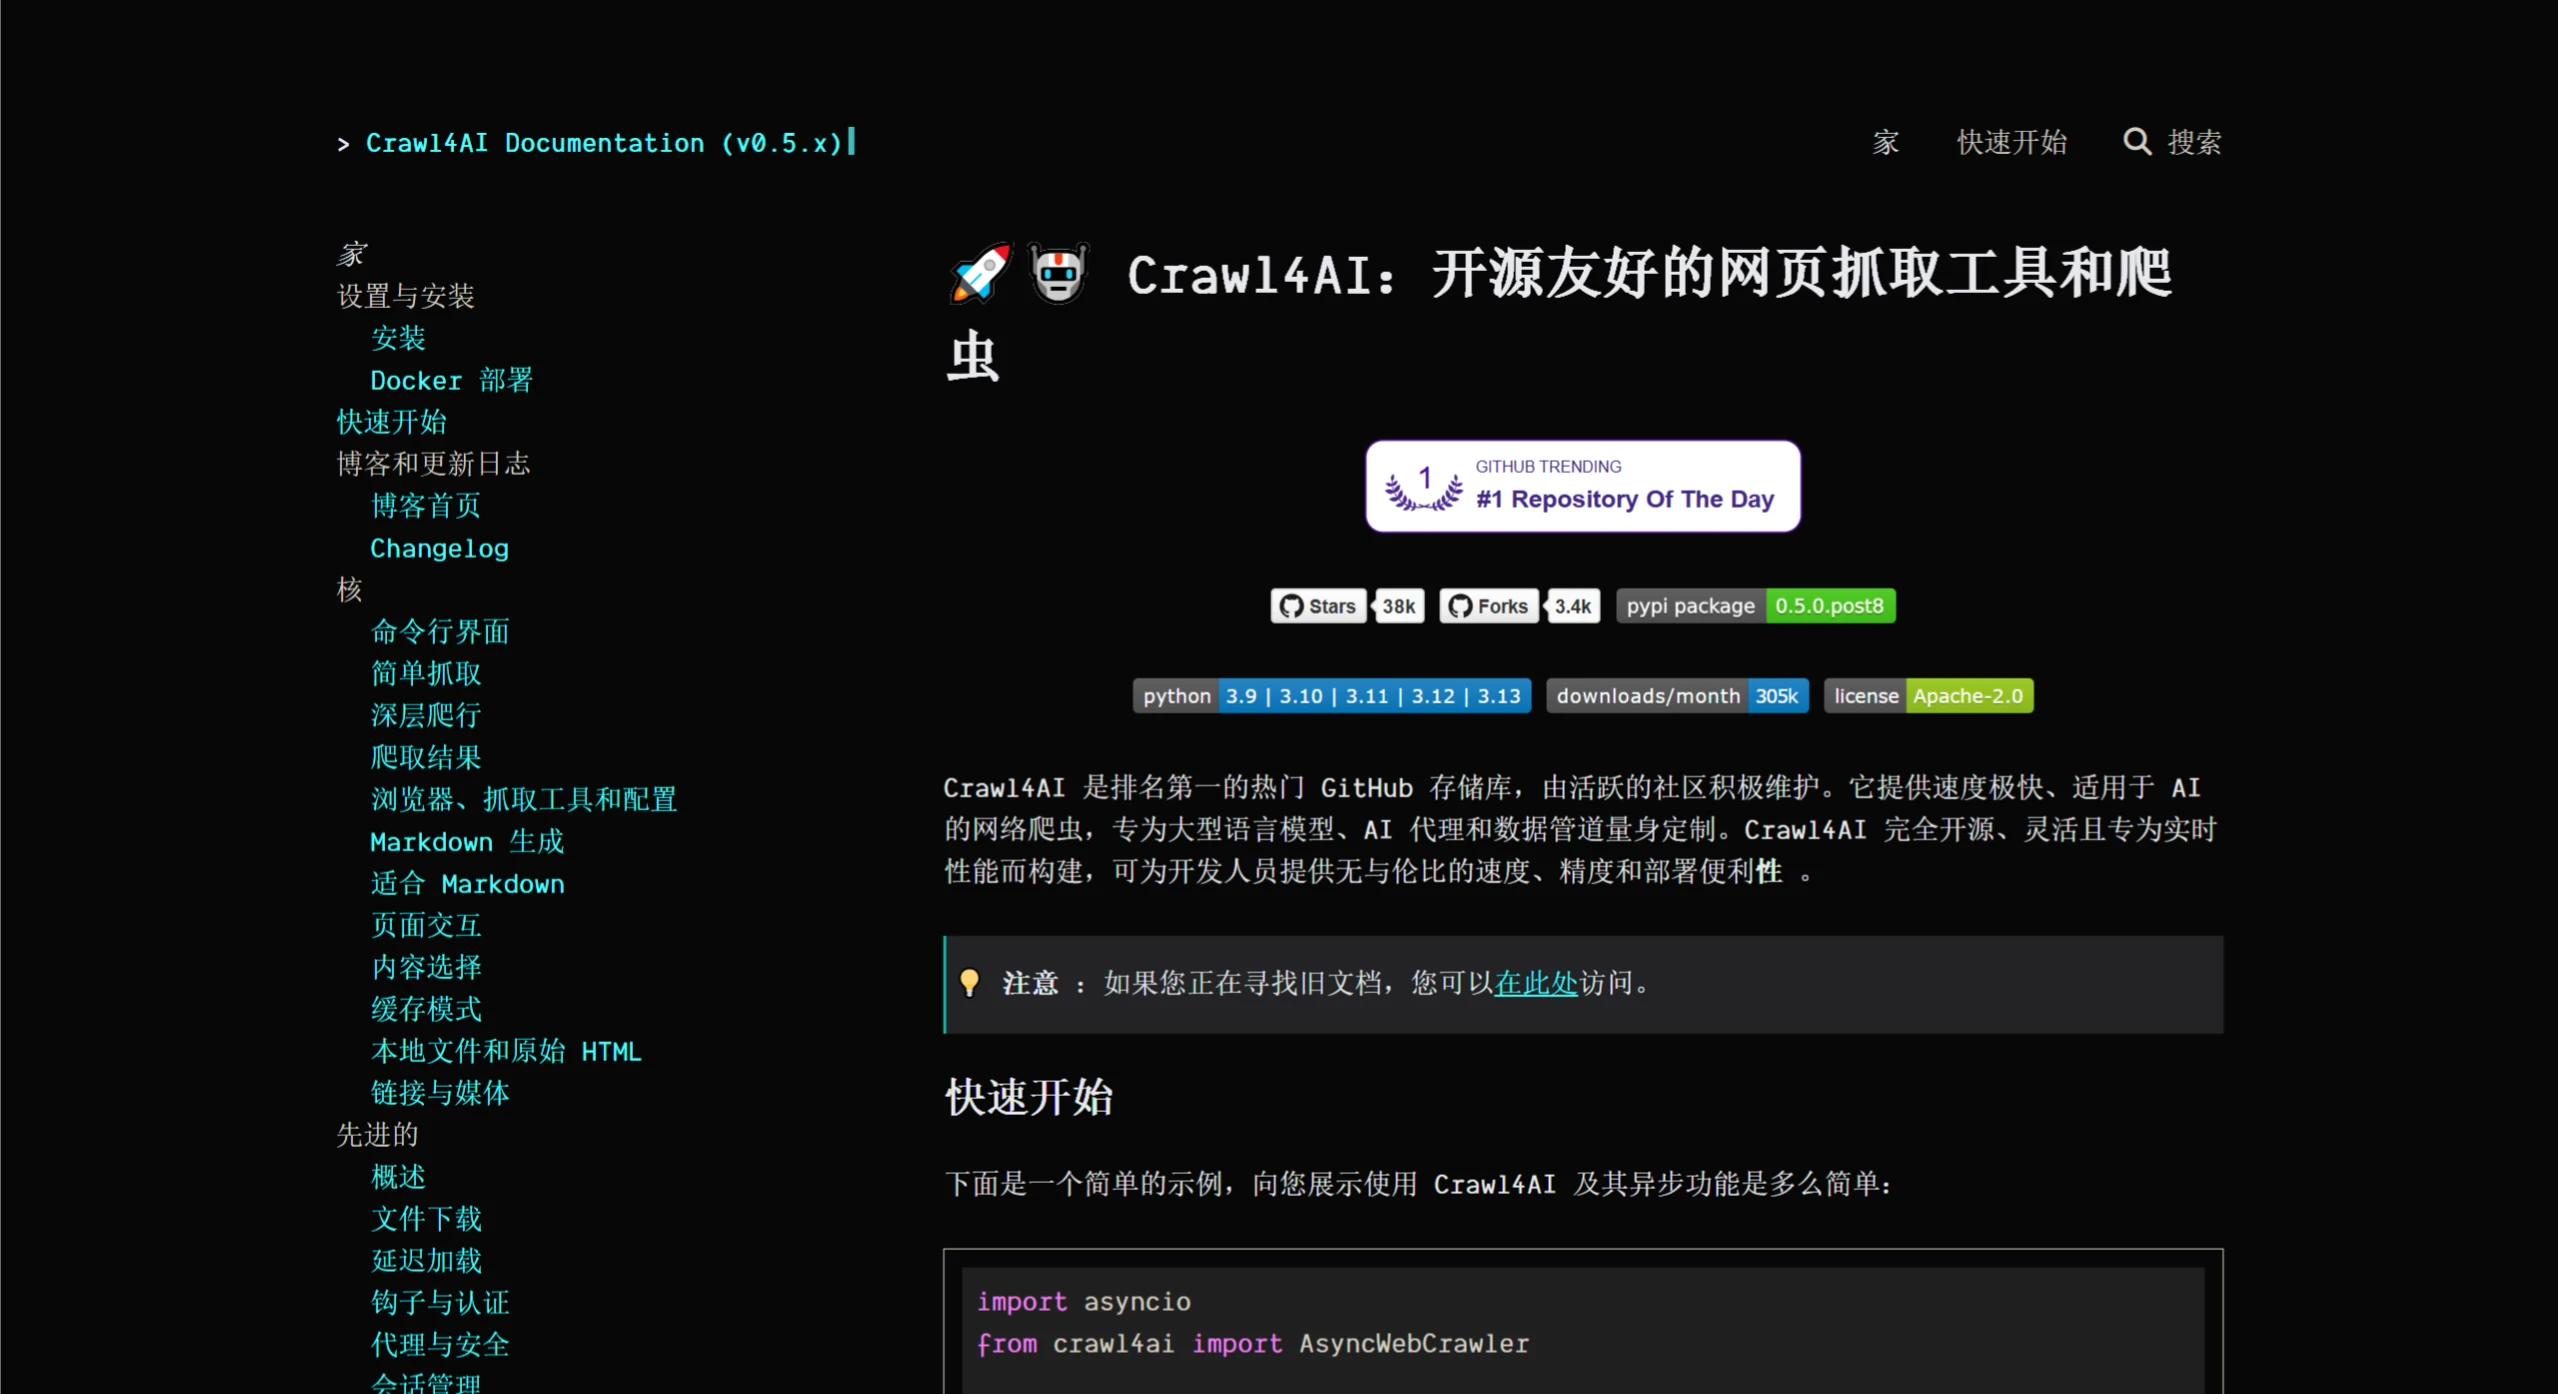
Crawl4AI 기능
Markdown 생성
깔끔한 Markdown: 구조가 명확하고 형식이 정확한 Markdown 텍스트를 생성합니다.
적응형 Markdown: 휴리스틱 알고리즘을 기반으로 노이즈와 관련 없는 내용을 필터링하여 AI 처리에 적합한 Markdown을 생성합니다.
인용 및 참고: 페이지 링크를 번호가 매겨진 참고 목록으로 변환하고 명확한 인용을 제공합니다.
사용자 지정 전략: 특정 요구 사항을 충족하기 위해 사용자가 자신만의 Markdown 생성 전략을 만들 수 있습니다.
BM25 알고리즘: BM25 알고리즘을 기반으로 내용을 필터링하여 핵심 정보를 추출하고 관련 없는 내용을 제거합니다.
구조화된 데이터 추출
LLM 기반 추출: 구조화된 데이터 추출을 위해 모든 LLM(오픈 소스 및 독점)을 지원합니다.
청킹 전략: 주제, 정규식, 문장 수준 기반의 청킹 처리를 구현합니다.
코사인 유사도: 사용자 쿼리를 기반으로 관련 콘텐츠 블록을 찾아 의미적 추출을 구현합니다.
CSS 기반 추출: XPath 및 CSS 선택자를 사용하여 빠른 패턴 기반 데이터 추출을 수행합니다.
스키마 정의: 사용자 지정 스키마를 정의하여 반복되는 패턴에서 구조화된 JSON 데이터를 추출합니다.
브라우저 통합
호스팅 브라우저: 사용자의 자체 브라우저를 사용하여 크롤러로 감지되는 것을 방지합니다.
원격 브라우저 제어: Chrome 개발자 도구 프로토콜을 통해 원격 브라우저에 연결하여 대규모 데이터 추출을 수행합니다.
브라우저 프로필: 인증 상태, 쿠키 및 설정을 저장하는 영구 프로필을 생성 및 관리합니다.
세션 관리: 브라우저 상태를 유지 및 재사용하여 다단계 크롤링을 지원합니다.
프록시 지원: 인증이 필요한 프록시에 원활하게 연결하여 안전한 액세스를 보장합니다.
완전한 브라우저 제어: 요청 헤더, 쿠키, 사용자 에이전트 등을 수정하여 크롤링 설정을 사용자 지정합니다.
다중 브라우저 지원: Chromium, Firefox 및 WebKit과 호환됩니다.
동적 뷰포트 조정: 브라우저 뷰포트를 페이지 콘텐츠에 맞게 자동으로 조정하여 완전한 렌더링을 보장하고 모든 요소를 캡처합니다.
크롤링 및 스크래핑
미디어 지원: 이미지, 오디오, 비디오 및 반응형 이미지 형식(srcset, picture 등)을 추출합니다.
동적 크롤링: JavaScript를 실행하고 비동기 또는 동기 콘텐츠를 기다려 동적 콘텐츠를 추출합니다.
스크린샷: 디버깅 또는 분석을 위해 크롤링 과정에서 페이지 스크린샷을 캡처합니다.
원시 데이터 크롤링: 원시 HTML(raw:) 또는 로컬 파일(file://)을 직접 처리합니다.
포괄적인 링크 추출: 내부 링크, 외부 링크 및 임베디드 iframe 콘텐츠를 추출합니다.
사용자 지정 훅: 각 단계에서 훅을 정의하여 크롤링 동작을 사용자 지정합니다.
캐싱: 데이터를 캐싱하여 속도를 높이고 중복 스크래핑을 방지합니다.
메타데이터 추출: 웹 페이지에서 구조화된 메타데이터를 추출합니다.
iframe 콘텐츠 추출: 임베디드 iframe 콘텐츠를 원활하게 추출합니다.
지연 로딩 처리: 이미지가 완전히 로드될 때까지 기다려 지연 로딩으로 인해 콘텐츠가 누락되지 않도록 합니다.
전체 페이지 스캔: 무한 스크롤 페이지에 적합하도록 시뮬레이션된 스크롤을 통해 모든 동적 콘텐츠를 로드하고 캡처합니다.
기타 기능
스텔스 모드: 실제 사용자 행동을 모방하여 크롤러로 감지되는 것을 피합니다.
태그 기반 콘텐츠 추출: 사용자 지정 태그, 제목 또는 메타데이터에 따라 크롤링 콘텐츠를 세분화합니다.
링크 분석: 모든 링크를 추출 및 분석하여 상세한 데이터 탐색을 수행합니다.
오류 처리: 강력한 오류 관리로 원활한 실행을 보장합니다.
CORS 및 정적 서비스: 파일 시스템 기반 캐싱 및 교차 출처 요청을 지원합니다.
명확한 문서: 간소화된 입문 및 고급 사용 안내서를 제공합니다.
Crawl4AI의 장점
LLM 맞춤 설계: RAG 및 파인튜닝 애플리케이션에 적합한 지능적이고 간결한 Markdown을 생성합니다.
초고속 성능: 실시간, 비용 효율적인 성능으로 기존 방법보다 6배 빠릅니다.
유연한 브라우저 제어: 세션 관리, 프록시 지원 및 사용자 지정 훅을 제공하여 원활한 데이터 액세스를 보장합니다.
휴리스틱 지능: 고급 알고리즘을 사용하여 콘텐츠를 효율적으로 추출하여 비용이 많이 드는 모델에 대한 의존도를 줄입니다.
오픈 소스 및 배포 가능: 완전한 오픈 소스이며 API 키가 필요 없고 Docker 및 클라우드 통합을 지원합니다.
Crawl4AI 활용 시나리오
AI 및 머신 러닝: LLM에 고품질의 학습 데이터를 제공하여 자연어 처리 및 지식 그래프 구축을 지원합니다.
데이터 파이프라인: 효율적인 데이터 파이프라인을 구축하여 웹 데이터를 실시간으로 추출 및 처리합니다.
콘텐츠 추출: 콘텐츠 관리 시스템을 위해 웹 페이지에서 텍스트, 이미지, 비디오 등 멀티미디어 콘텐츠를 추출합니다.
학술 연구: 연구자들이 웹 페이지에서 논문 및 연구 데이터를 추출하여 학술 연구 활동을 지원하도록 돕습니다.
비즈니스 인텔리전스: 시장 데이터, 제품 정보 및 사용자 리뷰를 추출하여 비즈니스 의사 결정을 지원합니다.
뉴스 미디어: 뉴스 콘텐츠를 빠르게 스크래핑하여 뉴스 집계 및 콘텐츠 분석을 지원합니다.
Crawl4AI 설치 및 사용 튜토리얼
설치
기본 설치:
pip install crawl4ai
crawl4ai-setup  # 브라우저 설정
프리릴리스 버전 설치:
pip install crawl4ai --pre
개발 설치:
git clone https://github.com/unclecode/crawl4ai.git
cd crawl4ai
pip install -e .  # 기본 설치
pip install -e ".[all]"  # 모든 선택적 기능 설치
Github 주소:https://github.com/unclecode/crawl4ai
Crawl4AI 문서:https://docs.crawl4ai.com/
Discord:https://discord.com/invite/jP8KfhDhyN









