
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
Versatile-OCR-Program: 시험지 등 복잡한 자료에서 구조화된 데이터를 추출하는 OCR
小编 ·

Versatile-OCR-Program: 시험지 등 복잡한 자료에서 구조화된 데이터를 추출하는 OCR
Versatile-OCR-Program이란 무엇인가요?
Versatile-OCR-Program은 머신러닝 학습 최적화를 위해 특별히 설계된 OCR 시스템으로, 복잡한 교육 자료(예: 시험지)에서 구조화된 데이터를 추출하여 JSON 또는 Markdown 형식으로 출력할 수 있습니다. 일본어, 한국어, 영어를 지원하며, 다른 언어, 수학 공식, 표, 차트 및 그래프까지 확장 가능하고, 시맨틱 주석을 통한 자연어 설명 생성도 가능합니다.
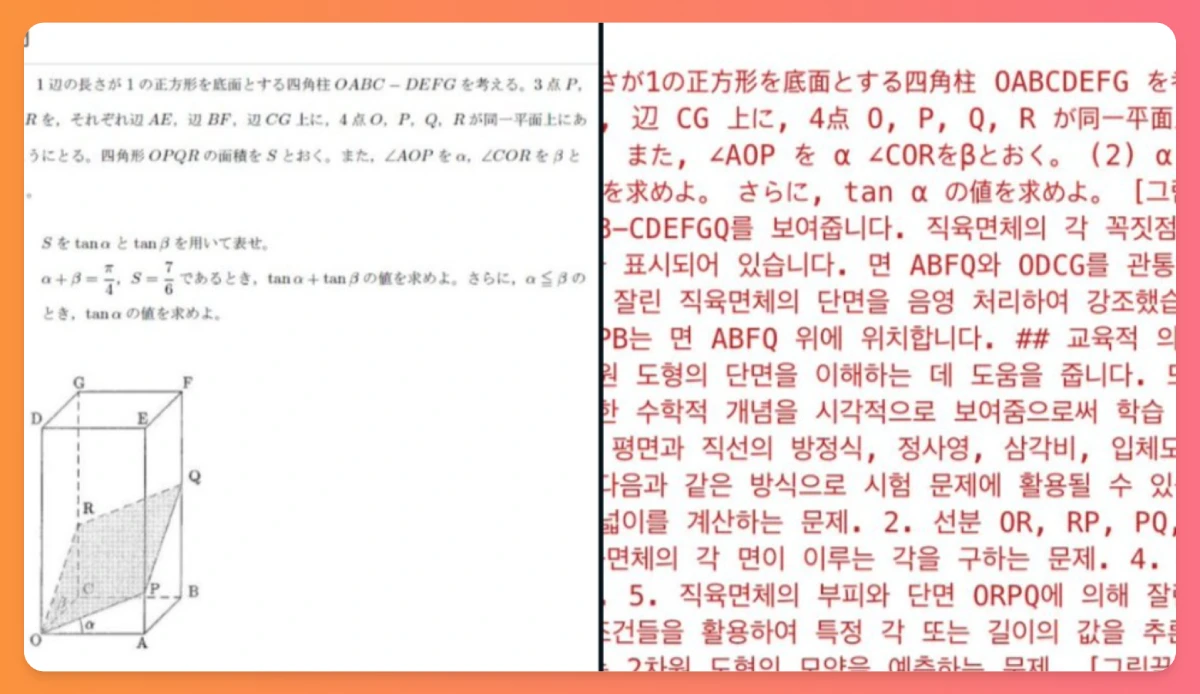
Versatile-OCR-Program의 주요 특징
머신러닝 학습 최적화: 추출된 요소(예: 차트, 표, 그래프)는 시맨틱 주석이 추가되며, 다운스트림 모델 학습을 강화하기 위해 시각적 콘텐츠의 자연어 설명이 자동으로 생성됩니다.
다국어 지원: 일본어, 한국어, 영어를 지원하며, 다른 언어로도 쉽게 사용자 정의할 수 있습니다.
구조화된 출력: 수학 표현식의 사람이 읽을 수 있는 설명, 표 요약, 그래프 제목 등을 포함하여 JSON 또는 Markdown 형식으로 ai 준비된 출력을 생성합니다.
고정밀도: EJU 생물학 및 도쿄대학교 수학과 같은 실제 학술 데이터셋에서 90% ~ 95%의 정확도를 달성합니다.
복잡한 레이아웃 지원: 밀집된 과학 콘텐츠, 공식이 많은 단락, 풍부한 시각적 요소를 포함하는 시험 형식의 PDF를 정확하게 처리할 수 있습니다.
기술 구현: DocLayout-YOLO, Google Vision API, Gemini Pro Vision, MathPix OCR, OpenAI API, OpenCV 등의 기술을 사용합니다.
샘플 출력
수학 및 생물학 문제의 입력 이미지와 변환된 출력 이미지, 그리고 영어 번역의 시맨틱 맥락과 추출된 데이터를 포함한 실제 샘플 출력을 제공합니다.
수학 문제 샘플: 기하학적 도형과 각도가 포함된 이미지에서 정보를 추출하고 관련 설명 및 문제를 생성하는 방법을 보여줍니다.
생물학 문제 샘플: 양파 뿌리끝 세포의 유사분열 과정을 보여주는 이미지에서 정보를 추출하고 관련 설명 및 문제를 생성하는 방법을 보여줍니다.
Versatile-OCR-Program 사용流程
1단계: 초기 OCR 추출: ocr_stage1.py 스크립트를 실행하여 입력 PDF에서 원시 요소(텍스트, 표, 그래프 등)를 추출하고, 레이아웃 감지를 수행한 후 중간 결과를 저장합니다.
2단계: 시맨틱 해석 및 최종 출력: ocr_stage2.py 스크립트를 실행하여 중간 데이터를 처리하고 구조화된 사람이 읽을 수 있는 출력으로 변환합니다. 여기에는 자연어 설명 생성, 요약 작성, AI 준비 형식(JSON/Markdown)으로의 콘텐츠 구성이 포함됩니다.
기술 구현
표 처리 최적화: DocLayout-YOLO를 사용하여 표 영역을 감지하고, Google Vision OCR을 사용하여 표를 처리하며(일본어 텍스트에 더 효과적), 표 구조를 구조화된 JSON 형식으로 보존합니다.
이미지 및 특수 영역 처리: Google Vision API의 이미지 분석 기능을 사용하여 이미지 영역을 처리하고, Google Cloud Vision API를 사용하여 이미지 설명을 생성하며, Google Cloud Vision API의 문서 분석 기능을 사용하여 차트/그래프를 처리하고, 처리 결과를 구조화된 JSON 형식으로 저장합니다.
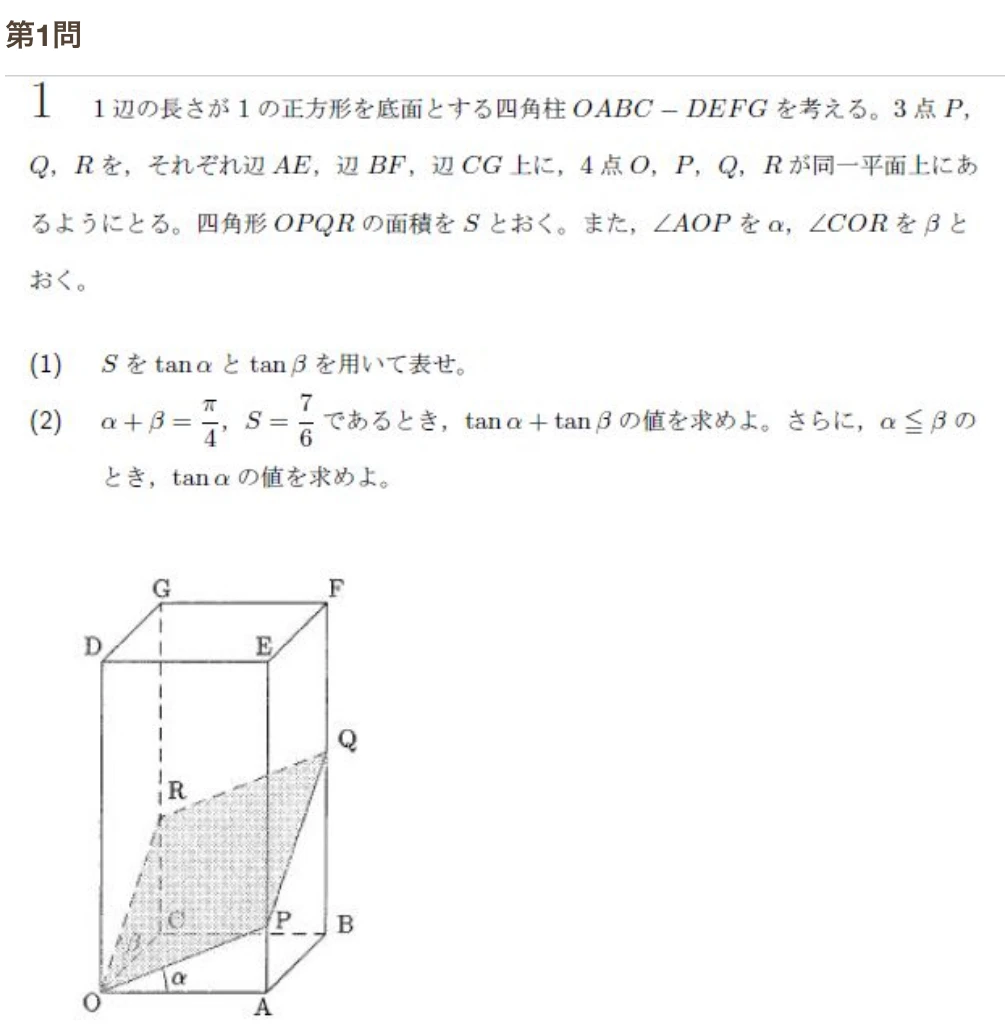
입력 효과
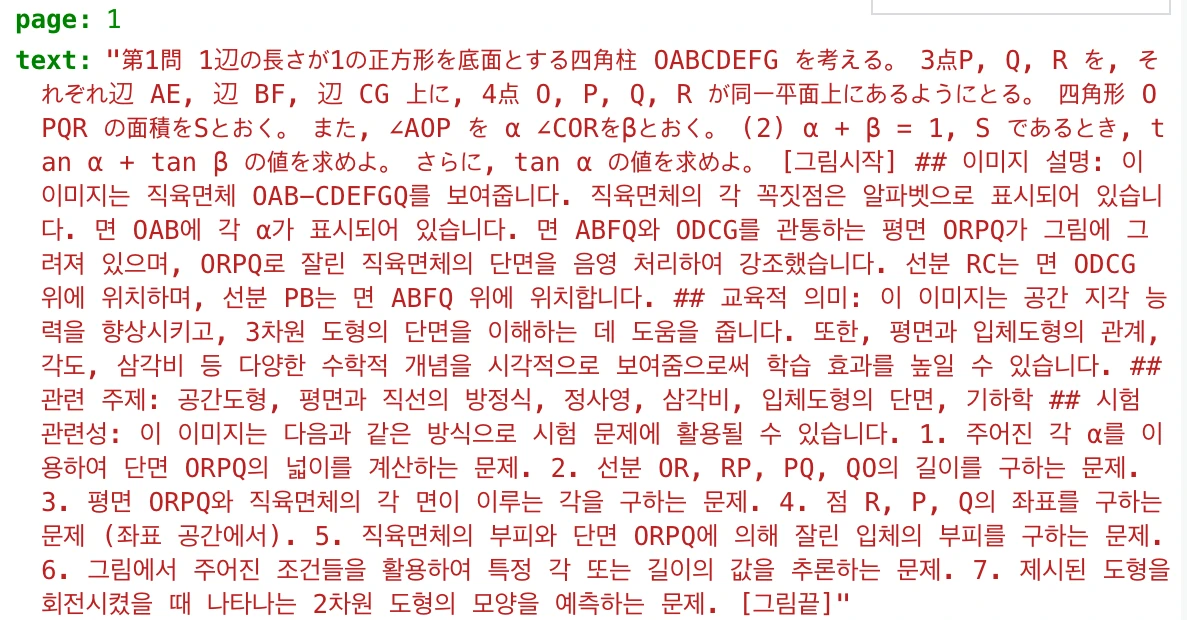
출력 효과
Versatile-OCR-Program 응용 분야
교육 분야: 시험지, 학술 논문 등 교육 자료에서 데이터를 추출하고 정리하여 교육 연구 및 학습을 지원하는 데 사용됩니다.
머신러닝 학습: 특히 교육 분야 응용 프로그램에서 머신러닝 모델을 학습시키기 위한 고품질 학습 데이터셋을 생성합니다.
다국어 문서 처리: 국제 학술 교류, 다국어 교육 자료의 디지털화 등 여러 언어로 된 문서를 처리해야 하는 시나리오에 적합합니다.
github 프로젝트:https://github.com/ses4255/Versatile-OCR-Program









