
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
Llama 4: 혼합 전문가(MoE) 아키텍처를 채택한 최초의 멀티모달 AI 모델
小编 ·

Llama 4: 혼합 전문가(MoE) 아키텍처를 채택한 최초의 멀티모달 AI 모델
Llama 4란 무엇인가?
Llama 4는 Meta사가 2025년 4월 5일에 발표한 최신 세대의 오픈소스 ai 모델 시리즈입니다. 여기에는 Llama 4 Scout와 Llama 4 Maverick이 포함되며, 이 둘은 MoE(Mixture of Experts) 아키텍처를 채택한 최초의 멀티모달 AI 모델입니다. Scout는 170억 개의 활성 파라미터, 16개의 "expert" 모델, 총 1,090억 개의 파라미터를 보유하고 있으며, Maverick 역시 170억 개의 활성 파라미터를 가지고 있지만 128개의 "expert" 모델을 갖추고 있어 총 파라미터 수가 4,000억 개에 달합니다. 또한 개발 중인 더욱 강력한 버전인 Llama 4 Behemoth는 2,880억 개의 활성 파라미터, 16개의 "expert" 모델을 가지며 총 파라미터 수가 약 2조 개에 가깝습니다. 이 모델들은 대량의 비标注 텍스트, 이미지 및 비디오 데이터로 학습되어 시각적 이해 능력을 갖추고 있습니다.
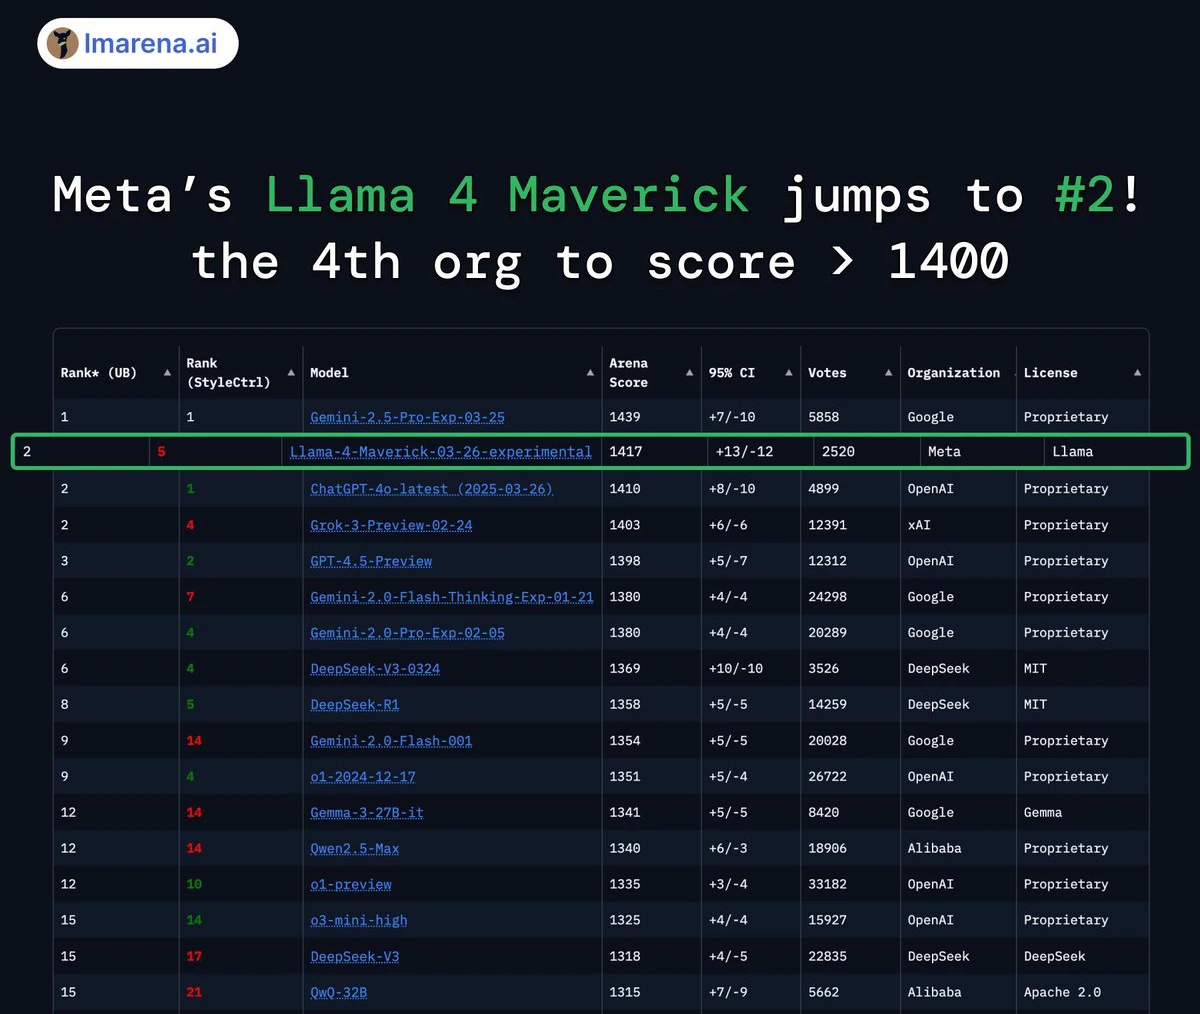
Llama 4 시리즈 모델
Llama 4 Scout
파라미터 규모: 활성 파라미터 170억 개, expert 16개
하드웨어 요구 사항: 단일 NVIDIA H100 GPU에서 실행 가능
컨텍스트 윈도우: 최대 1,000만 token의 초장기 컨텍스트 윈도우 지원
성능 우위: Gemma 3, Gemini 2.0 Flash-Lite, Mistral 3.1보다 우수한 성능
Llama 4 Maverick
파라미터 규모: 활성 파라미터 170억 개, expert 128개, 총 파라미터 4,000억 개
성능 우위: 멀티모달 작업에서 탁월한 성능을 보이며 GPT-4o 및 Gemini 2.0 Flash를 능가
추론 능력: 추론 및 코딩 능력은 DeepSeek v3과 동등하지만 활성 파라미터 수는 절반 미만
Llama 4 Behemoth(프리뷰 버전)
파라미터 규모: 활성 파라미터 2,880억 개, expert 16개, 총 파라미터 약 2조 개
성능 우위: 여러 STEM 벤치마크 테스트에서 GPT-4.5, Claude Sonnet 3.7, Gemini 2.0 Pro보다 우수한 성능
역할: 다른 Llama 4 모델을 증류하기 위한 교사(teacher) 모델로 활용되며, 현재 여전히 학습 중
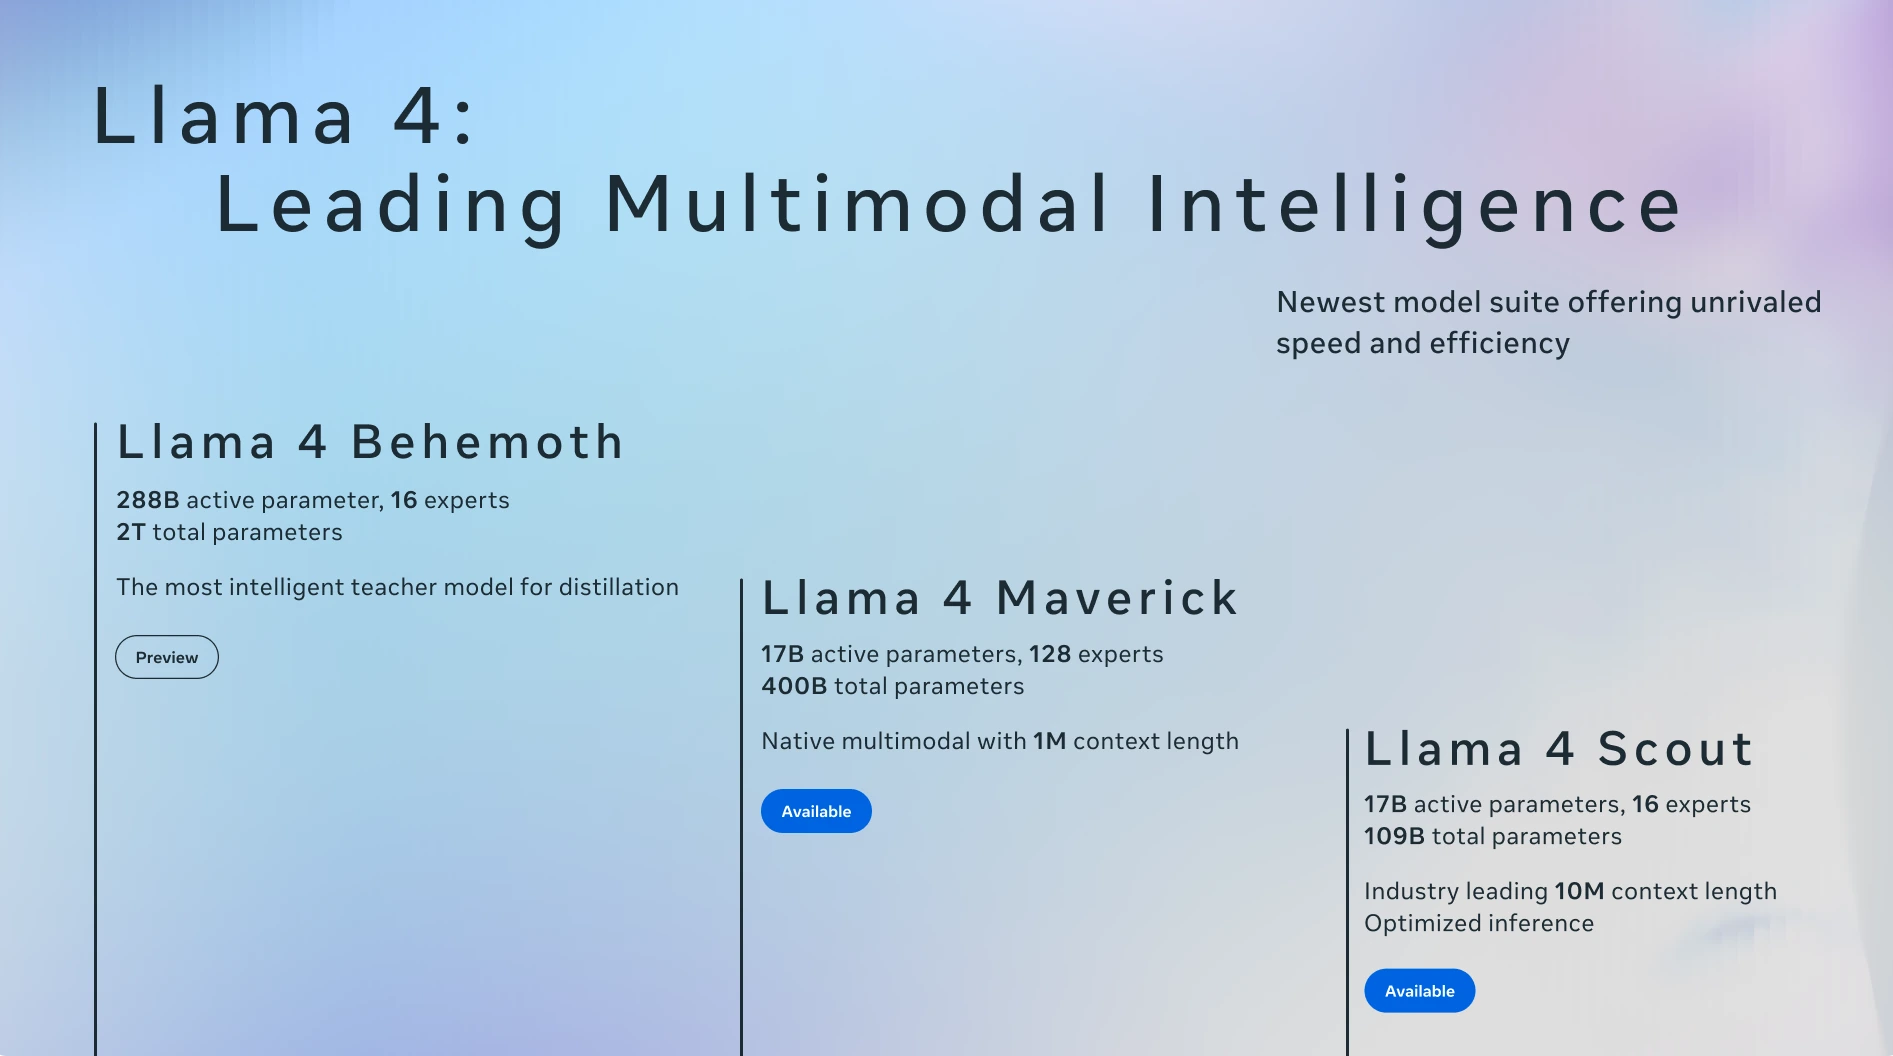
Llama 4 기능 특징
멀티모달 능력: Llama 4는 멀티모달 대형 모델로, 텍스트, 비디오, 이미지, 오디오 등 다양한 유형의 데이터를 처리하고 통합할 수 있으며 이러한 형식 간에 콘텐츠를 변환할 수 있습니다. 예를 들어, Llama 4 Scout는 복잡한 환경에서 이미지 콘텐츠를 분석할 수 있습니다.
MoE(Mixture of Experts) 아키텍처: 이것이 Llama 4의 핵심 특징 중 하나입니다. 이 아키텍처는 모델을 특정 작업에 집중하는 여러 "expert" 서브 모델로 분할하여 학습 및 사용자 질의 응답 시 효율성을 높입니다. 예를 들어, Llama 4 Maverick 모델은 총 4,000억 개의 파라미터를 가지고 있지만 실제 연산에는 170억 개의 파라미터만 활성화됩니다.
장기 컨텍스트 처리 능력: Llama 4 Scout의 컨텍스트 윈도우는 최대 1,000만 개의 token에 달하여 장문의 문서를 처리할 때 특히 뛰어난 성능을 보입니다.
음성 기능: Llama 4는 네이티브 음성 처리 기능을 도입하여, 음성을 텍스트로 변환하여 모델에 입력하고 다시 텍스트를 음성으로 변환할 필요 없이 직접 음성 정보를 처리할 수 있습니다. 이를 통해 음성 상호작용의 효율성과 자연스러움이 크게 향상되었습니다.
활용 분야
고객 서비스: 기업은 이러한 멀티모달 AI 모델을 활용하여 사용자가 제기한 문제를 신속하게 분석하고 보다 정확하고 효율적인 답변을 제공할 수 있습니다.
교육 분야: 지능형 교육 보조 도구는 학생의 질문을 이해하고 이미지를 결합하여 복잡한 개념을 설명함으로써 학습 효과를 크게 높일 수 있습니다.
가상 회의: 가상 회의에서 Llama 4는 사용자의 실시간 번역, 회의 요점 정리, 참가자 발화 시뮬레이션 등을 도와 커뮤니케이션 효율을 높이는 역할을 할 수 있습니다.
스마트 기기 제어: 사용자는 음성 명령을 통해 텍스트 작성, 메시지 전송, 스마트 홈 기기 제어 등의 작업을 손쉽게 수행할 수 있습니다.
정보 집약적 분야: Llama 4의 장기 컨텍스트 처리 능력은 의학, 과학, 공학, 수학, 문학 등 정보 집약적 분야에서 매우 유용합니다.
Llama 4 기술 특징
모델 규모 및 파라미터 수: Llama 4 Scout는 활성 파라미터 170억 개, 16개의 "expert" 모델, 총 1,090억 개의 파라미터를 보유하고 있습니다. Llama 4 Maverick 역시 활성 파라미터 170억 개이지만 128개의 "expert" 모델을 갖추고 있어 총 파라미터 수가 4,000억 개에 달합니다. Llama 4 Behemoth는 활성 파라미터 2,880억 개와 총 2조 개의 파라미터를 보유하고 있습니다.
학습 데이터 및 다양성: 모든 모델은 광범위한 시각적 이해 능력을 습득하기 위해 대량의 비标注 텍스트, 이미지 및 비디오 데이터로 학습되었습니다.
아키텍처 최적화: MoE 아키텍처를 채택하여 데이터 처리 작업을 하위 작업으로 분해하고 이를 더 작은 "expert" 모델에 할당함으로써 더 높은 실행 효율을 구현했습니다.
추론 효율: 모델 운영 비용과 지연 시간을 줄임으로써 추론 효율을 향상시켰습니다. 예를 들어, Llama 4 Maverick는 단일 NVIDIA H100 DGX 호스트에서 실행될 수 있습니다.
Meta는 Llama 4 Maverick의 추론 비용이 100만 token당 0.19달러에서 0.49달러(입력 및 출력 비율 3:1)일 것으로 추정하며, 이는 GPT-4o와 같은 독점 모델보다 훨씬 저렴합니다.
자세히 보기:https://ai.meta.com/blog/llama-4-multimodal-intelligence/
모델 다운로드:https://www.llama.com/llama-downloads/?utm_source=llama-home-hero&utm_medium=llama-referral&utm_campaign=llama-utm&utm_offering=llama-downloads&utm_product=llama









