
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
Dolphin: Datatang과 칭화대가 공동 발표한 동양 언어 전용 자동 음성 인식 모델
小编 ·

Dolphin: Datatang과 칭화대가 공동 발표한 동양 언어 전용 자동 음성 인식 모델
Dolphin이란 무엇인가?
Dolphin은 하이톈루이셍(海天瑞声)과 칭화대학교 전자공학과 음성 및 오디오 기술 실험실이 공동 개발한 동방 언어 전용 자동 음성 인식 모델입니다.Dolphin은 40개 동방 언어와 22개 중국 방언을 지원합니다. 높은 정확도와 강력한 견고성을 갖추고 있어 다양한 복잡한 음성 환경에 적응할 수 있습니다. Dolphin은 음성을 텍스트로 변환, 음성 상호작용, 음성 콘텐츠 분석 등 다양한场景에서 널리 사용되며, 원 클릭 설치와 여러 호출 방식을 지원합니다.
Dolphin 모델 특징
다국어 지원: Dolphin은 동아시아, 남아시아, 동남아시아, 중동 지역의 언어를 포함하여 40가지 동방 언어를 지원하며, 22가지 중국 방언(보통어 포함)도 지원합니다.
언어 자동 적응: 입력된 음성의 언어 종류를 수동으로 지정할 필요 없이 자동으로 인식합니다.
높은 정확도: 여러 테스트 세트에서 단어 오류율(WER)이同类 모델보다 현저히 낮습니다.
강력한 견고성: 다양한 액센트, 말하는 속도, 배경 소음 등 복잡한 음성 환경에 적응합니다.
고성능: 하이톈루이셍, Fleurs, CommonVoice 세 가지 테스트 세트에서 Whisper의 동일 크기 모델과 비교했을 때 Dolphin의 단어 오류율(WER)이 현저히 감소했습니다. 예를 들어, base 버전은 평균 WER이 63.1% 감소했고, small 버전은 평균 WER이 68.2% 감소했습니다.
오픈 소스: Dolphin의 base 및 small 버전 모델과 추론 코드가 전면 오픈 소스로 공개되었습니다.
Dolphin 기술 아키텍처
네트워크 구조: CTC-Attention 아키텍처를 기반으로 하며, E-Branchformer 인코더와 Transformer 디코더를 채택하고 4배 다운샘플링 레이어를 도입했습니다. 이 구조는 CTC의 시퀀스 모델링 능력과 어텐션 메커니즘의 문맥 포착 능력을 결합하여 모델의 인식 정확도와 효율성을 효과적으로 향상시킵니다.
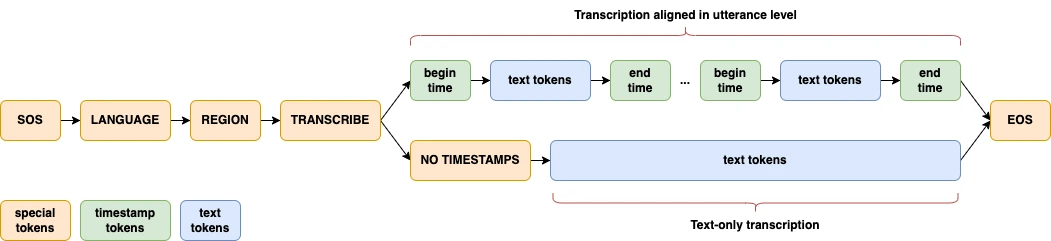
다중 작업 형식: Dolphin은 Whisper와 OWSM의 설계 방법을 참고하여 ASR에 초점을 맞추고 몇 가지 핵심적인 수정을 가했습니다. 예를 들어 previous text 및 관련 토큰의 사용을 제거하여 입력 형식을 간소화했습니다. 또한 Dolphin은 언어 및 지역의 다양성을 더 잘 처리하기 위해两级 언어 태그 시스템을 도입했습니다.
데이터 기반
Dolphin의 훈련 데이터 세트는 하이톈루이셍의 전용 데이터와 여러 오픈 소스 데이터 세트를 통합한 것으로, 총 길이가 21.2만 시간을 넘습니다. 그중 하이톈루이셍 데이터 세트는 38개 동방 언어에 걸쳐 137,712시간의 오디오를 포함합니다.
활용 场景
음성을 텍스트로 변환: 회의 기록, 음성 입력기 등 场景에 적합합니다.
음성 상호작용: ai 지능형 음성 어시스턴트, 스마트 홈 등에 사용되어 상호작용 경험을 향상시킵니다.
음성 콘텐츠 분석: 음성 미디어 콘텐츠를 빠르게 전사하고 분석합니다.
Dolphin 사용 튜토리얼
설치: 사용자는 pip install -U dataoceanai-dolphin 명령으로 원 클릭 설치할 수 있습니다.
명령줄 호출: 예를 들어 dolphin audio.wav 를 사용하여 음성 인식을 수행하며, 모델 버전, 언어 및 지역 태그를 지정할 수도 있습니다.
Python 호출: dolphin 모듈을 import하고 오디오와 모델을 로드하여 음성 인식을 수행할 수 있습니다.
관련 링크
Github 주소:https://github.com/DataoceanAI/Dolphin
프로젝트 홈페이지:https://huggingface.co/DataoceanAI









