
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
SegAnyMo: 영상 속 움직이는 객체를 자동 인식하고 정밀하게 분할하는 도구
小编 ·

SegAnyMo: 영상 속 움직이는 객체를 자동 인식하고 정밀하게 분할하는 도구
SegAnyMo란 무엇인가요?
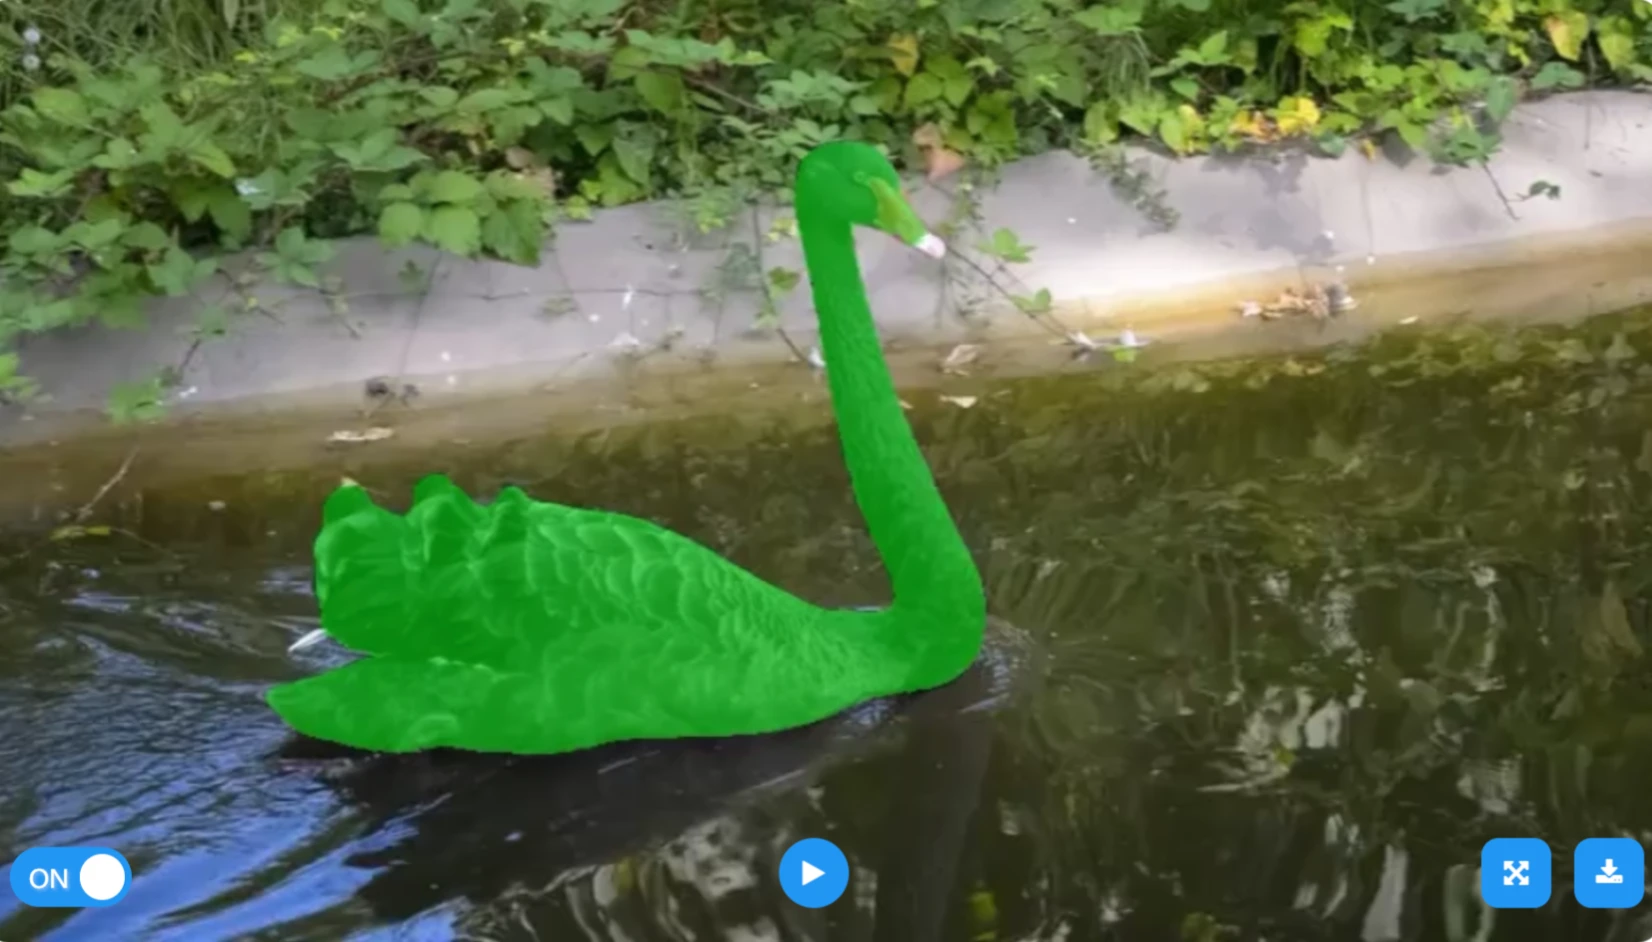
SegAnyMo(Segment Any Motion in Videos)는 스마트 "비디오 누끼 따기" 도구입니다. 동영상에서 움직이는 물체를 자동으로 인식하고 정밀하게 분할할 수 있으며, 수동 주석 없이도 동영상 내 여러 움직이는 객체를 분할할 수 있습니다. 물체의 움직임이 지나치게 빠르거나,画面이 흐릿하거나, 배경이 복잡한 장면도 처리할 수 있습니다.
연구 배경
움직이는 객체 분할은 시각 장면의 고급 이해를 실현하는 데 핵심적인 과제로, numerous한 downstream 응용 분야를 가지고 있습니다. 과거의 연구는 대부분 광학 흐름(optical flow)에 의존하여 동작 단서를 제공했지만, 이 방법은 부분적 움직임, 복잡한 변형, 동작 블러 및 배경 간섭과 같은 도전에 직면할 때 부정확한 예측 결과를 초래하는 경우가 많았습니다.
방법 소개
본 연구에서는 장거리 궤적 동작 단서와 DINO 기반 의미 특징을 결합하고, SAM2를 활용하여 반복 프롬프트 전략을 통해 픽셀 단위 마스크 밀집화를 수행하는 새로운 움직이는 객체 분할 방법을 제안합니다. 구체적인 절차는 다음과 같습니다.
입력 처리: 기존 모델로 생성된 2D 궤적과 깊이 맵을 입력으로 사용하며, 동작 인코더를 통해 동작 패턴을 포착하여 특징 궤적을 생성합니다.
궤적 디코딩: DINO 특징을 통합한 궤적 디코더를 사용하여 특징 궤적을 디코딩하고, 동작 정보와 의미 정보를 분리하여 최종적으로 동적 궤적을 얻습니다.
마스크 생성: SAM2를 활용하여 동일한 물체에 속하는 동적 궤적을 그룹화하고, 정밀한 움직이는 객체 마스크를 생성합니다.
SegAnyMo 기능
움직이는 객체 탐지 및 분할: 동영상에서 움직이는 물체를 자동으로 탐지하고 해당 분할 마스크를 생성하여 움직이는 물체의 윤곽과 위치를 정확히 표시합니다.
복잡한 장면 처리: 부분적 움직임, 복잡한 변형, 동작 블러 및 배경 간섭과 같은 복잡한 장면을 대응할 수 있으며, 여전히 목표 객체를 정확하게 분할합니다.
다중 객체 분할: 동영상 내 여러 움직이는 목표를 동시에 탐지하고 분할할 수 있으며, 각 목표에 대해 독립적인 분할 마스크를 생성하여 개별 처리 및 분석이 용이합니다.
일반화 능력: 매우 뛰어난 일반화 능력을 갖추고 있어 다양한 동영상 데이터셋과 장면에 적응할 수 있으며, 보지 못한 장면에서도 높은 분할 정확도를 유지합니다.
의미 정보 결합: 의미 정보를 결합하여 움직이는 목표를 보다 정확하게 분할하고, 정지된 물체가 움직이는 물체로 잘못 인식되는 것을 방지합니다.
실시간성 및 효율성: 일정 수준의 실시간 처리 요구를 충족하며, 실시간성이 요구되는 장면에 적용할 수 있습니다.
다양한 입력 지원: 2D 궤적, 깊이 맵 등 다양한 입력 데이터를 지원하며, 다양한 입력 조건에 따라 분할 전략을 유연하게 조정할 수 있습니다.
확장성: 아키텍처 설계가 뛰어난 확장성을 갖추고 있어, 모듈을 추가하거나 조정하여 성능을 높이거나 새로운 작업 요구에 적응할 수 있습니다.
기술적 우위
시공간 궤적 어텐션 메커니즘: 이 메커니즘을 통해 모델은 동작 정보에 더 잘 주목할 수 있으며, 동시에 의미 지원을 결합하여 복잡한 장면에서도 움직이는 목표를 정확하게 분할할 수 있습니다.
동작-의미 분리 임베딩: 모델이 의미 정보에 과도하게 의존하여 발생하는 잘못된 판단을 방지합니다. 예를 들어 정지된 노면을 동적 물체로 잘못 분류하지 않습니다.
강력한 일반화 능력: 여러 데이터셋에 걸친 광범위한 테스트 결과, 본 모델은 도전적인 장면과 다중 목표에 대한 세밀한 분할에서 뛰어난 성능을 보였습니다.
응용 시나리오
동영상 감시: 보행자, 차량 등 움직이는 목표를 실시간으로 탐지하여 오보를 줄이고, 보안 감시의 정확성을 향상시킵니다.
자율주행: 도로 위의 동적 장애물을 인식하여 자율주행 의사결정을 지원합니다.
스포츠 동영상 분석: 운동선수의 동작을 분할하여 복잡한 동작 및 다인 장면 분석을 지원합니다.
스마트 보안: 정지된 물체의 오보를 방지하여 시스템 신뢰성을 향상시킵니다.
동영상 편집: 서로 다른 움직이는 목표를 분류 처리하여 특수 효과 추가와 목표 교체를 용이하게 합니다.
교통 감시: 다중 차량의 움직임을 분석하여 교통 흐름 관리를 지원합니다.
로봇 비전: 깊이 맵을 활용하여 움직이는 목표를 분할하고, 로봇의 내비게이션과 장애물 회피를 지원합니다.
다자 화상 회의: 발화자 이미지를 분할하여 상호작용 경험을 향상시킵니다.
학술 및 개발: 오픈 소스 코드로 재현 및 2차 개발이 용이하며, 새로운 데이터셋 학습 및 테스트를 지원합니다.
프로젝트 홈페이지:https://motion-seg.github.io/
Github 주소:https://github.com/nnanhuang/SegAnyMo









