
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
Qwen2.5-Omni: Alibaba가 출시한 엔드투엔드 올인원 멀티모달 플래그십 모델
小编 ·

Qwen2.5-Omni: Alibaba가 출시한 엔드투엔드 올인원 멀티모달 플래그십 모델
Qwen2.5-Omni란 무엇인가요?
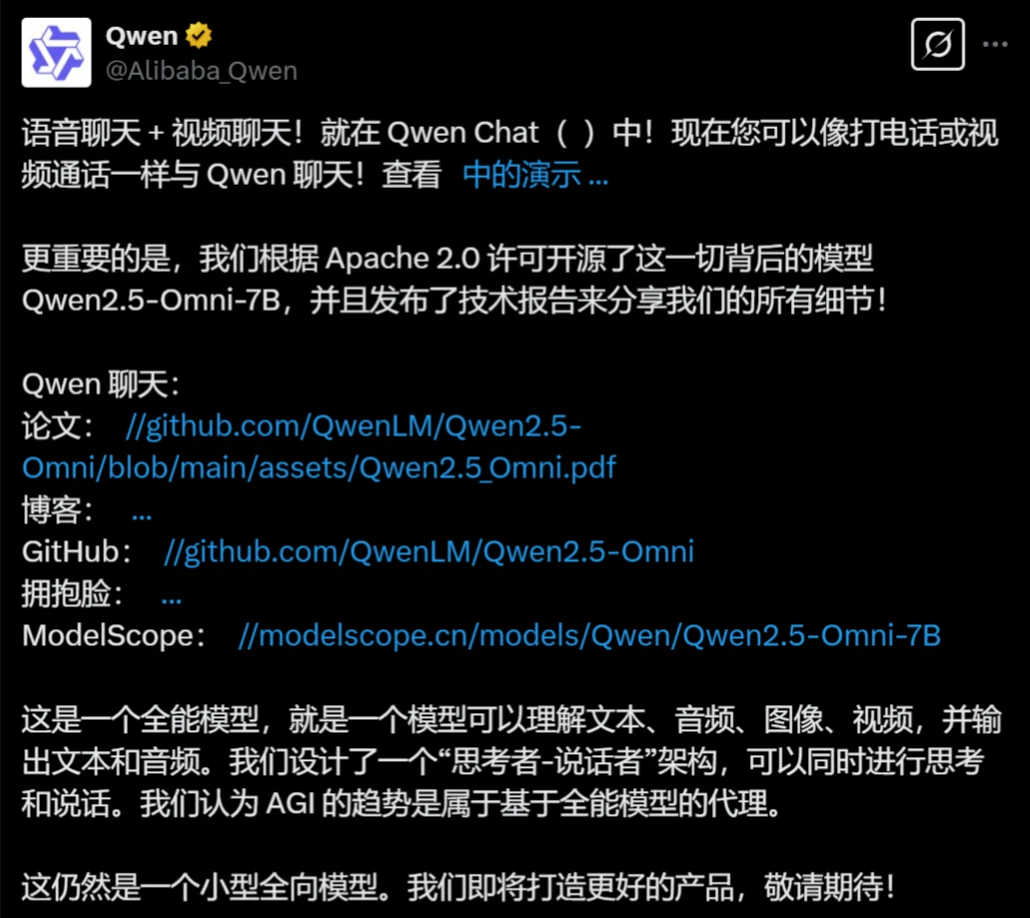
Qwen2.5-Omni는 알리바바가 발표한 Qwen 시리즈의 차세대 엔드투엔드 멀티모달 플래그십 모델입니다. 이는 텍스트, 오디오, 이미지, 비디오를 이해하고, 동시에 사고하며 말할 수 있도록 설계된全方位的 멀티모달 인식을 위한 모델로, 실시간 스트리밍 응답을 통해 텍스트와 자연스러운 음성 합성 출력을 동시에 생성할 수 있는 ai 모델입니다.
Qwen2.5-Omni 핵심 특징
혁신적인 아키텍처:
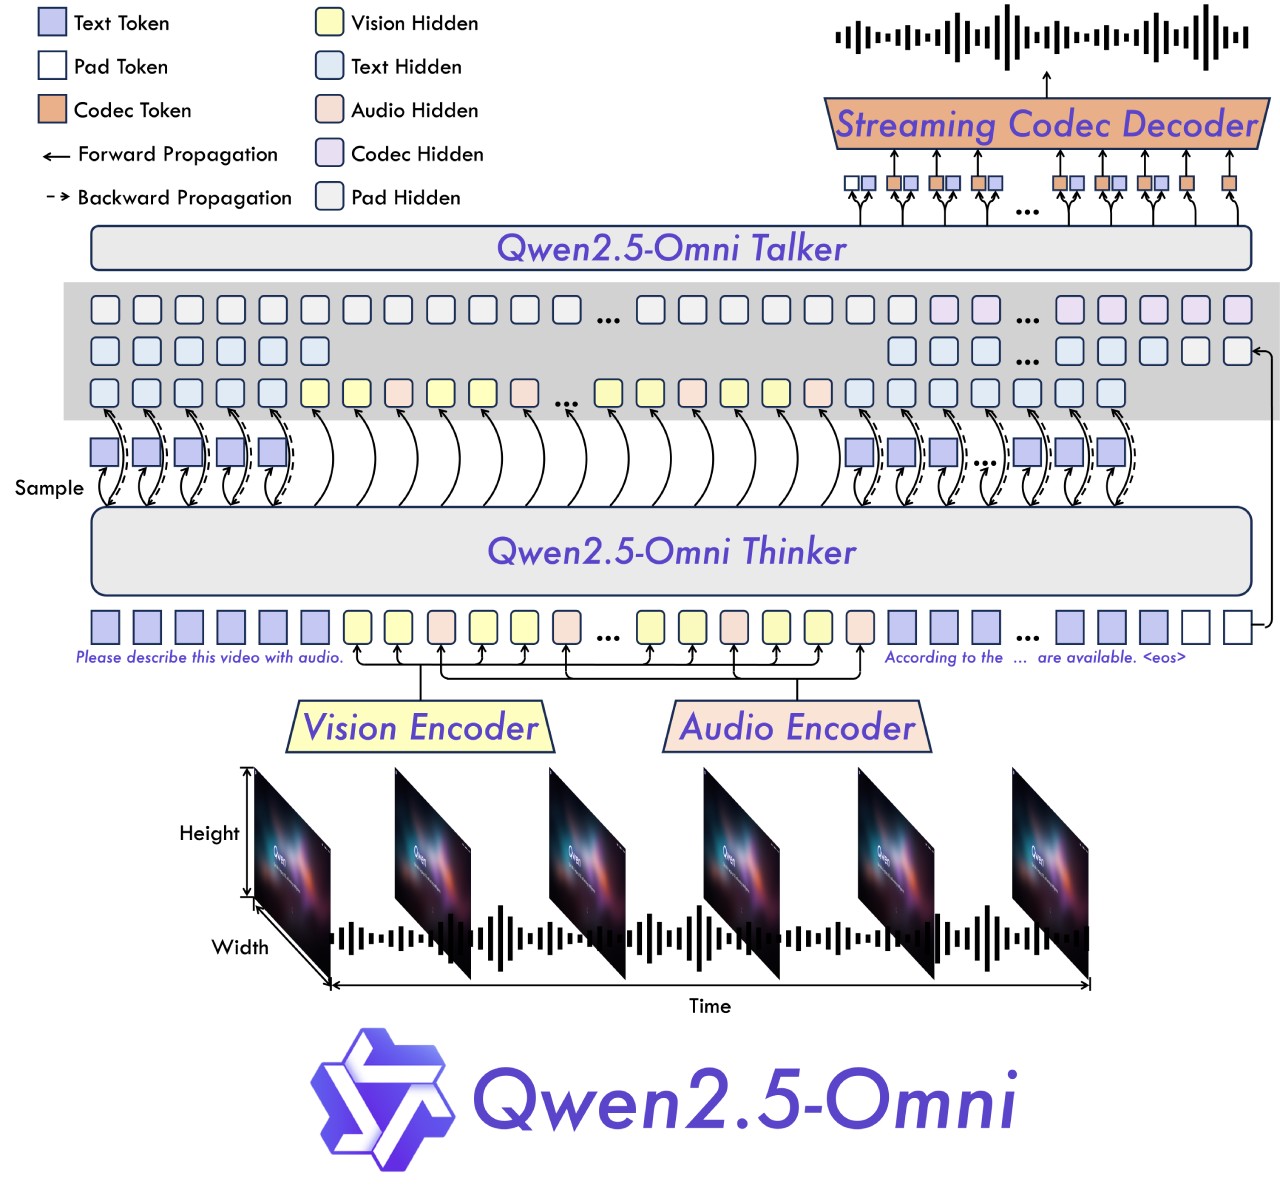
Thinker-Talker 아키텍처: Thinker는 텍스트, 오디오, 비디오 모달리티의 입력을 처리하고 이해하여 고급 의미 표현과 해당 텍스트 콘텐츠를 생성합니다. Talker는 이러한 콘텐츠를 자연스러운 음성 출력으로 변환합니다.
TMRoPE 기술: 비디오 입력과 오디오의 타임스탬프를 동기화하기 위한 TMRoPE(Time-aligned Multimodal RoPE)라는 새로운 위치 인코딩 기술을 제안했습니다.
실시간 상호작용:
완전한 실시간 상호작용을 지원하며, 청크 단위 입력을 처리하고 즉시 출력할 수 있습니다.
자연스럽고 부드러운 음성 생성:
음성 생성의 자연스러움과 안정성 측면에서 기존의 많은 스트리밍 및 비스트리밍 대안을 능가합니다.
전 모달리티 성능 우위:
멀티모달 작업(예: OmniBench)에서 뛰어난 성능을 보이며, 단일 모달리티 작업(예: 음성 인식, 번역, 오디오 이해, 이미지 추론, 비디오 이해 등)에서도 뛰어난 성능을 보입니다.
엔드투엔드 음성 명령 수행 능력:
엔드투엔드 음성 명령 수행에서 텍스트 입력 처리와 필적하는 효과를 보이며, MMLU 및 GSM8K 등의 벤치마크 테스트에서 우수한 성능을 보입니다.
Qwen2.5-Omni 아키텍처 설계
Thinker:뇌와 유사하며, 텍스트, 오디오, 비디오 모달리티의 입력을 처리하고 이해하여 고급 의미 표현과 해당 텍스트 콘텐츠를 생성합니다.
Talker:인간의 입과 유사하며, Thinker가 생성한 고급 의미 표현과 텍스트 콘텐츠를 받아 스트리밍 방식으로 자연스러운 음성을 출력합니다.
전체 아키텍처:Thinker는 오디오와 이미지의 정보를 추출하기 위한 인코더를 갖춘 Transformer 디코더입니다. Talker는 듀얼 트랙 자기회귀 Transformer 디코더 아키텍처입니다. 학습 및 추론 과정에서 Talker는 Thinker로부터 직접 고차원 표현을 받고 Thinker의 모든 과거 컨텍스트 정보를 공유하며, 전체 아키텍처는 통합된 모델로 엔드투엔드 학습 및 추론됩니다.
Qwen2.5-Omni 성능
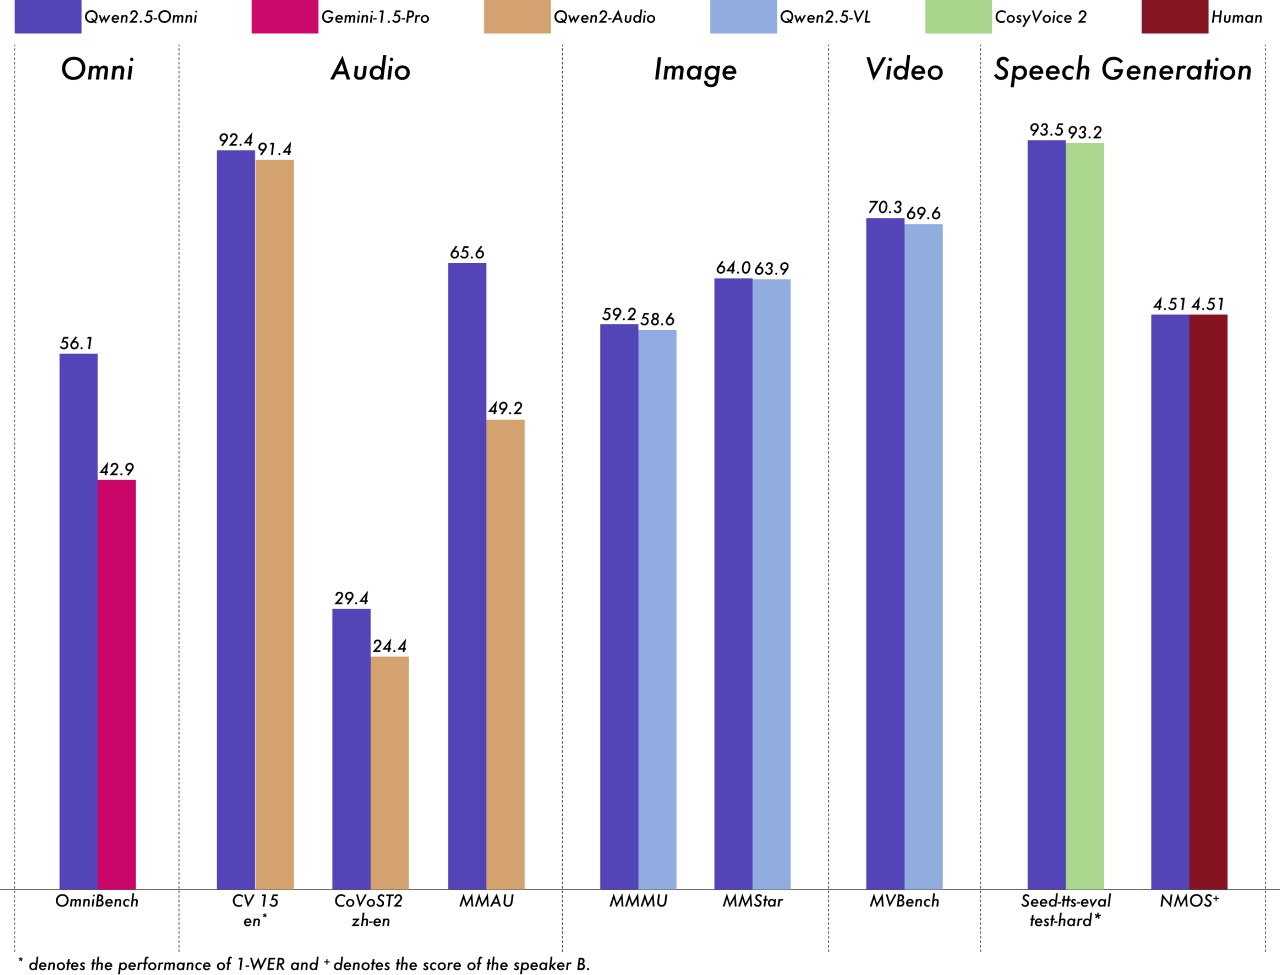
멀티모달 작업(예: OmniBench)에서 Qwen2.5-Omni는 최첨단 성능을 달성했습니다.
단일 모달리티 작업에서 음성 인식(Common Voice), 번역(CoVoST2), 오디오 이해(MMAU), 이미지 추론(MMU, MMStar), 비디오 이해(MVBench), 음성 생성(Seed-tts-eval 및 주관적 자연스러움) 등에서 뛰어난 성능을 보입니다.
관련 링크
Qwen Chat: https://chat.qwenlm.ai
Hugging Face: https://huggingface.co/Qwen/Qwen2.5-Omni-7B
ModelScope: https://modelscope.cn/models/Qwen/Qwen2.5-Omni-7B
DashScope: https://help.aliyun.com/zh/model-studio/user-guide/qwen-omni
GitHub: https://github.com/QwenLM/Qwen2.5-Omni
Demo 체험: https://modelscope.cn/studios/Qwen/Qwen2.5-Omni-Demo









