
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
PDF-Craft: 스캔된 책 PDF를 Markdown/EPUB로 변환하는 도구
小编 ·

PDF-Craft: 스캔된 책 PDF를 Markdown/EPUB로 변환하는 도구
PDF-Craft란 무엇인가요?
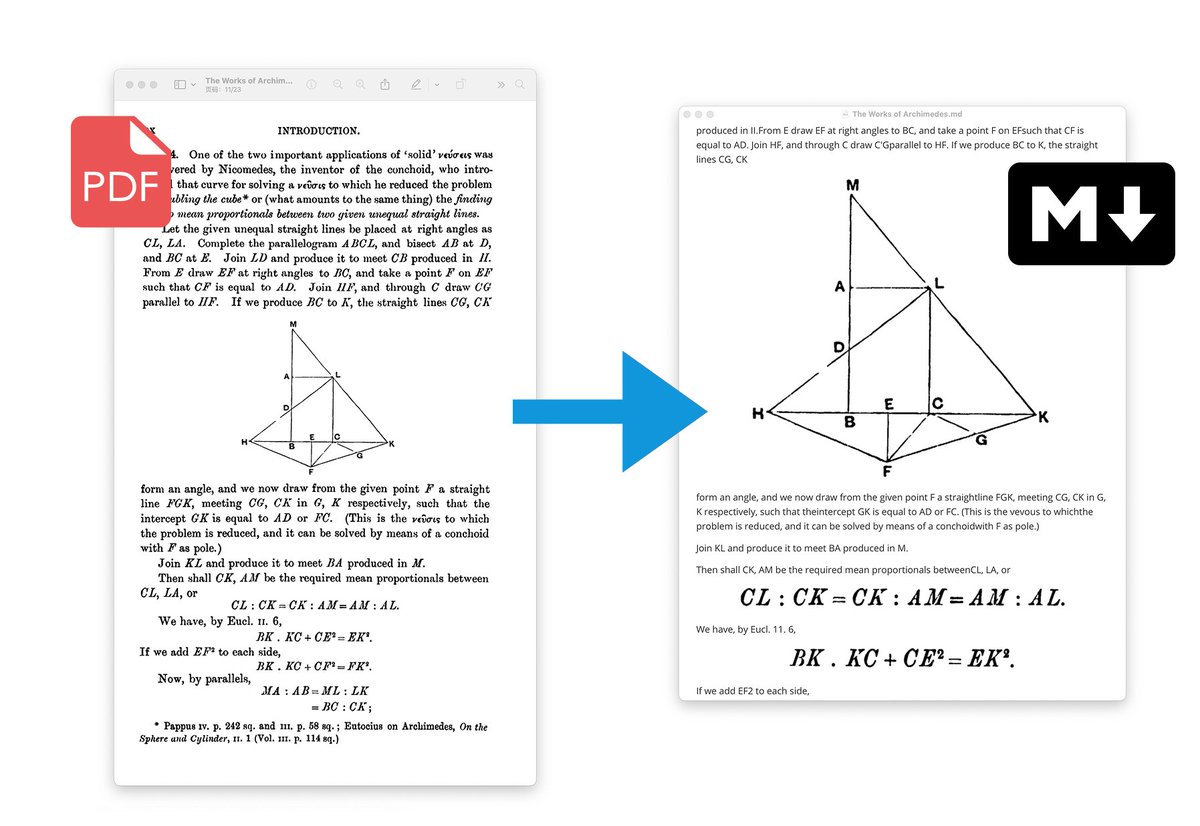
PDF-Craft는 PDF 파일을 처리하기 위한 오픈 소스 프로젝트로, 스캔한 책 PDF를 Markdown 또는 EPUB 형식으로 변환하는 데 중점을 둡니다. OCR 기술을 통해 텍스트를 인식하고, ai 알고리즘을 활용하여 텍스트를 추출하고 머리글, 바닥글 등의 요소를 필터링하여 구조화된 콘텐츠를 생성합니다. 로컬 연산과 LLM 보조 기능을 지원하며, 학술 논문, 소책자 및 장편 도서의 형식 변환에 적합합니다.
PDF-Craft 기능 특징
형식 변환:
PDF를 Markdown 형식으로 변환하는 것을 지원하며, 논문이나 소책자에 적합합니다.
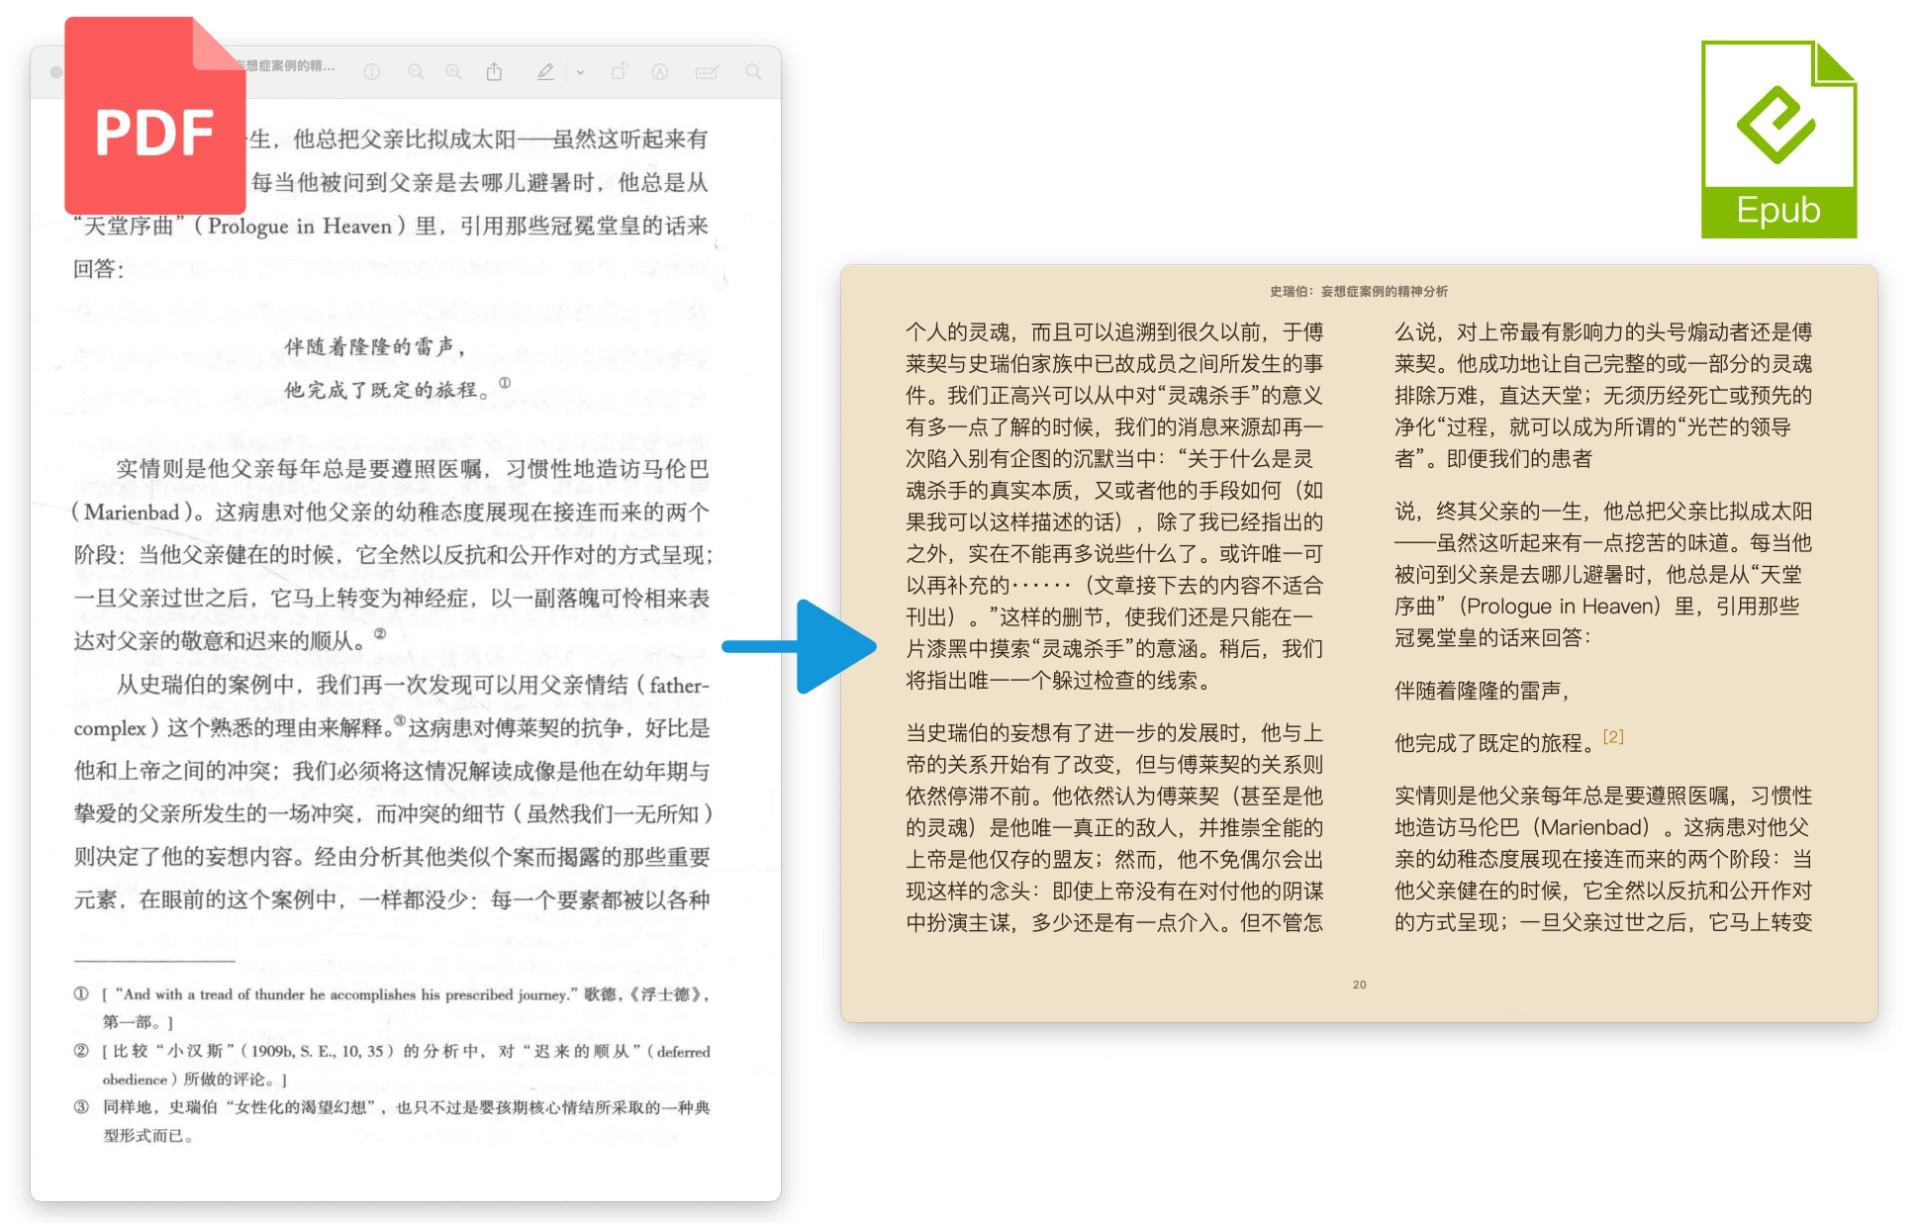
100페이지가 넘는 경우, 로컬 OCR과 클라우드 LLM 처리를 결합하여 목차가 있는 장별 구분 EPUB을 생성합니다.
지능형 추출:
DocLayout-YOLO와 자체 알고리즘을 사용하여 본문을 추출하고, 머리글, 바닥글, 각주, 페이지 번호 등의 요소를 필터링합니다.
페이지가 넘어갈 때, 알고리즘이 앞뒤 문맥의 연결 문제를 처리합니다.
OCR 인식:
OnnxOCR을 사용하여 텍스트 인식을 수행하며, 삽화, 표, 수식의 스크린샷을 지원하여 출력 파일에 직접 삽입합니다.
읽기 순서 최적화:
layoutreader를 통해 인간의 읽기 습관에 맞는 순서를 결정합니다.
LLM 보조:
EPUB 변환 과정에서 LLM(예: DeepSeek)을 통해 주석 및 인용 정보를 읽고 EPUB에 표시합니다.
LLM은 또한 일정 수준에서 OCR 오류를 교정할 수 있습니다.
로컬 실행:
CPU 및 GPU 가속을 지원하며, 인터넷에 연결하지 않고도 대부분의 작업을 완료할 수 있습니다.
PDF-Craft 활용 시나리오
학술 연구: 스캔한 학술 논문을 Markdown 또는 EPUB 형식으로 변환하여 편집과 읽기에 용이하게 합니다.
전자책 제작: 스캔한 책을 EPUB 형식으로 변환하여 목차와 챕터가 있는 전자책을 생성합니다.
문서 처리: PDF에서 텍스트와 이미지를 추출하여 추가 편집이나 아카이빙에 사용합니다.
PDF-Craft 사용 방법
1. 설치: Python 3.10 이상 버전이 필요하며, CUDA 가속을 지원합니다.
2. PDF를 Markdown으로 변환:
from pdf_craft import PDFPageExtractor, MarkDownWriter
extractor = PDFPageExtractor(device="cpu", model_dir_path="/path/to/model")
with MarkDownWriter(markdown_path, "images", "utf-8") as md:
    for block in extractor.extract(pdf="/path/to/pdf"):
        md.write(block)
3. PDF를 EPUB으로 변환:
from pdf_craft import PDFPageExtractor, LLM, analyse, generate_epub_file
extractor = PDFPageExtractor(device="cpu", model_dir_path="/path/to/model")
llm = LLM(key="sk-XXXXX", url="https://api.deepseek.com", model="deepseek-chat")
analyse(llm=llm, pdf_page_extractor=extractor, pdf_path="/path/to/pdf", analysing_dir_path="/path/to/analysing", output_dir_path="/path/to/output")
generate_epub_file(from_dir_path="/path/to/output", epub_file_path="/path/to/output.epub")
github 프로젝트:https://github.com/oomol-lab/pdf-craft









