
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
KDTalker: 오디오 신호로 사실적인 표정과 동작 영상을 생성
小编 ·

KDTalker: 오디오 신호로 사실적인 표정과 동작 영상을 생성
KDTalker란 무엇인가?
KDTalker는 오디오 기반 동적 포트레이트 생성 도구로, 입력된 오디오 신호에 따라 사실적인 표정과 동작을 생성할 수 있습니다. KDTalker는 암시적 키포인트 기술, 시공간 확산 모델, 다양한 포즈 지원 등의 특징을 갖추고 있습니다. 가상 현실, 소셜 미디어, 비디오 회의 등 다양한 시나리오에 적용할 수 있습니다. 간단한 환경 준비와 명령줄 조작만으로 고품질의 동적 포트레이트 비디오를 빠르게 생성할 수 있습니다.
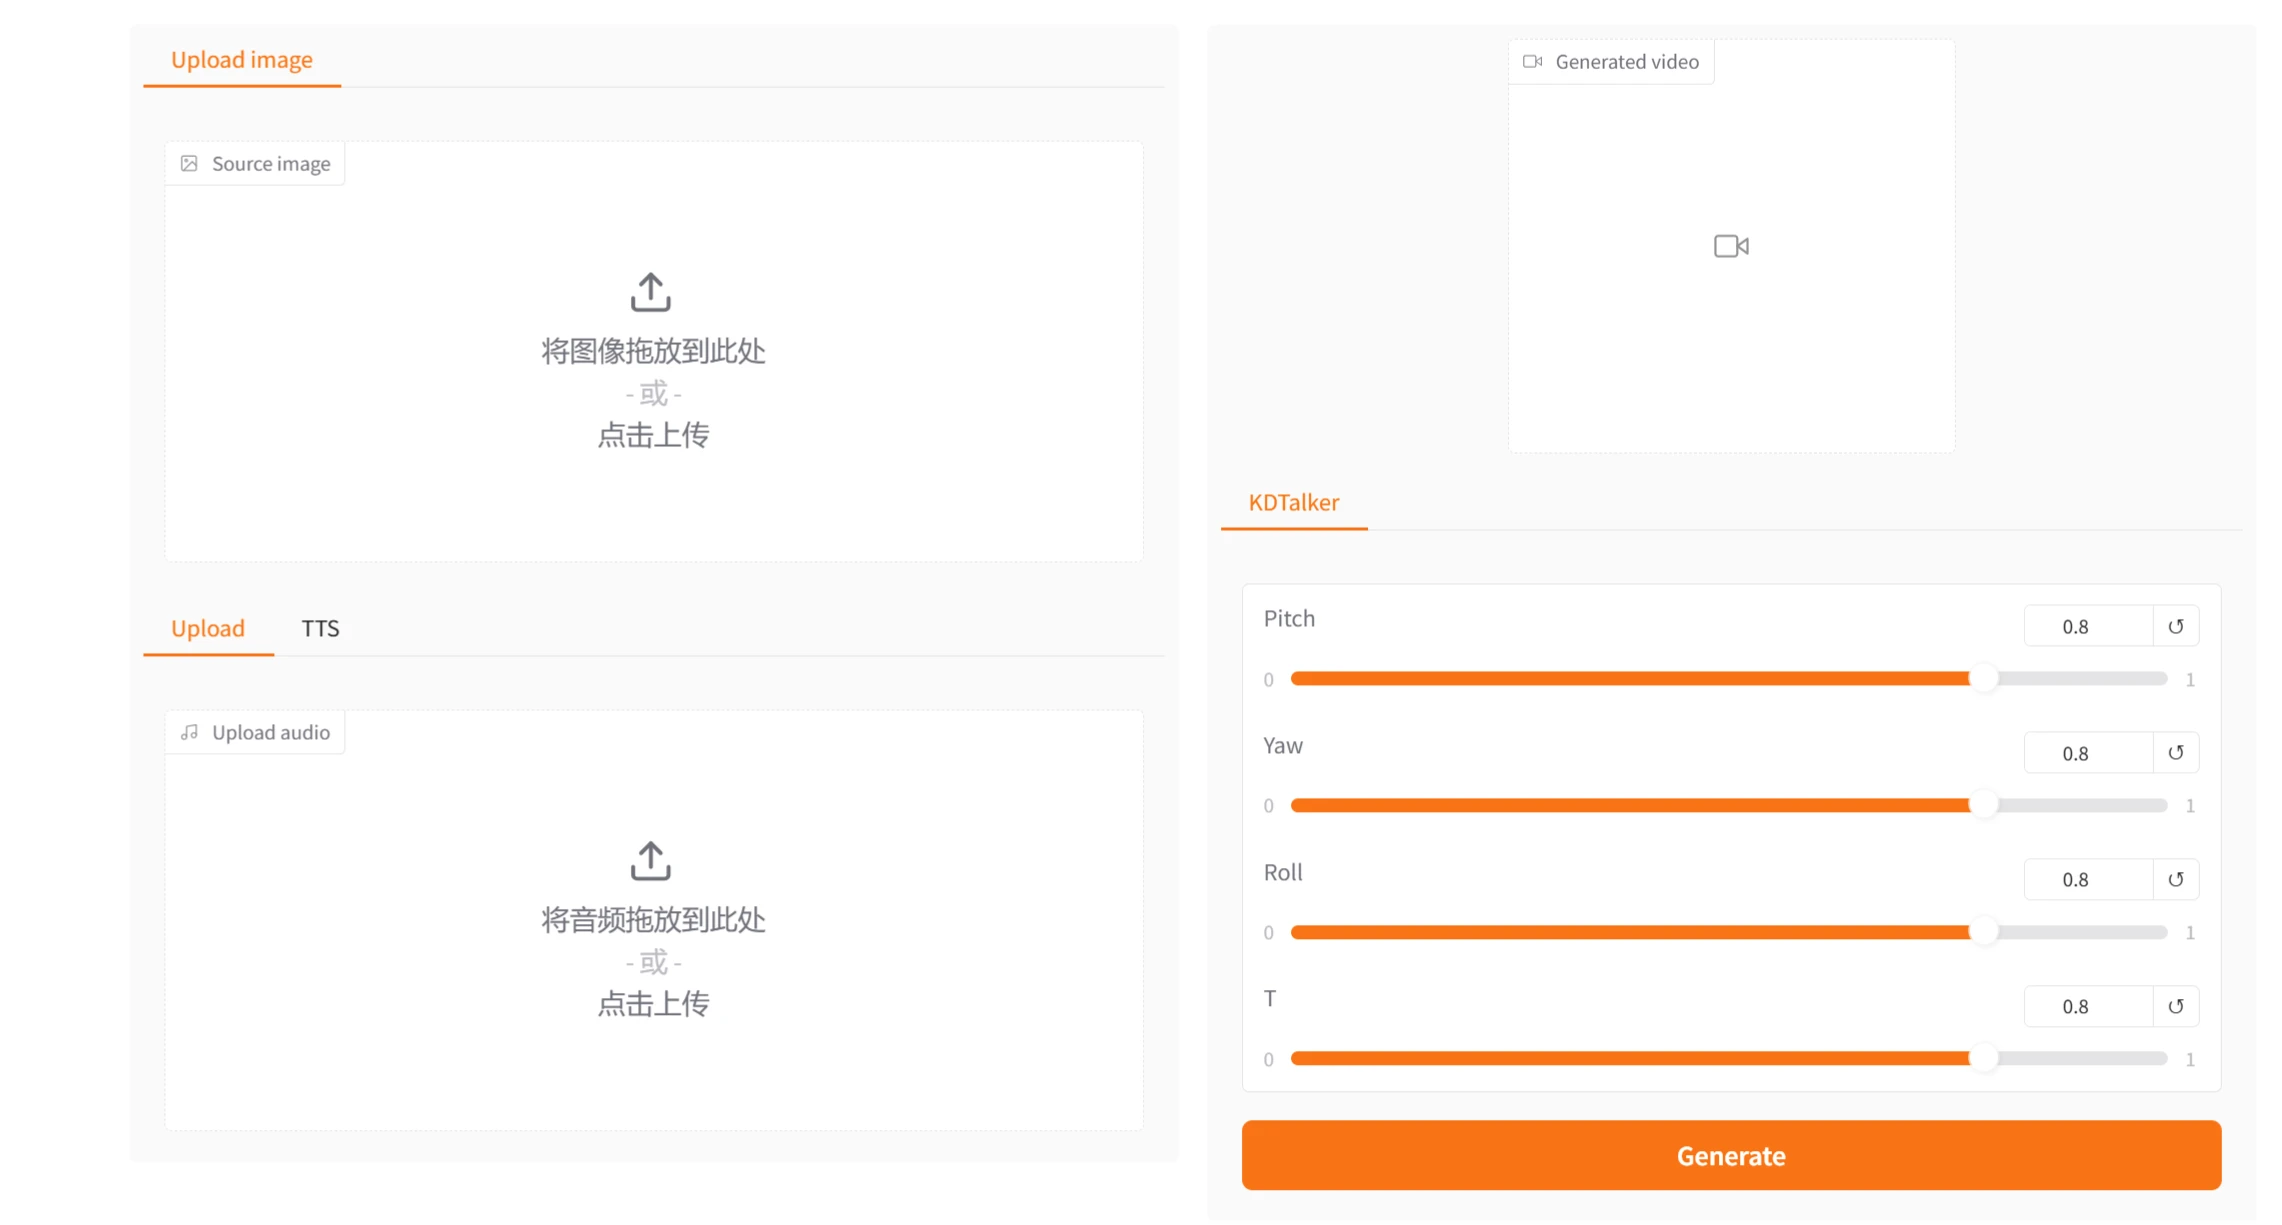
KDTalker 기능 특징
암시적 키포인트 기술:
암시적 키포인트를 활용하여 표정과 미세한 동작 변화를 포착하며, 오디오와 얼굴 동작 간의 관계를 보다 자연스럽게 반영할 수 있습니다.
기존의 명시적 키포인트 방식과 비교하여, 암시적 키포인트는 명시적 주석의 복잡성과 오차를 피할 수 있습니다.
시공간 확산 모델:
시공간 확산 모델을 결합하여 보다 부드럽고 일관된 동적 효과를 생성함과 동시에 이미지의 품질과 안정성을 유지합니다.
시공간 확산 모델을 통해 비디오 시퀀스의 시간적 연속성을 더 잘 처리할 수 있습니다.
다양한 포즈 지원:
다양한 포즈 생성을 지원하며, 오디오 내용에 따라 인물의 자세를 동적으로 조정하여 생성 결과의 다양성과 자연스러움을 높입니다.
사용자는 서로 다른 포즈 스타일을 지정하여 보다 개인화된 동적 포트레이트를 생성할 수 있습니다.
고효율성:
최적화된 모델 설계와 효율적인 연산 흐름을 통해, 단일 RTX4090 또는 RTX3090 GPU에서도 실행 가능하여 뛰어난 실용성과 확장성을 제공합니다.
고품질 생성:
생성된 동적 포트레이트는 높은 해상도와 사실감을 갖추고 있어 고품질 비디오 생성 요구 사항을 충족할 수 있습니다.
사전 학습된 모델과 최적화된 추론 과정을 통해 생성 결과의 안정성과 일관성을 보장합니다.
KDTalker 적용 시나리오
가상 현실(VR) 및 증강 현실(AR):
VR 및 AR 애플리케이션에서 KDTalker는 사실적인 가상 캐릭터의 동적 포트레이트를 생성하여 사용자 경험을 향상시킬 수 있습니다.
예를 들어, 가상 회의에서 사용자는 오디오를 통해 자신의 동적 포트레이트를 생성하여 원격 커뮤니케이션을 보다 자연스럽게 만들 수 있습니다.
소셜 미디어 및 비디오 콘텐츠 제작:
사용자는 자신의 사진과 오디오를 KDTalker에 입력하여 소셜 미디어에 공유할 수 있는 개인화된 동적 포트레이트 비디오를 생성할 수 있습니다.
콘텐츠 제작자는 이 기술을 활용하여 흥미로운 비디오 콘텐츠를 제작하고 비디오의 매력을 높일 수 있습니다.
비디오 회의:
비디오 회의에서 불안정한 네트워크로 인해 비디오가 끊기거나 흐릿해질 수 있습니다. KDTalker는 오디오를 기반으로 부드러운 동적 포트레이트를 생성할 수 있어, 낮은 대역폭 환경에서도 양호한 시각 효과를 유지합니다.
엔터테인먼트 및 게임:
게임 및 엔터테인먼트 애플리케이션에서 KDTalker는 가상 캐릭터의 동적 표정과 동작을 생성하여 게임의 몰입감을 높일 수 있습니다.
예를 들어, 롤플레잉 게임에서 플레이어는 오디오를 통해 자신의 캐릭터 동적 포트레이트를 생성할 수 있습니다.
교육 및 훈련:
교육 및 훈련 시나리오에서 KDTalker는 교사나 훈련사의 동적 포트레이트를 생성하여 온라인 강의 또는 훈련 비디오에 활용할 수 있습니다.
오디오 기반 동적 포트레이트를 통해 교육 내용을 더욱 생동감 있게 만들어 학습 효과를 높일 수 있습니다.
KDTalker 사용 방법
1. 환경 준비
하드웨어 요구 사항:RTX4090 또는 RTX3090 GPU 사용을 권장합니다.
소프트웨어 종속성:
git, conda, FFmpeg 설치.
git clone https://github.com/chaolongy/KDTalker
cd KDTalker
# conda 환경 생성 및 활성화
conda create -n KDTalker python=3.9
conda activate KDTalker
# PyTorch 및 기타 종속성 설치
conda install pytorch==2.3.0 torchvision==0.18.0 torchaudio==2.3.0 pytorch-cuda=11.8 -c pytorch -c nvidia
pip install -r requirements.txt
git clone https://github.com/chaolongy/KDTalker
cd KDTalker
# 创建并激活conda环境
conda create -n KDTalker python=3.9
conda activate KDTalker
# 安装PyTorch和其他依赖
conda install pytorch==2.3.0 torchvision==0.18.0 torchaudio==2.3.0 pytorch-cuda=11.8 -c pytorch -c nvidia
pip install -r requirements.txt
2. 사전 학습된 가중치 다운로드
Google Drive 또는 Hugging Face에서 사전 학습된 가중치 파일을 다운로드하여 ./pretrained_weights 및 ./ckpts 디렉터리에 배치합니다.
디렉터리 구조가 다음과 같은지 확인합니다:
pretrained_weights
├── insightface
│   └── models
│       └── buffalo_l
│           ├── 2d106det.onnx
│           └── det_10g.onnx
└── liveportrait
    ├── base_models
    │   ├── appearance_feature_extractor.pth
    │   ├── motion_extractor.pth
    │   ├── spade_generator.pth
    │   └── warping_module.pth
    ├── landmark.onnx
    └── retargeting_models
        └── stitching_retargeting_module.pth
3. 추론 실행
다음 명령을 사용하여 추론 스크립트를 실행하고 동적 포트레이트 비디오를 생성합니다:
python inference.py -source_image ./example/source_image/WDA_BenCardin1_000.png -driven_audio ./example/driven_audio/WDA_BenCardin1_000.wav -output ./results/output.mp4
-source_image: 입력할 소스 이미지 경로를 지정합니다.
-driven_audio: 입력할 드라이빙 오디오 경로를 지정합니다.
-output: 출력 비디오의 저장 경로를 지정합니다.
프로젝트 주소:https://github.com/chaolongy/KDTalker
DEMO:https://kdtalker.com/









