
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
OpenAI, 새로운 음성 모델 3종 공개—STT 2종과 TTS 1종
小编 ·

OpenAI, 새로운 음성 모델 3종 공개—STT 2종과 TTS 1종
2025년 3월 20일, Openai는 세 가지全新的 음성 모델을 발표했습니다. 여기에는 두 가지 음성-텍스트 변환 모델(GPT-4o-transcribe 및 GPT-4o-mini-transcribe)과 하나의 텍스트-음성 변환 모델(GPT-4o-mini-tts)이 포함됩니다.
음성-텍스트 변환 모델
GPT-4o-transcribe: 이 모델은 다양하고 고품질의 오디오 데이터셋으로 장기간 학습되어 음성의 미묘한 차이를 더 잘 포착하고 오인식을 줄이며 전사 신뢰성을 크게 향상시킵니다. 다양한 억양, 시끄러운 환경, 속도 변화 등 복잡한 시나리오 처리(예: 고객 콜센터 및 회의 기록 전사 등 분야)에 적합합니다.
GPT-4o-mini-transcribe: 이는 GPT-4o-transcribe의 경량화 버전으로, 속도가 더 빠르고 효율적입니다. 단어 오류율(WER)이 전체 버전 모델보다 약간 높지만, 여전히 기존의 Whisper 모델보다 우수하여, 자원이 제한적이지만 고품질 음성 인식을 필요로 하는 애플리케이션 시나리오에 더 적합합니다.
텍스트-음성 변환 모델
GPT-4o-mini-tts: 이 모델은 최초로 「안내성(steerability)」을 지원하여, 개발자는 모델이 「무엇을 말할지」 지정할 뿐만 아니라 「어떻게 말할지」도 제어할 수 있습니다. 예를 들어 음성 스타일을 「차분한」「서퍼의」「전문적인」「중세 기사」 등으로 사전 설정할 수 있을 뿐 아니라, 지시에 따라 음성 스타일을 조정할 수도 있습니다. 예: 「동정심 있는 고객 서비스 Agent처럼 말하기」.
기술 혁신
실제 오디오 데이터셋을 사용한 사전 학습을 통해 모델 성능을 최적화합니다.
향상된 증류(distillation) 방법으로 대모델에서 소모델로의 지식 전이를 구현합니다.
강화 학습을 통해 전사 정확도를 높이고 「환각」 현상을 줄입니다.
활용 시나리오
콜센터: 더 정확한 음성 인식과 더 자연스러운 음성 합성을 제공하여 고객 서비스 경험을 향상시킵니다.
회의 기록: 회의 음성 콘텐츠를 빠르고 정확하게 텍스트로 전사합니다.
맞춤형 고객 서비스: 음성 스타일의 맞춤화를 통해 더 따뜻하고 표현력이 풍부한 음성 경험을 제공합니다.
창의적 이야기 전달: 이야기에 생생한 음성 효과를 더합니다.
가격 정책
GPT-4o-transcribe의 가격은 이전 Whisper 모델과 동일한 분당 0.006달러입니다.
GPT-4o-mini-transcribe의 가격은 분당 0.003달러입니다.
GPT-4o-mini-tts의 가격은 분당 1센트입니다.
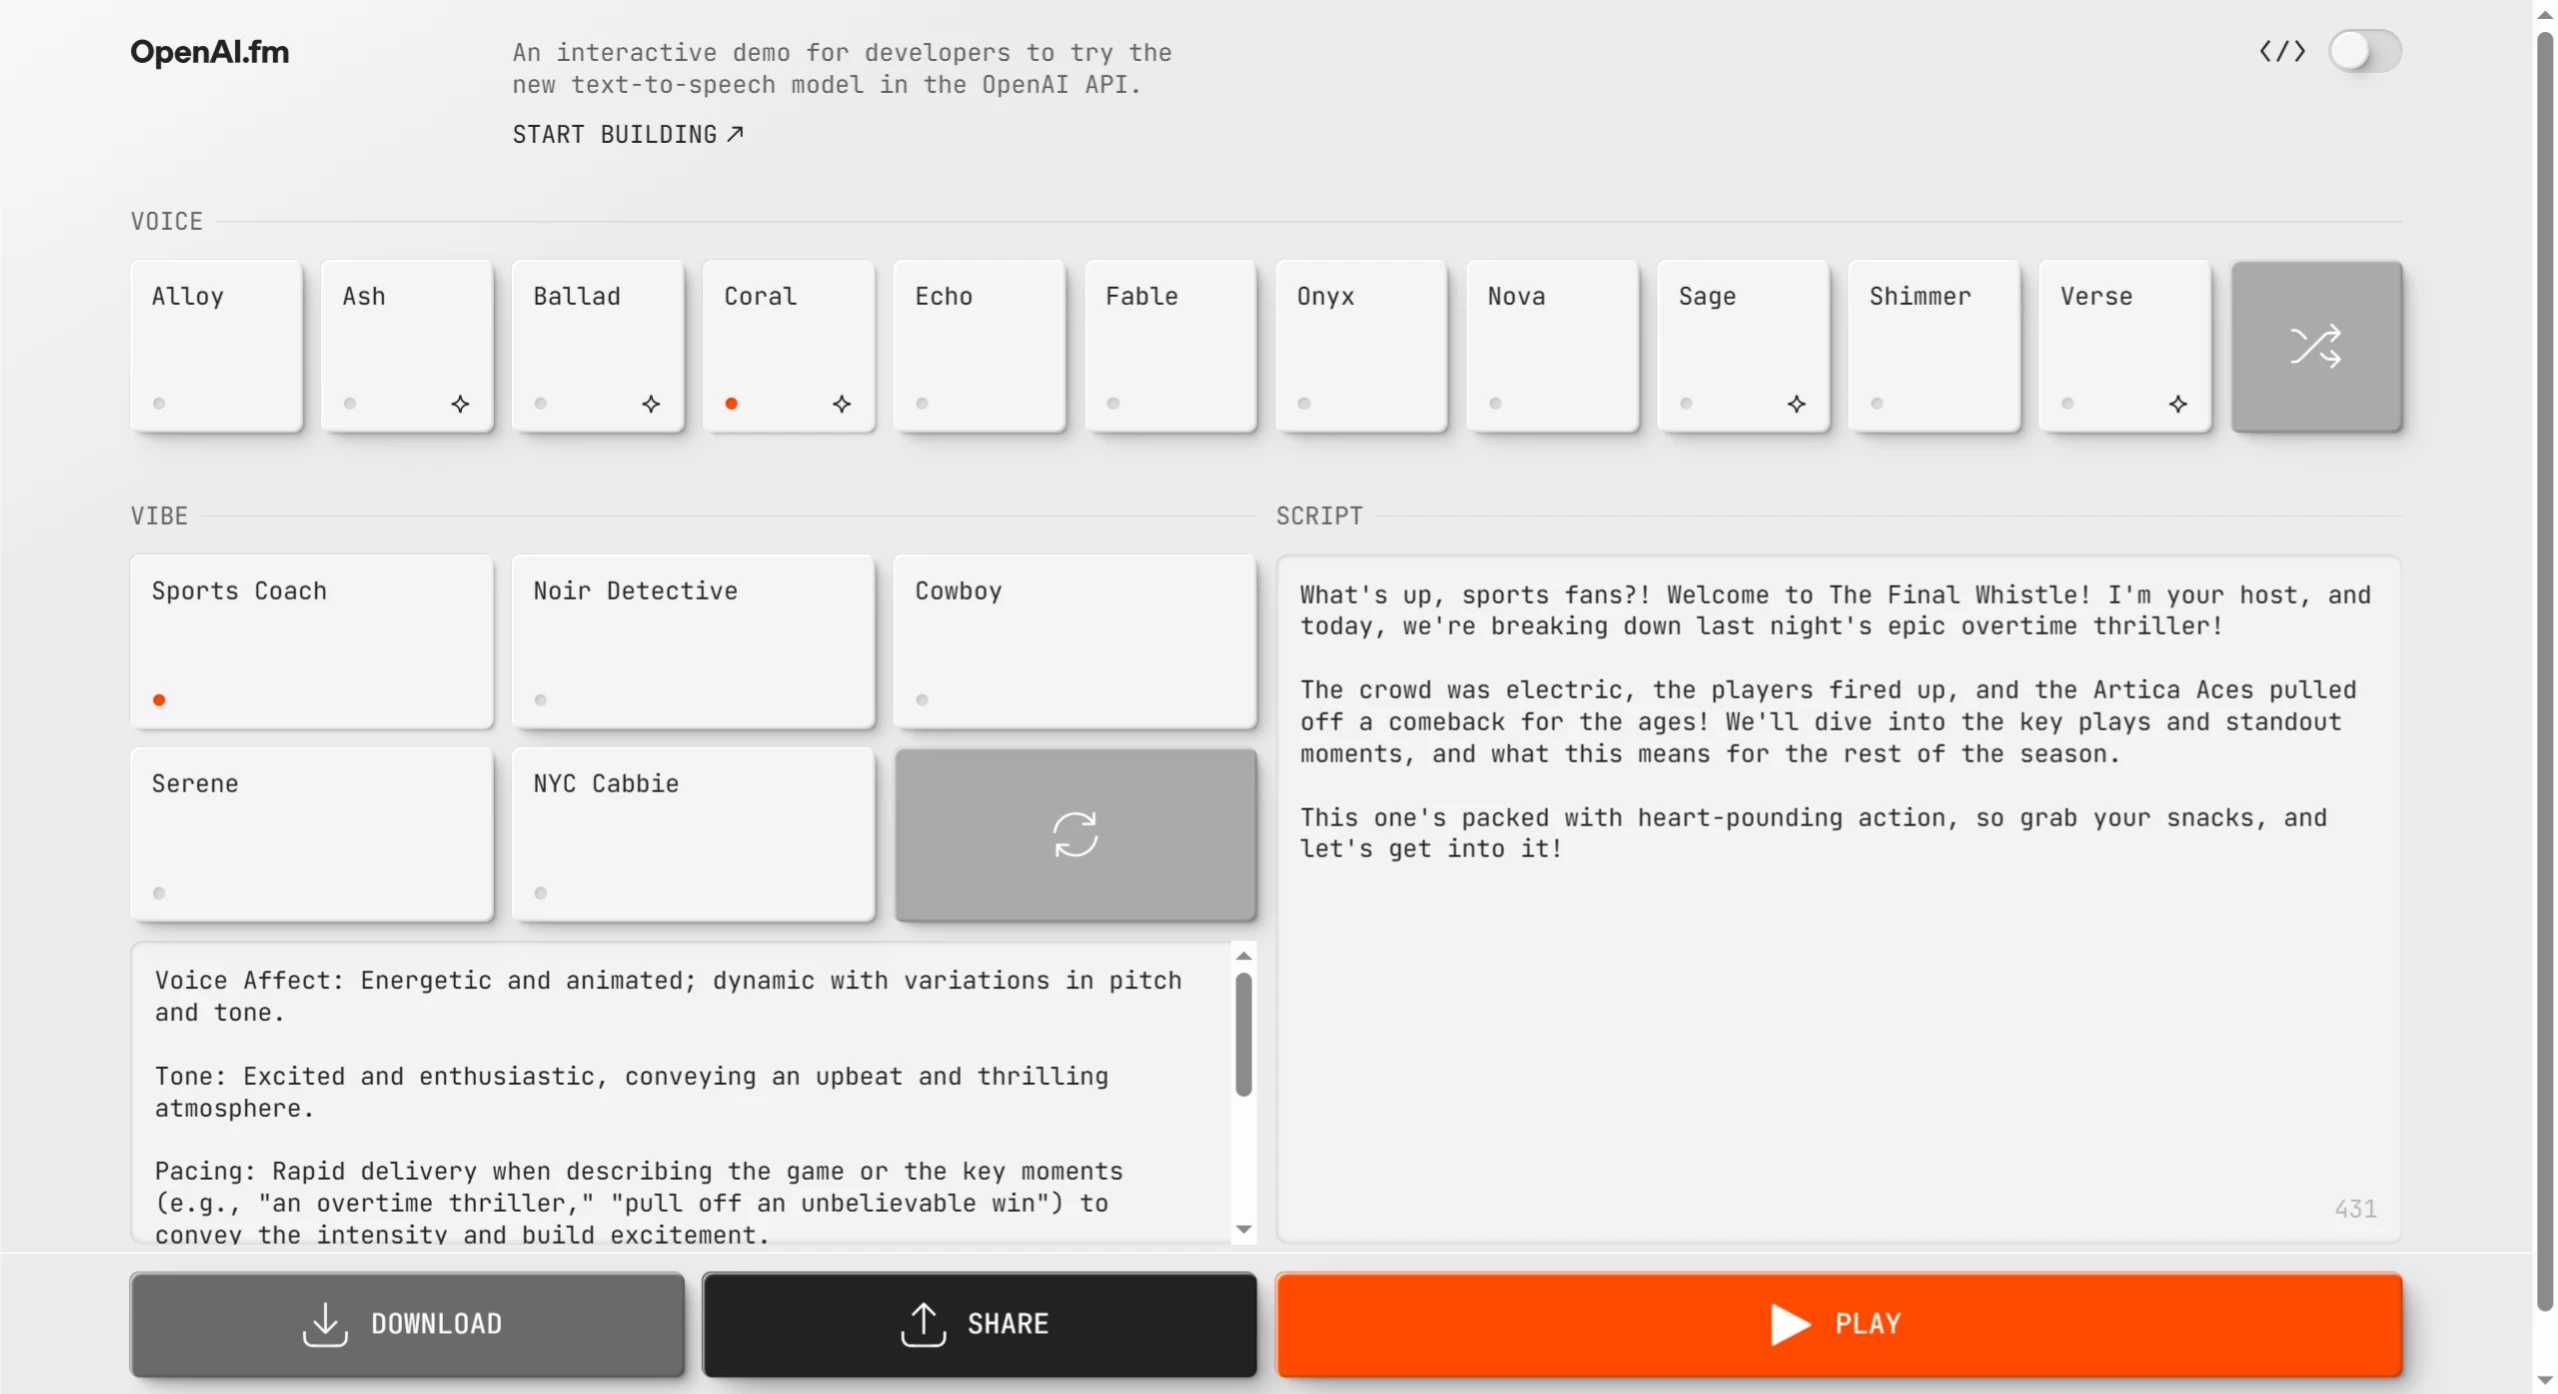
OpenAI 음성 모델 웹사이트: OpenAI.fm. 웹사이트에서는 페르소나, 어조, 방언, 발음 등 다양한 사전 설정 템플릿을 제공합니다. 사용자는 여기에서 GPT-4o-mini-tts 관련 오디오를 체험하고 제작할 수 있습니다. 또한 OpenAI는 업그레이드된 Agent SDK를 제공하여 개발자가 더욱 편리하게 음성 지능형 에이전트를 구축할 수 있도록 지원합니다.
공식 웹사이트:http://openai.fm/
공식 블로그:https://openai.com/index/introducing-our-next-generation-audio-models/









