
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
Step-Video-TI2V: StepFun이 오픈소스로 공개한 AI 텍스트-비디오 및 이미지-비디오 생성 모델
小编 ·

Step-Video-TI2V: StepFun이 오픈소스로 공개한 AI 텍스트-비디오 및 이미지-비디오 생성 모델
Step-Video-TI2V란 무엇인가
Step-Video-TI2V는 계단별성선(Stepfun) 팀이 오픈소스로 공개한 텍스트 기반의 AI 이미지 투 비디오 모델로, 사용자가 입력한 텍스트 프롬프트와 이미지에 따라 고품질 비디오를 생성할 수 있습니다. 애니메이션 스타일 비디오 생성에서 뛰어난 성능을 보이며, 모션 제어, 다국어 입력 및 다양한 비디오 형식 출력을 지원합니다.
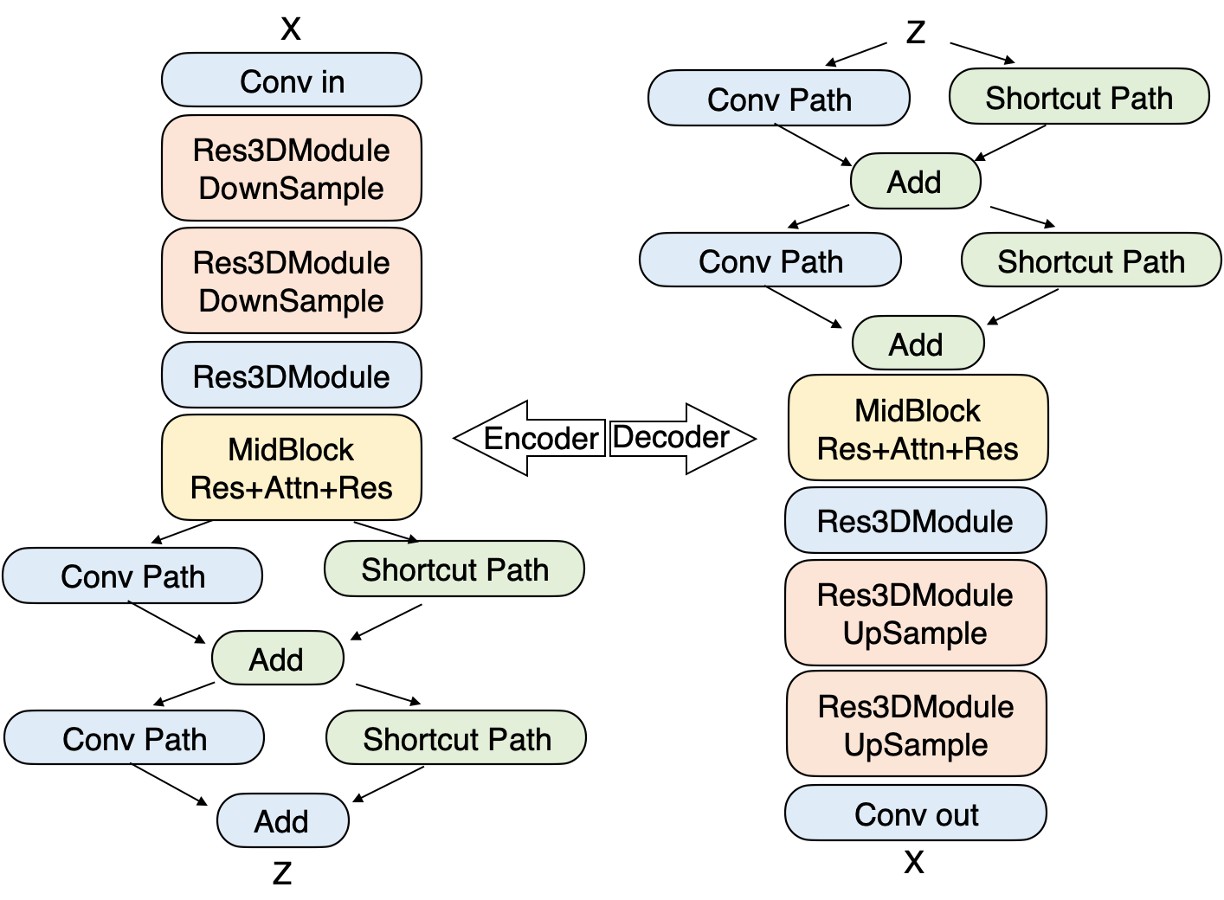
Step-Video-TI2V 기능
텍스트 기반의 이미지 투 비디오: 사용자가 제공하는 텍스트 프롬프트와 입력 이미지에 따라 텍스트 및 이미지 내용과 높은 일치도를 가진 비디오를 생성합니다.
모션 제어: 사용자는 다양한 모션 레벨을 지정하여 비디오의 동적幅度를 정밀하게 제어하고, 동적 효과와 안정성 사이의 균형을 맞출 수 있습니다.
고품질 비디오 출력: 102프레임, 5초, 540P 해상도의 비디오를 생성할 수 있으며, 다양한 비디오 화면 비율(가로, 세로, 정사각형)을 지원합니다.
다국어 지원: 중국어와 영어 입력을 지원하여 다양한 언어 배경의 사용자가 편리하게 사용할 수 있습니다.
지시문 준수 및 내용 일관성: 지시문 준수, 주제 및 배경 일관성, 물리 법칙 준수 등에서 뛰어난 성능을 보이며, 생성된 비디오 내용이 사용자의 기대에 부합합니다.
벤치마크 테스트 지원: 178개의 실제 프롬프트-이미지 쌍과 120개의 애니메이션 스타일 프롬프트-이미지 쌍을 포함하는 Step-Video-TI2V-eval 벤치마크 데이터셋을 개발하여 모델 성능 평가에 사용됩니다.
Step-Video-TI2V 활용 사례
콘텐츠 제작: 비디오 크리에이터에게 영감과 소재를 제공하여 비디오 콘텐츠를 빠르게 생성하고 시간과 노력을 절약합니다.
애니메이션 제작: 애니메이션 스타일 비디오 생성에서 뛰어난 성능을 보이며, 애니메이션 캐릭터의 동작演示, 장면 애니메이션 등에 사용될 수 있습니다.
광고 및 마케팅: 매력적인 비디오 광고를 생성하여 제품이나 서비스의 특징과 장점을 보여줍니다.
교육 및 훈련: 교육용 비디오를 제작하여 학생들이 지식을 더 잘 이해하고 기억하도록 돕습니다.
엔터테인먼트 및 소셜 미디어: 사용자에게 재미있는 비디오 생성 경험을 제공하여 소셜 미디어에 공유하고 상호작용성과 재미를 높입니다.
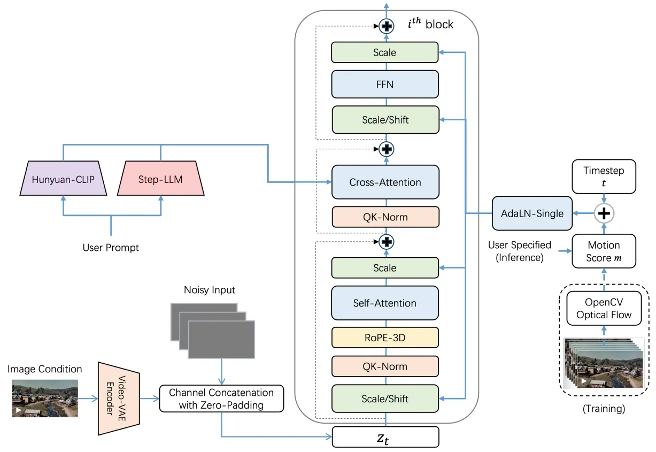
Step-Video-TI2V 설치 및 사용
설치
1. 환경 요구 사항: Python 3.8 이상 버전 및 CUDA 11.3 이상 버전(GPU 가속용)이 필요합니다.
2. 의존성 설치: 다음 명령을 통해 필요한 Python 패키지를 설치합니다:
pip install -r requirements.txt
3. 모델 다운로드: Hugging Face 또는 Modelscope에서 모델 파일을 다운로드하여 지정된 디렉터리에 배치합니다.
사용
1. 입력 데이터 준비: 입력 이미지와 텍스트 프롬프트를 준비하되, 텍스트 프롬프트가 입력 이미지 내용과 관련되도록 합니다.
2. 코드 실행: 다음 명령을 사용하여 모델을 실행하여 비디오를 생성합니다:
python generate_video.py --image_path --text_prompt "" --output_path
3. 파라미터 조정: 필요에 따라 모션 제어 파라미터(예: 모션幅度) 및 기타 생성 파라미터를 조정하여 이상적인 비디오 효과를 얻습니다.
관련 링크
GitHub 코드 저장소:https://github.com/stepfun-ai/Step-Video-TI2V
Hugging Face 모델 페이지:https://huggingface.co/stepfun-ai/stepvideo-t2v
Modelscope 모델 페이지:https://modelscope.cn/models/stepfun-ai/stepvideo-ti2v
Github-ComfyUI:https://github.com/stepfun-ai/ComfyUI-StepVideo
논문:https://arxiv.org/abs/2503.08334









