
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
츠이투(赤兎) Chitu: 칭화대학교 팀이 오픈소스로 공개한 고성능 LLM 추론 프레임워크
小编 ·

츠이투(赤兎) Chitu: 칭화대학교 팀이 오픈소스로 공개한 고성능 LLM 추론 프레임워크
赤兔(Chitu)란 무엇인가요?
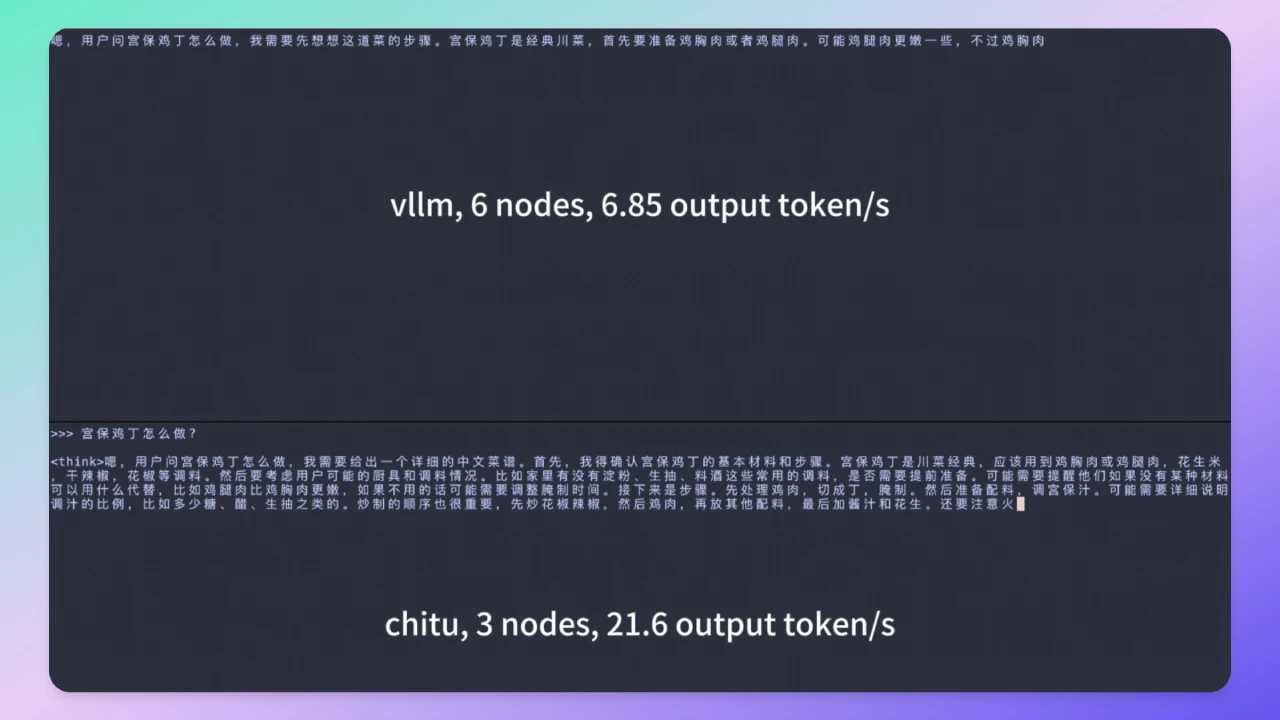
赤兔(Chitu)는 칭화대학교(淸華大學) 팀이 오픈소스로 공개한 고성능 대규모 언어 모델 추론 프레임워크로, 추론 효율성을 높이고 비용을 절감하며 다양한 하드웨어 플랫폼과 배포 시나리오를 지원하는 데 중점을 둡니다. 이를 통해 DeepSeek 추론 비용을 절반으로 줄이면서 성능을 두 배로 높일 수 있습니다. 赤兔(Chitu)의 목표는 기업과 개발자에게 고효율, 유연하며 손쉽게 배포할 수 있는 추론 엔진을 제공하여 대규모 언어 모델(LLM)의 실제 적용을 가속화하는 것입니다.
赤兔(Chitu) 기능 특징
다양한 연산력适配(적합): NVIDIA 최신 플래그십 모델부터 구형 모델까지 다양한 제품군을 지원하며, 국산 칩에도 최적화된 지원을 제공합니다.
전 시나리오 확장 가능: 순수 CPU 배포, 단일 GPU 배포부터 대규모 클러스터 배포까지 유연한 확장 솔루션을 제공합니다.
장기 안정 운영: 실제 운영 환경에 적합하며 동시성 트래픽을 안정적으로 처리할 수 있습니다.
고효율 추론 성능: A800 클러스터 테스트에서 일부 해외 오픈소스 프레임워크와 비교했을 때 GPU 사용량을 50% 줄인 상태에서 추론 속도가 3.15배 향상되었습니다.
비용 절감: 하드웨어 자원 사용을 최적화하여 기업 ai 모델 배포의 진입 장벽과 비용을 낮춥니다.
赤兔(Chitu) 적용 시나리오
엔터프라이즈급 AI 애플리케이션: 고성능, 낮은 지연 시간, 높은 처리량을 요구하는 추론 서비스.
대규모 클러스터 배포: 다중 GPU 또는 다중 노드 환경에서 효율적으로 운영해야 하는 시나리오.
자원 제한 환경: 제한된 하드웨어 자원에서 고효율 추론을 구현해야 하는 시나리오.
국산 칩 适配(적합): 국산 하드웨어 플랫폼에서 대규모 언어 모델을 실행해야 하는 시나리오.
赤兔(Chitu) 사용 방법
1. 소스코드 설치
git clone --recursive https://github.com/thu-pacman/chitu && cd chitu
pip install -r requirements-build.txt
pip install -U torch --index-url https://download.pytorch.org/whl/cu124  # 根据 CUDA 版本调整
TORCH_CUDA_ARCH_LIST=8.6 CHITU_SETUP_JOBS=4 MAX_JOBS=4 pip install --no-build-isolation
2. 단일 GPU 추론
torchrun --nproc_per_node 8 test/single_req_test.py request.max_new_tokens=64 models=DeepSeek-R1 models.ckpt_dir=/data/DeepSeek-R1 infer.pp_size=1 infer.tp_size=8
3. 하이브리드 병렬 (TP+PP)
torchrun --nnodes 2 --nproc_per_node 8 test/single_req_test.py request.max_new_tokens=64 infer.pp_size=2 infer.tp_size=8 models=DeepSeek-R1 models.ckpt_dir=/data/DeepSeek-R1
4. 서비스 시작
export WORLD_SIZE=8
torchrun --nnodes 1 \
--nproc_per_node 8 \
--master_port=22525 \
example/serve.py \
serve.port=21002 \
infer.stop_with_eos=False \
infer.cache_type=paged \
infer.pp_size=1 \
infer.tp_size=8 \
models=DeepSeek-R1 \
models.ckpt_dir=/data/DeepSeek-R1 \
keep_dtype_in_checkpoint=True \
infer.mla_absorb=absorb-without-precomp \
infer.soft_fp8=True \
infer.do_load=True \
infer.max_reqs=1 \
scheduler.prefill_first.num_tasks=100 \
infer.max_seq_len=4096 \
request.max_new_tokens=100 \
infer.use_cuda_graph=True
5. 성능 테스트
python benchmarks/benchmark_serving.py \
--model "deepseek-r1" \
--iterations 10 \
--seq-len 10 \
--warmup 3 \
--base-url http://localhost:21002
GitHub 저장소:https://github.com/thu-pacman/chitu









