
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
VACE: 알리바바 통이 Wan 팀이推出的 비디오 생성 및 편집 통합 모델
小编 ·

VACE: 알리바바 통이 Wan 팀이推出的 비디오 생성 및 편집 통합 모델
VACE란 무엇인가요?
VACE(Video Creation and Editing)는 알리바바 통의 실험실에서 출시한 원스톱 ai동영상 생성 및 편집 통합 모델로, 통합된 모델 아키텍처를 통해 다양한 동영상 창작 및 편집 작업을 구현할 수 있습니다. 텍스트나 이미지 한 단편으로 동영상을 생성할 수 있을 뿐만 아니라, 기존 동영상에 대해 스타일 변환, 복원 또는 확장도 수행할 수 있습니다. 여러 기능을 하나의 모델에 통합하여 사용이 편리하며, 창의적인 동영상 제작이나 오래된 동영상 복원에 적합합니다.
VACE 핵심 기능
텍스트-동영상 생성: 텍스트 프롬프트에 따라 동영상을 생성합니다.
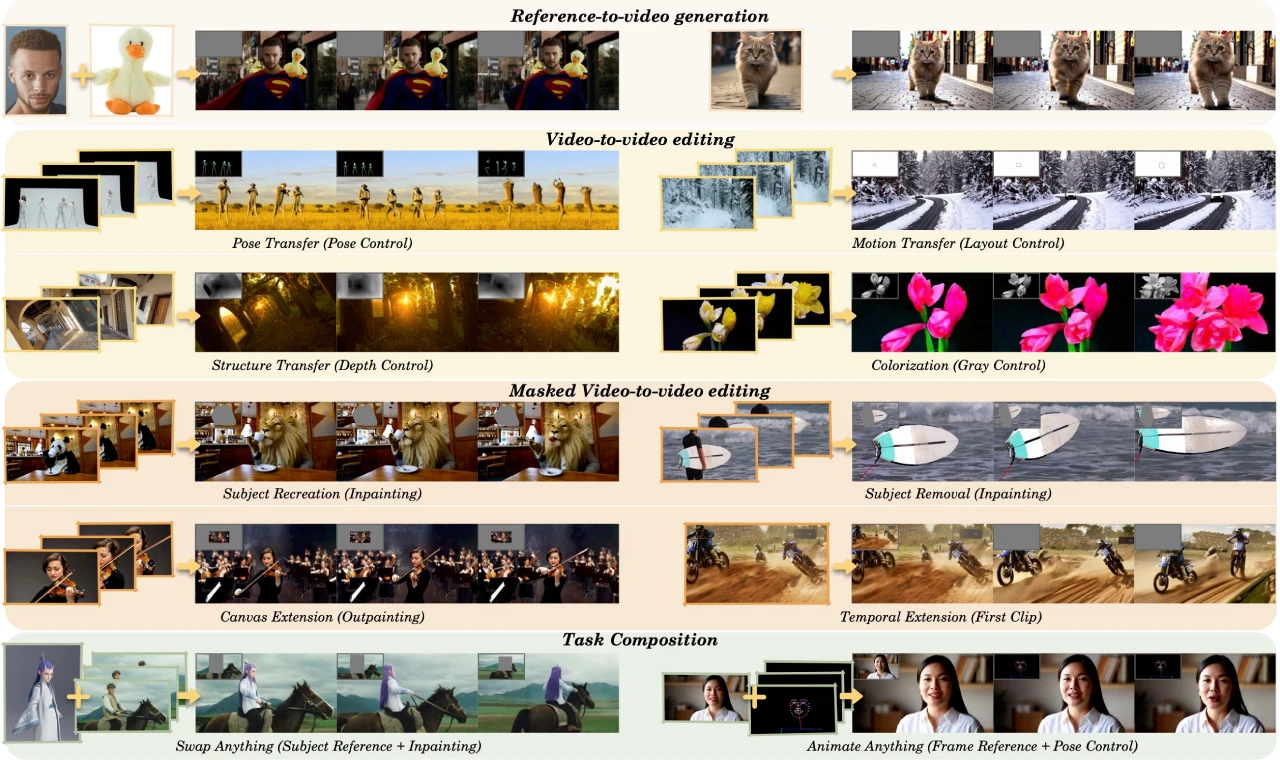
참조-동영상 생성: 텍스트와 참조 이미지를 결합하여 동영상을 생성합니다.
동영상 확장: 기존 동영상 클립을 기반으로 새로운 시작 부분이나 끝부분을 생성합니다.
동영상 편집:
동영상-동영상 편집: 입력된 동영상에 대해 전체적인 스타일 변환을 수행합니다(예: 컬러화, 스타일화).
마스크 동영상 편집: 지정된 영역에서 편집을 수행합니다(예: 인페인팅(Inpainting), 아웃페인팅(Outpainting)).
주제 제거 및 재구성: 동영상 내 특정 주제를 제거하고 배경을 채웁니다.
작업 조합:
참조 생성 + 주체 교체, 자세 제어 + 동영상 확장 등 다양한 작업의 유연한 조합을 지원합니다.
VACE 기술 원리
Video Condition Unit(VCU): 텍스트, 이미지, 동영상, 마스크 등 다양한 모달 입력을 통합된 조건 단위로 통합하여, 다양한 작업의 유연한 조합을 지원합니다.
Context Adapter 구조: 시간 및 공간 차원의 형식화된 표현을 통해 다양한 작업의 개념을 모델에 주입하여, 다양한 작업 요구에 적응할 수 있도록 합니다.
확산 모델: Diffusion Transformer와 같은 확산 모델을 기반으로 구축되었으며, 점진적인 노이즈 제거 방식을 통해 고품질의 동영상 콘텐츠를 생성합니다.
VACE 장점
통합 프레임워크: 동영상 생성 및 편집 작업을 하나의 모델로 통합하여 작업 전환의 복잡성을 줄였습니다.
고효율성: 다양한 작업에서 특정 작업 모델과 동등한 성능을 달성합니다.
다양성: 다양한 작업 조합을 지원하여 동영상 콘텐츠 창작에 더 폭넓은 활용 가능성을 제공합니다.
VACE 활용 시나리오
창의적 동영상 생성: 텍스트나 이미지를 기반으로 광고, 애니메이션 등 창의적인 동영상 콘텐츠를 빠르게 생성합니다.
동영상 복원 및 강화: 오래된 동영상을 복원하고, 빠진 화면 부분을 채우거나 동영상 스타일을 향상시킵니다.
효율적인 동영상 편집: 주체 교체, 애니메이션 추가 등 복잡한 편집 작업을 구현합니다.
동영상 확장: 짧은 동영상에 새로운 클립을 생성하여 동영상 콘텐츠를 연장합니다.
인터랙티브 동영상 창작: 사용자 입력(예: 자세, 스케치)에 따라 개인화된 동영상을 생성합니다.
프로젝트 리소스
프로젝트 공식 웹사이트:https://ali-vilab.github.io/VACE-Page/
GitHub 저장소:https://github.com/ali-vilab/VACE
기술 논문:https://arxiv.org/pdf/2503.07598









