
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
MMStoryAgent: 상하이 자오퉁대와 알리바바가 공개한 오픈소스 멀티모달 AI 스토리 생성 시스템
小编 ·

MMStoryAgent: 상하이 자오퉁대와 알리바바가 공개한 오픈소스 멀티모달 AI 스토리 생성 시스템
MM-StoryAgent란 무엇인가요?
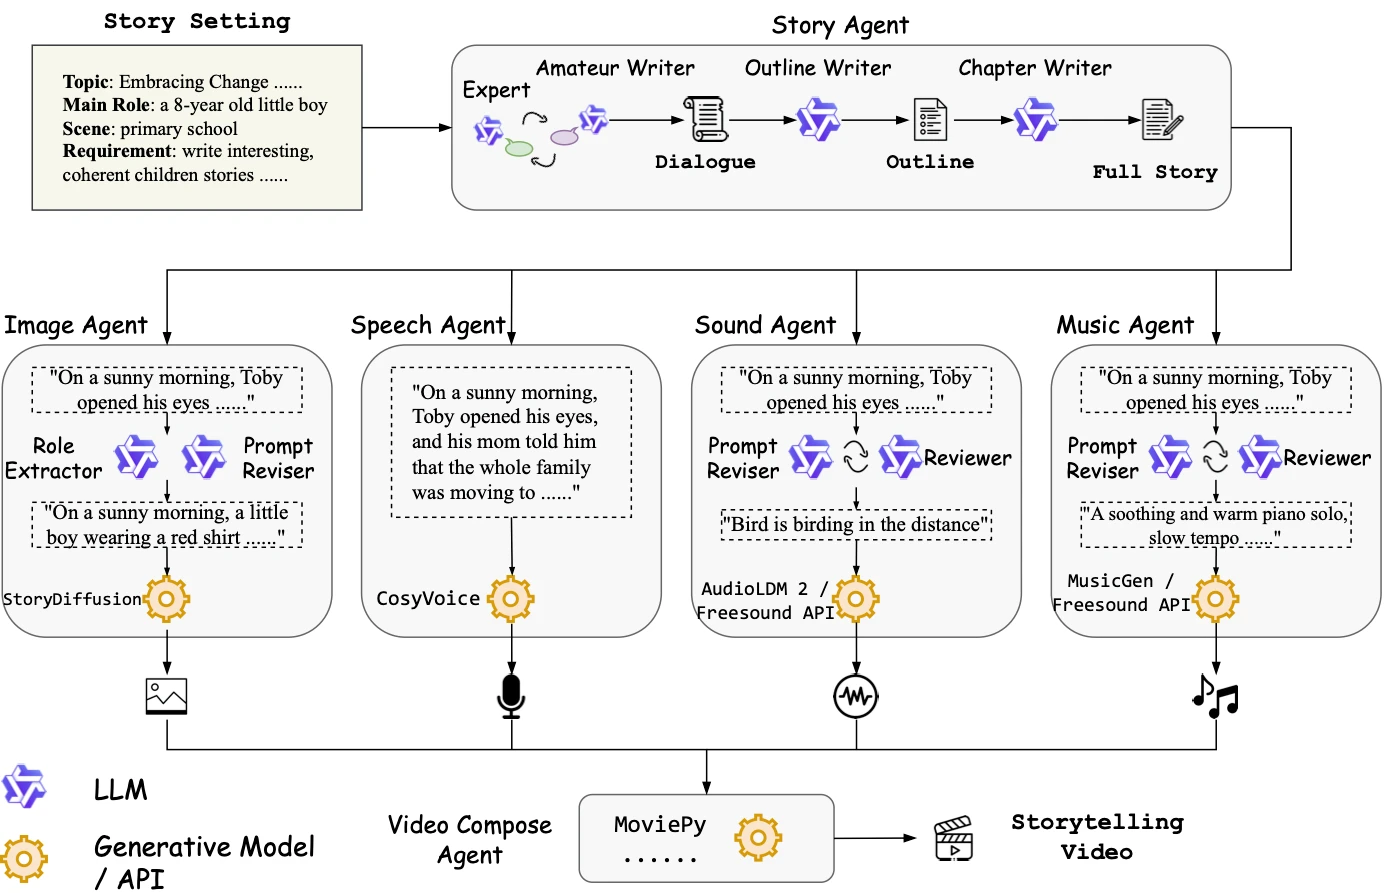
MM-StoryAgent는 상하이 자오퉁대학교와 알리바바가 오픈소스로 공개한 AI 멀티모달 스토리 생성 시스템으로, 멀티 에이전트 패러다임을 채택하여 몰입형의 유튜브 동화책 영상을 생성할 수 있습니다. 텍스트, 이미지, 오디오 등 다양한 요소를 융합하고, 대규모 언어 모델과 일부 전문 도구를 활용하여 텍스트, 이미지, 멀티채널 오디오(내레이션, 효과음, 배경음악)를 포함하는 스토리 영상을 자동 생성하며, 이는 어린이 동화의 빠른 제작에 활용될 수 있습니다.
MM-StoryAgent 기능 특징
고품질 스토리 창작: 입력된 스토리 설정을 바탕으로 다중 에이전트, 다단계 프로세스를 통해 스토리를 창작합니다. 상향식으로 초안을构思하고 하향식으로 소재를 생성하는 방식으로 수동 개입, 장면 연출 및 서사 일관성 문제를 해결합니다.
멀티모달 콘텐츠 생성: 텍스트, 이미지, 음성, 음악 등 모달리티를 결합하여 몰입형 스토리 영상을 생성합니다. 작업을 분해하여 스토리 설계, 스토리보드 생성, 비디오 제작 등을 담당하는 여러 전문 "에이전트"에 할당하여 전문 제작 프로세스를 모방합니다.
맞춤형 워크플로우 지원: 안정적이고 맞춤화가 가능한 워크플로우를 제공하여, 사용자가 설정 파일 등을 통해 에이전트의 동작을 커스터마이징하고 각 컴포넌트의 생성 품질을 높이기 위한 자신만의 전문 도구를 정의할 수 있습니다.
캐릭터 일관성 강화: 생성 과정에서 캐릭터와 주제의 일관성을 중시합니다. 맞춤화된 이미지-비디오 변환 방법과 새로운 스토리보드 생성 프로세스를 채택하여 샷 간의 주체 일관성을 보장합니다.
자동화 및 유연성: 대규모 언어 모델과 전문 도구를 활용하여 간단한 프롬프트를 멀티모달 디지털 스토리로 자동 변환할 수 있으며, 참고 영상 없이도 일관된 콘텐츠를 생성할 수 있습니다.
평가 및 최적화 용이: 스토리 주제 목록과 평가 기준을 제공하여, 사용자가 생성된 스토리의 품질을 평가하고 개선하기 쉽게 합니다.
MM-StoryAgent 핵심 기술
멀티 에이전트 프레임워크 작동 메커니즘: 다단계 글쓰기 프로세스와 다중 에이전트 협업을 통해 스토리를 창작하고, 시각적, 청각적, 서사적 요소를 통합하여全方位 감각적 경험을 제공합니다.
맞춤형 이미지-비디오 변환 방법: LoRA-BE라는 맞춤형 이미지-비디오 변환 방법을 도입하여 샷 내 시간적 일관성을 강화하고 비디오의 시각적 품질을 향상시킵니다.
MM-StoryAgent 사용 방법
소스 코드 획득: MM_StoryAgent의 GitHub 저장소(아래 링크 참조)에 방문하여 소스 코드를 다운로드합니다.
의존성 설치: 프로젝트 문서 설명에 따라 Python 라이브러리 등 필요한 소프트웨어 패키지를 설치합니다.
환경 구성: 개발 환경을 설정하고 의존성이 올바르게 설치되었는지 확인하며, 일부 환경 변수를 구성해야 할 수도 있습니다.
입력 데이터 준비: 스토리 창작에 사용할 스토리 설정, 캐릭터 설명, 장면 정보 등의 데이터를 준비합니다.
생성 프로세스 실행: 제공된 스크립트 또는 명령줄 도구를 사용하여 생성 프로세스를 시작하고, 입력 데이터와 파라미터를 지정하여 스토리를 맞춤화할 수 있습니다.
평가 결과 확인: 비디오 형태의 스토리가 출력된 후 품질과 효과를 확인 및 평가하고, 필요에 따라 조정합니다.
최적화 및 반복: 평가 결과에 따라 입력 데이터 또는 파라미터를 조정하고 생성 프로세스를 다시 실행하여 스토리의 내용과 표현력을 최적화합니다.
GitHub 저장소:https://github.com/X-PLUG/MM_StoryAgent









