
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
OpenManus-RL: LLM 에이전트의 추론 및 의사결정 능력을 향상시키는 오픈소스 프로젝트
小编 ·

OpenManus-RL: LLM 에이전트의 추론 및 의사결정 능력을 향상시키는 오픈소스 프로젝트
OpenManus-RL이란 무엇인가요?
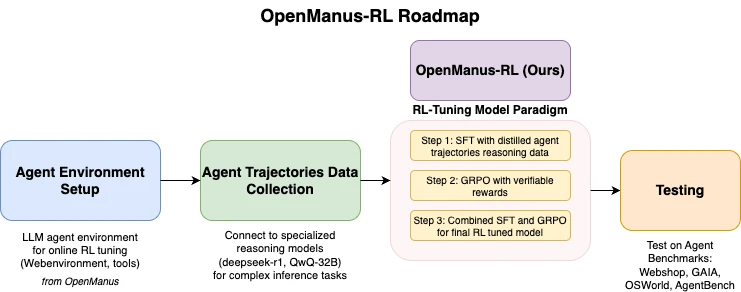
OpenManus-RL은 UIUC-Ulab과 MetaGPT 커뮤니티의 OpenManus 팀이 공동 개발한 오픈소스 프로젝트로, 강화 학습 RL 기술을 통해 대규모 언어 모델 LLM 에이전트의 추론 및 의사 결정 능력을 향상시킬 수 있습니다. 이 프로젝트는 Deepseek-R1, QwQ-32B 등 최첨단 모델의 경험을 바탕으로 복잡한 작업에서 에이전트의 성능을 강화하는 새로운 튜닝 방법을 탐구합니다. OpenManus-RL의 핵심 기능에는 에이전트 환경 구축, 궤적 데이터 수집, 강화 학습 튜닝 지원 및 벤치마크 테스트 통합이 포함됩니다. 또한 Tree-of-Thoughts 및 몬테카를로 트리 탐색(Monte Carlo Tree Search)과 같은 다양한 강화 학습 전략을 통합하여 에이전트의 추론 능력을 향상시킵니다.
OpenManus-RL 기능 특징
에이전트 환경 구축: 온라인 강화 학습(RL) 튜닝을 위한 에이전트 환경 구성 도구를 제공하여 특정 작업을 위한 에이전트 환경을 맞춤 설정할 수 있습니다.
궤적 데이터 수집: Deepseek-R1, QwQ-32B 등 모델에 연결하여 복잡한 작업의 행동 데이터를 수집하고, 후속 튜닝에 데이터 지원을 제공합니다.
RL 튜닝 지원: 맞춤형 에이전트 행동의 강화 학습 방법을 지원하며, 사용자는 보상 함수 지정 등을 통해 에이전트의 행동을 최적화할 수 있습니다.
벤치마크 테스트 통합: WebShop, GaiA, OSWorld, AgentBench 등 테스트 환경을 내장하여 에이전트의 성능을 정량적으로 평가할 수 있습니다.
다양한 전략: Tree-of-Thoughts, Monte Carlo Tree Search 등 강화 학습 전략을 통합하여 장기 계획 작업에서 에이전트의 추론 능력을 향상시킵니다.
커뮤니티 협업: 사용자가 코드, 데이터셋 등을 제출할 수 있으며, 중요한 기여자는 논문의 공동 저자가 될 수 있어 커뮤니티의 공동 개발을 촉진합니다.
실시간 진행 상황 공유: 동적 업데이트를 통해 RL 튜닝 과정과 결과를展示하여 사용자가 프로젝트의 최신 진행 상황을 파악할 수 있도록 합니다.
OpenManus-RL 응용 시나리오
쇼핑 의사 결정: 맞춤형 에이전트 환경을 통해 쇼핑 의사 결정 작업에서 에이전트의 성능을 최적화하며, 예를 들어 WebShop에서 구매 성공률을 높입니다.
복잡한 작업 분석: GAIA, OSWorld 등 벤치마크 테스트에서 성공률, 응답 시간 등 지표를 통해 복잡한 작업에서 에이전트의 성능을 분석하여 개발자가 모델 성능을 비교할 수 있도록 돕습니다.
멀티모달 작업 최적화: OSWorld 등 멀티모달 작업 환경에서 에이전트의 행동을 최적화하여 멀티모달 작업에서의 성능을 향상시킵니다.
장기 계획 작업: 통합된 다양한 전략을 활용하여 장기 계획 작업에서 에이전트의 추론 능력을 향상시키며, 예를 들어 Tree-of-Thoughts 전략을 통해 에이전트의 행동을 최적화합니다.
OpenManus-RL 설치
1. Conda 환경 생성: 의존성 충돌을 방지하기 위해 Conda를 사용하여 환경을 생성할 것을 권장하며, 명령은 다음과 같습니다:
conda create -n openmanus-rl python=3.10
conda activate openmanus-rl
2. 프로젝트 복제: Git이 설치되어 있는지 확인한 다음 프로젝트를 복제하고 프로젝트 디렉토리로 이동합니다. 명령은 다음과 같습니다:
git clone https://github.com/OpenManus/OpenManus-RL.git
cd OpenManus-RL
3. 의존성 설치: 프로젝트 루트 디렉토리에서 다음 명령을 실행하여 의존성을 설치하며, 다운로드가 느린 경우国内 미러를 사용할 수 있습니다:
pip install -r requirements.txt
또는
pip install -r requirements.txt -i https://pypi.tuna.tsinghua.edu.cn/simple
시각화 도구는 추가 설치가 필요합니다:
pip install matplotlib numpy
4. 모델 및 데이터셋 구성:
지도 미세 조정(SFT): 모델과 데이터셋을 지정하며, 명령은 다음과 같습니다:
python -m openmanus_rl.sft --model_name_or_path Qwen/Qwen2.5-1.5B-Instruct --dataset_name CharlieDreemur/OpenManus-RL
강화 학습 튜닝(GRPO): 보상 함수를 구성하며, 명령은 다음과 같습니다:
python -m openmanus_rl.grpo --model_name_or_path Qwen/Qwen2.5-1.5B-Instruct --dataset_name CharlieDreemur/OpenManus-RL-GRPO --reward_funcs accuracy format tag_count
데이터셋은 Huggingface에서 가져올 수 있습니다.
5. 프로젝트 실행:
단일 GPU에서 SFT 실행:
python -m openmanus_rl.sft --output_dir data/sft-output
다중 GPU에서 GRPO 실행(zero3.yaml 구성 필요):
accelerate launch --config_file=configs/accelerate_configs/zero3.yaml openmanus_rl/grpo.py --output_dir data/grpo-output
OpenManus-RL 사용
1. 에이전트 환경 구축:
python -m openmanus_rl.sft를 실행하여 기본 환경을生成합니다.
구성 파일(예: 작업 목표 또는 보상 함수)을 수정합니다.
python -m openmanus_rl.grpo를 실행하여 튜닝을 시작합니다.
2. 데이터 수집 및 테스트:
모델 구성(예: Deepseek-R1): python -m openmanus_rl.grpo --model_name_or_path Deepseek-R1
테스트 실행: --benchmark GAIA, 결과는 data/ 디렉토리에 저장됩니다.
3. RL 튜닝 작업:
GRPO 모드 실행: python -m openmanus_rl.grpo --reward_funcs accuracy
훈련 로그를 확인하면 모델이 data/grpo-output에 저장됩니다.
GitHub 저장소 주소:https://github.com/OpenManus/OpenManus-RL









