
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
SpeakerKit: 오디오의 여러 화자를 빠르고 정확하게 식별
小编 ·

SpeakerKit: 오디오의 여러 화자를 빠르고 정확하게 식별
SpeakerKit란 무엇인가요?
SpeakerKit은 Argmax 회사에서 개발한 온디바이스 화자 인식(Diarization) 도구로, 오디오 속 다양한 화자를 빠르고 효율적으로 식별할 수 있습니다. WhisperKit(오디오 전사 도구)과 함께 사용하면 화자 라벨이 포함된 전사 텍스트를 생성할 수 있습니다. 오디오 속 화자를 빠르고 정확하게 식별해야 하는 응용 시나리오에 적합합니다.
SpeakerKit의 주요 특징
속도:
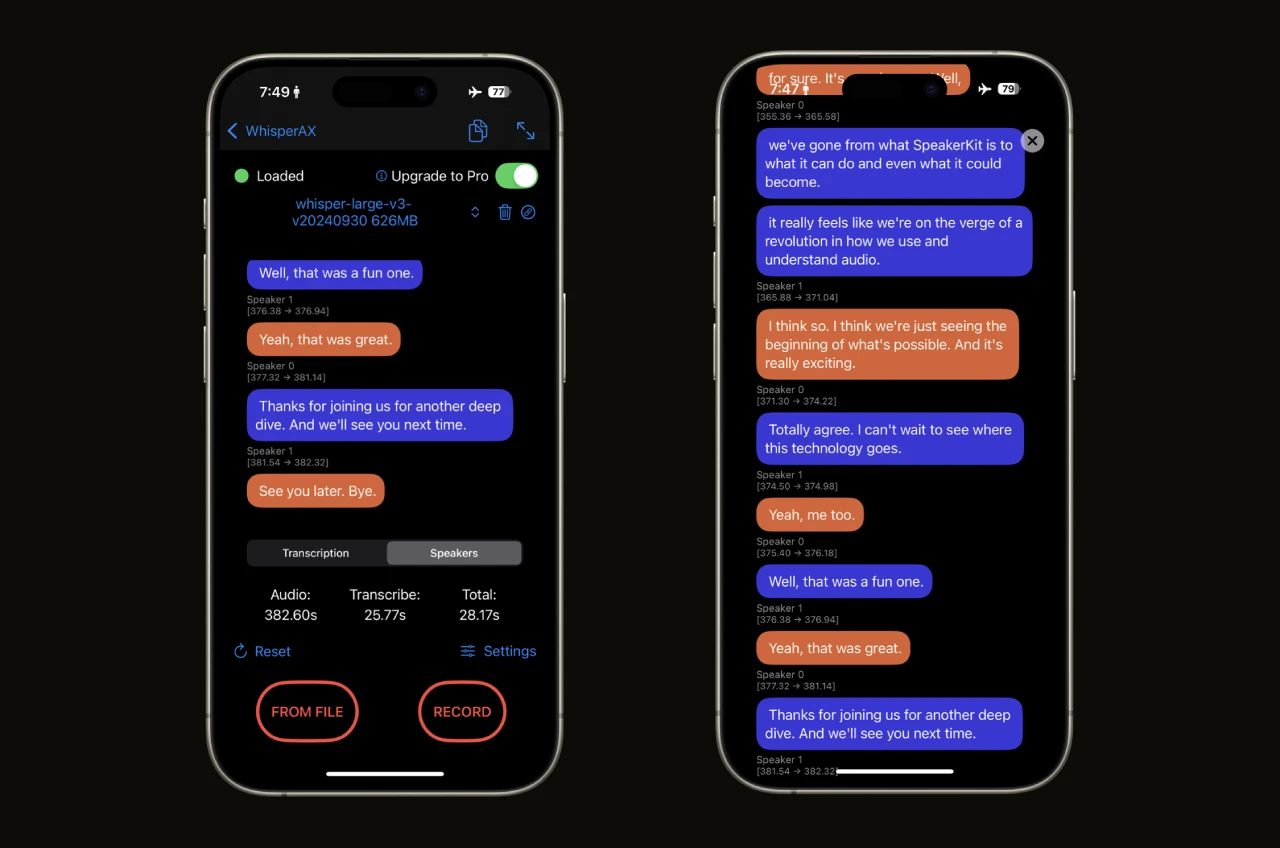
iPhone에서 4분 길이의 오디오를 처리할 때 SpeakerKit은 화자 인식 완료까지 약 1초밖에 걸리지 않아, 다른 유사 시스템보다 훨씬 빠릅니다.
WhisperKit과 함께 사용할 경우 전사와 인식에 걸리는 총 시간은 단 25초입니다.
품질:
속도가 수 배 빨라진 데에도 불구하고, SpeakerKit의 오류율은 업계 선두 시스템(예: Pyannote)과 비슷한 수준입니다.
크기:
총 크기는 약 10MB에 불과해, 애플리케이션에 통합하거나 빠르게 다운로드하는 데 용이합니다.
호환성:
iOS 16 및 macOS 13 이상 버전의 기기를 지원합니다.
Android 지원은 현재 개발 중입니다.
모듈성:
SpeakerKit은 WhisperKit과 함께 사용하여 화자 라벨이 포함된 전사 텍스트를 생성할 수도 있고, 다른 전사 엔진과 통합하여 사용할 수도 있어, 서버 측 API보다 더 높은 유연성을 제공합니다.
벤치마크 테스트
Argmax는 13개의 널리 사용되는 데이터셋에서 화자 인식 시스템의 성능을 표준화된 방식으로 테스트하기 위한 SDBench라는 Python 도구 키트를 개발했습니다. SDBench의 코드는 오픈소스로 공개될 예정이며, 관련 논문은 2025년 4월에 발표될 예정입니다.
향후 계획
전사 품질 최적화:현재 SpeakerKit의 독립적인 화자 인식 품질은 업계 선두 수준(DER로 측정)에 도달해 있습니다. 다음 단계로, 팀은 WhisperKit과의联合 사용을 최적화하여 화자 라벨이 포함된 전사 품질(WDER로 측정)을 향상시킬 계획입니다.
화자 식별 기능:SpeakerKit은 화자의 음성 특징(보이스프린트)을 추출하여 새로운 맥락에서도 이들을 식별할 수 있는 새로운 기능을 출시할 예정입니다.
자세히 읽기:https://www.argmaxinc.com/blog/speakerkit
HuggingFace:https://huggingface.co/argmaxinc/speakerkit-pro









