
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
HunyuanVideo-I2V: Tencent Hunyuan의 오픈소스 이미지-투-비디오 생성 프레임워크
小编 ·

HunyuanVideo-I2V: Tencent Hunyuan의 오픈소스 이미지-투-비디오 생성 프레임워크
HunyuanVideo-I2V란 무엇인가요?
HunyuanVideo-I2V는 텐센트 혼위안(Hunyuan) 팀이 2025년 3월 6일에 오픈소스로 공개한全新的이미지-투-비디오 프레임워크입니다. 이 프레임워크는 이전에 오픈소스로 공개된HunyuanVideo를 기반으로 이미지에서비디오 생성 능력을 한 단계 더 확장한 것으로, 영상 제작자는 단일 이미지로부터 고품질의 짧은 영상을 생성할 수 있으며 커스터마이징된 특수 효과 학습도 지원합니다.
HunyuanVideo-I2V 기능 특징
이미지-투-비디오: HunyuanVideo-I2V는 정적 이미지를 영상의 첫 프레임으로 사용하여, 사용자가 입력한 자막이나 설명에 부합하는 영상 콘텐츠를 생성할 수 있습니다.
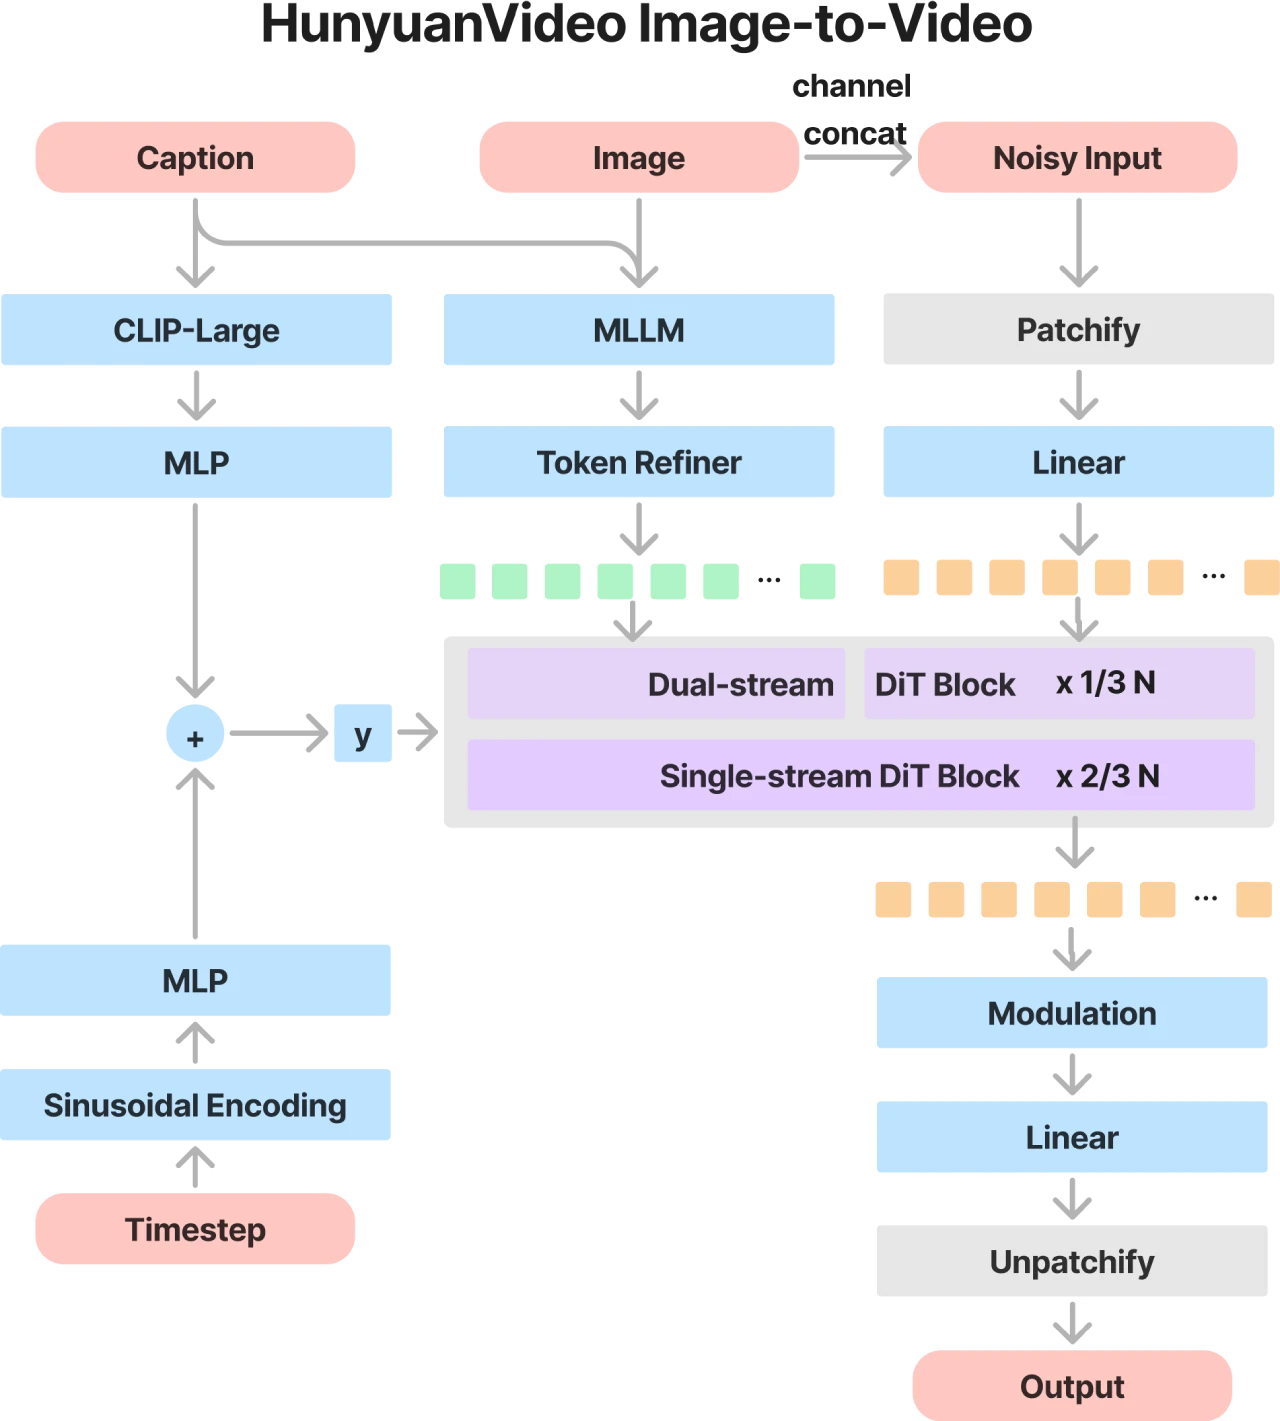
멀티모달 대규모 언어 모델(MLLM): 이 모델은 사전 학습된 멀티모달 대규모 언어 모델을 텍스트 인코더로 채택하여, 입력 이미지의 의미적 내용을 이해하는 능력을 크게 강화했습니다.
3D 변분 오토인코더(3D VAE): CausalConv3D 기술로 학습된 3D VAE를 사용하여 픽셀 공간의 비디오와 이미지를 압축된 잠재 공간으로 변환함으로써 후속 모델의 토큰 수를 줄입니다.
듀얼 스트림에서 유니 스트림으로 전환하는 하이브리드 모델 설계: 듀얼 스트림 단계에서는 비디오 토큰과 텍스트 토큰이 여러 Transformer 블록에서 독립적으로 처리되며, 유니 스트림 단계에서는 비디오 토큰과 텍스트 토큰을 연결하여 멀티모달 정보 융합을 수행합니다.
점진적 학습 전략: 저해상도·짧은 비디오에서 고해상도·긴 비디오로 점차 전환하여 모델의 수렴 속도를 높입니다.
프롬프트 재작성 모델: 사용자 프롬프트의 언어 스타일과 길이가 다양하다는 문제를 해결하여, 사용자가 입력한 프롬프트를 모델이 더 잘 이해할 수 있는 형식으로 변환합니다.
커스터마이징 가능한 LoRA 학습: 소량의 데이터를 통해 "머리카락 성장"이나 "인물 동작" 등 특정 효과를 가진비디오 생성 모델을 학습하는 것을 지원합니다.
고효율 추론: 단일 GPU 추론과 다중 GPU 시퀀스 병렬 추론을 제공하여 더 빠른 추론 속도를 지원합니다.
HunyuanVideo-I2V 기술 아키텍처
HunyuanVideo-I2V는 전체 아키텍처에서 HunyuanVideo의 설계 사상을 이어받았으며, 이를 기반으로 이미지-투-비디오 생성 과제에 최적화를 진행했습니다. 핵심은 이미지 잠재 공간 연결 기술을 이용해 참조 이미지의 핵심 정보를 영상 생성 과정에 주입하는 동시에, MLLM을 통해 텍스트와 이미지 정보의 크로스 모달 심층 융합을 구현하는 데 있습니다.
HunyuanVideo-I2V 사용 방법
1. 설치 및 의존성
PyTorch 및 기타 의존성을 설치하며, 구체적인 설치 안내는 GitHub 페이지에서 확인할 수 있습니다.
NVIDIA GPU 사용을 권장하며, 최소 80GB의 비디오 메모리가 필요합니다.
2. 사전 학습 모델 다운로드
사전 학습된 모델 가중치는 GitHub 페이지 또는 Hugging Face 페이지에서 다운로드할 수 있습니다.
3. 추론 코드
제공된 추론 코드(예: sample_video.py)를 사용하여 영상을 생성합니다.
4. LoRA 학습
LoRA 학습 코드가 제공되며, 사용자는 소량의 데이터를 통해 특정 효과를 가진 영상 생성 모델을 학습할 수 있습니다.
HunyuanVideo-I2V 활용 시나리오
영상 콘텐츠 제작: 영상 제작자에게 고효율·고품질의 영상 생성도구를 제공합니다.
영화·드라마 제작: 영화급 영상 콘텐츠를 생성합니다.
개인 맞춤형 영상: 사용자가 업로드한 이미지와 설명에 따라 개인화된 영상을 생성합니다.
공식 웹사이트:https://video.hunyuan.tencent.com/
GitHub:https://github.com/Tencent/HunyuanVideo-I2V
Hugging Face: https://huggingface.co/tencent/HunyuanVideo-I2V









