
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
Umi-OCR: 무료 오픈소스 오프라인 일괄 OCR 도구
小编 ·

Umi-OCR: 무료 오픈소스 오프라인 일괄 OCR 도구
Umi-OCR란 무엇인가요?
Umi-OCR은 바이두의 PaddleOCR 프레임워크를 기반으로 개발된 오픈소스 무료 오프라인 OCR 도구로, 화면 캡처/이미지 일괄 가져오기, PDF 문서 인식, 워터마크/머리글·바닥글 제외, QR코드 스캔 및 생성, 다국어 라이브러리 내장 등의 기능을 지원하며, 고정밀 인식, 오프라인 실행, 다국어 지원, 효율적인 일괄 처리 등의 장점을 가지고 있습니다.
Umi-OCR 기능 특징
오프라인 실행:완전한 오프라인 사용으로 네트워크 연결이 필요 없으며, 사용자 프라이버시를 보호합니다.
다국어 지원:다국어 라이브러리를 내장하여 여러 언어의 문자 인식을 지원합니다.
다양한 인식 기능:
스크린샷 OCR: 화면 캡처, 이미지 붙여넣기를 통한 문자 인식을 지원합니다.
일괄 OCR: 이미지를 일괄 가져와 문자 인식을 수행할 수 있으며, 다양한 이미지 형식을 지원합니다.
PDF 인식: PDF 문서에서 문자를 추출하고, 머리글, 바닥글 등을 제외할 수 있습니다.
QR코드 인식:QR코드 스캔 및 생성을 지원합니다.
수식 인식:수학 수식 인식을 지원합니다(테스트 중).
텍스트 후처리:인식 결과의 레이아웃을 정리하고, 방해가 되는 텍스트를 제외할 수 있습니다.
유연한 호출:명령줄 및 HTTP 인터페이스 호출을 지원하여 개발자의 통합을 용이하게 합니다.
Umi-OCR 기술 특성
고정밀 인식: 다양한 언어 모델을 내장하여, 간체/번체 중국어, 영어, 일본어, 한국어 및 일반적인 유럽 언어를 지원하며, 혼합 레이아웃 텍스트 인식도 호환됩니다.
복잡한 레이아웃 분석: 세로 문자, 표, 간단한 수학 수식을 정확하게 인식합니다.
저품질 이미지 최적화: 흐릿하거나 기울어졌거나 저조도 이미지에 대해 전처리를 수행하여 인식 정확도를 높입니다.
효율적인 일괄 처리와 유연한 출력: 폴더 드래그 또는 이미지 일괄 가져오기를 지원하며, 수백 개 파일의 OCR 인식을 한 번에 완료할 수 있습니다.
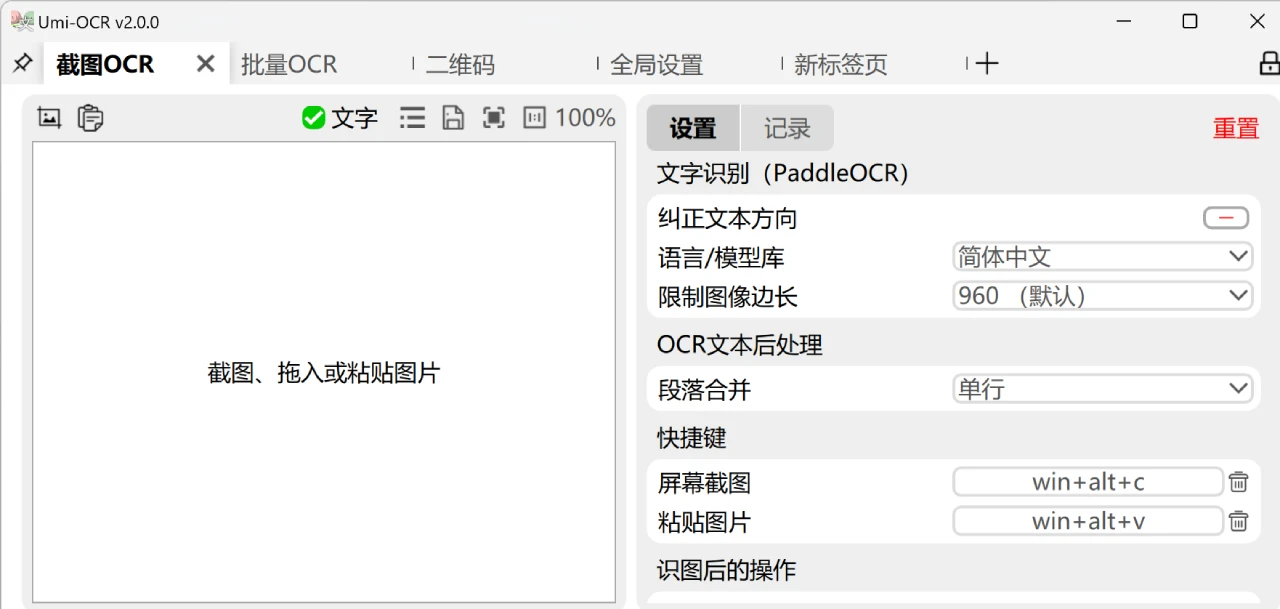
Umi-OCR 사용 시나리오
업무 시나리오: 스캔된 PDF, 이미지 보고서의 문자를 빠르게 추출하여 편집 가능한 문서로 변환합니다.
학술 연구: 외국어 문헌, 고문헌 자료를 인식하여 번역 및 인용을 지원합니다.
멀티미디어 처리: 동영상 캡처, 만화 번역, 게임 자막에 문자 추출 지원을 제공합니다.
자동화 프로세스: 명령줄 인터페이스를 통해 다른 도구 체인에 통합하여 일괄 OCR 자동화를 구현합니다.
Umi-OCR 다운로드 및 사용
다운로드 링크:
란조우(蓝奏) 클라우드(중국 내 추천, 가입 불필요/속도 제한 없음):https://hiroi-sora.lanzoul.com/s/umi-ocr
GitHub Release:https://github.com/hiroi-sora/Umi-OCR/releases/tag/v2.1.4
설치 방법:압축 해제 후 바로 사용 가능, 별도 설치 불필요. Windows 7 x64 및 Linux x64 플랫폼을 지원합니다.
명령줄 설치:Scoop을 통한 설치(Windows):
scoop install extras/umi-ocr
향후 계획
기반 플러그인 메커니즘 리팩토링.
온라인 OCR API 플러그인 추가.
독립적인 수학 수식 인식 플러그인 구현.
이미지 번역 및 오프라인 번역 지원.
MacOS 및 더 많은 Linux 배포판 호환
이틀 전에 소개한 olmOCR도 괜찮습니다. PDF 변환에 중점을 둔다면 함께 시도해 볼 수 있습니다.









