
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
UniTok: ByteDance가 오픈소스로 공개한 생성·이해 작업을 동시에 지원하는 비주얼 토크나이저
小编 ·

UniTok: ByteDance가 오픈소스로 공개한 생성·이해 작업을 동시에 지원하는 비주얼 토크나이저
UniTok란 무엇인가요?
UniTok은 ByteDance에서 오픈소스로 공개한 시각적 토크나이저로, 생성 작업과 이해 작업 모두에 사용되며 시각 정보를 효율적으로 토큰으로 변환할 수 있어 다양한 자기회귀 생성 모델 및 멀티모달 이해 모델에 적합합니다. 혁신적인 시각 토크나이제이션 기술을 통해 매우 적은 수의 토큰(예: 256개 토큰)만으로도 고품질의 시각 콘텐츠 생성, 예를 들어 이미지와 비디오의 재구성을 실현합니다.
UniTok의 핵심 기능
고효율 시각 인코딩: UniTok은 복잡한 시각 정보(예: 이미지와 비디오)를 모델이 처리하기 쉬운 이산 토큰으로 분해할 수 있습니다.
멀티모달 지원: 이미지에만 적용되는 것이 아니라 비디오 콘텐츠도 처리하며, 연속적 및 이산적 토크나이제이션을 모두 지원합니다.
낮은 자원 요구량: UniTok은 적은 수의 토큰으로도 높은 재구성 품질을 유지하며, 예를 들어 256개 토큰에서의 재구성 오차가 단 0.39에 불과합니다.
유연한 압축률: 사용자는 생성 품질과 계산 효율성 사이의 균형을 맞추기 위해 필요에 따라 토큰 수를 조정할 수 있습니다.
UniTok 활용 분야
시각 생성 작업: 예: 이미지 및 비디오 재구성, 언어 모델 기반 시각 합성.
티모달 이해: 텍스트와 시각 정보를 결합하여 보다 효율적인 멀티모달 모델 학습을 실현.
확산 모델: DiT 및 Latte 등 확산 모델과 결합하여 고품질의 시각 콘텐츠 생성.
UniTok 기술 구현
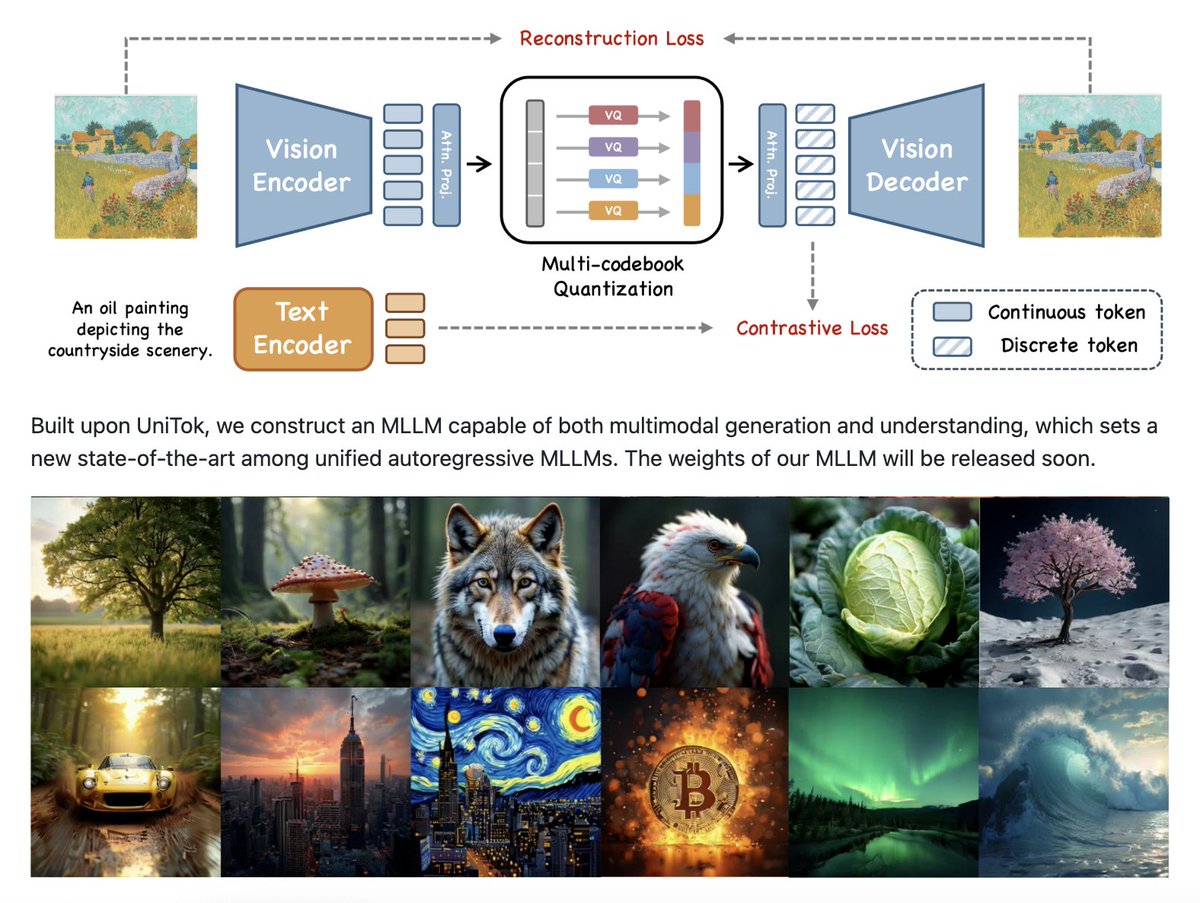
UniTok은 VQVAE(변이형 양자화 오토인코더)와 VAE(변이형 오토인코더) 기술을 기반으로 하며, 2단계 학습을 통해 고효율 시각 인코딩을 실현합니다. 학습 과정은 다음과 같습니다.
이미지 단일 해상도 학습: 고정된 해상도에서 이미지 학습을 수행합니다.
이미지-비디오 결합 다중 해상도 학습: 여러 해상도에서 이미지와 비디오의 결합 학습을 수행합니다.
VAE 미세 조정: KL 손실을 통해 VQVAE 모델을 미세 조정하여 VAE 모델을 얻습니다.
UniTok의 장점
단일 모델 및 가중치: UniTok은 단일 모델과 가중치로 이미지와 비디오 토크나이제이션을 처리하여 모델 관리 및 배포를 간소화합니다.
높은 적응성: 고해상도 및 장시간 비디오 입력을 지원하여 다양한 응용 시나리오에 적응합니다.
강한 호환성: 언어 모델 및 확산 모델과 호환되어 다양한 시각 생성을 실현합니다.
UniTok은 다중 코드북 양자화 기술을 통해 기존 토크나이저가 생성 및 이해 작업에서 겪던 병목 현상을 해결하여, 멀티모달 대형 언어 모델(MLLMs)에 보다 효율적인 솔루션을 제공합니다.
프로젝트 주소:https://foundationvision.github.io/UniTok/
GitHub 저장소:https://github.com/FoundationVision/UniTok









