
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
CSM: 실제 사람과 대화하는 듯한 Sesame의 음성 합성 모델
小编 ·

CSM: 실제 사람과 대화하는 듯한 Sesame의 음성 합성 모델
CSM이란 무엇인가요?
CSM(Conversational Speech Model)은 Sesame사가 개발한 대화형 음성 합성 모델입니다. Transformer 아키텍처를 기반으로 하며, 종단간(end-to-end) 다중 모달 학습 방법을 채택하여 문맥과 감정적 배경을 결합해 매우 사실적인 실제 사람 음성을 합성할 수 있어 음성 합성 분야에서 두드러진 성능을 보여줍니다.
CSM의 기능적 특징
자연스러운 음성 표현: 실제 사람 음성의 억양, 리듬, 음색을 모방하여 기존 음성 합성 시스템의 단조로운 억양 문제를 해결하고, 합성된 음성이 마치 실제 사람이 말하는 것처럼 만들어 줍니다.
섬세한 감정 표현: 감정, 끊어 읽기, 강조와 같은 자연스러운 요소를 녹여내어 분노, 슬픔, 흥분 등 다양한 감정을 전달하여 대화를更具感染力(더욱 감동적이고 몰입감 있게) 만듭니다.
낮은 지연 응답: 최적화된 계산 방법을 통해 대화의 원활함을 보장하며, ai 응답 시간이 매우 짧아 인간의 즉각적인 반응에 가깝습니다.
다중 모달 상호작용: 텍스트와 음성 기록을 동시에 입력할 수 있으며, 문맥 인지 능력을 갖추고 있어 대화의 배경과 감정을 이해하여 음성을 더욱 자연스럽고 상호작용이 풍부하게 만듭니다.
개성 일관성: 안정적인 음성 특징을 유지하여 다양한 상황에서 부조화가 발생하는 것을 방지하고, 기존 TTS 시스템의 로봇 같은 억양을 제거합니다.
대화 동적 모델링: 인간 대화에서 나타나는 자연스러운 끊어 읽기, 말하기 속도, 강조 등의 요소를 모방하여 음성 상호작용의 현실감과 상호작용성을 높입니다.
CSM의 기술적亮点(강점)
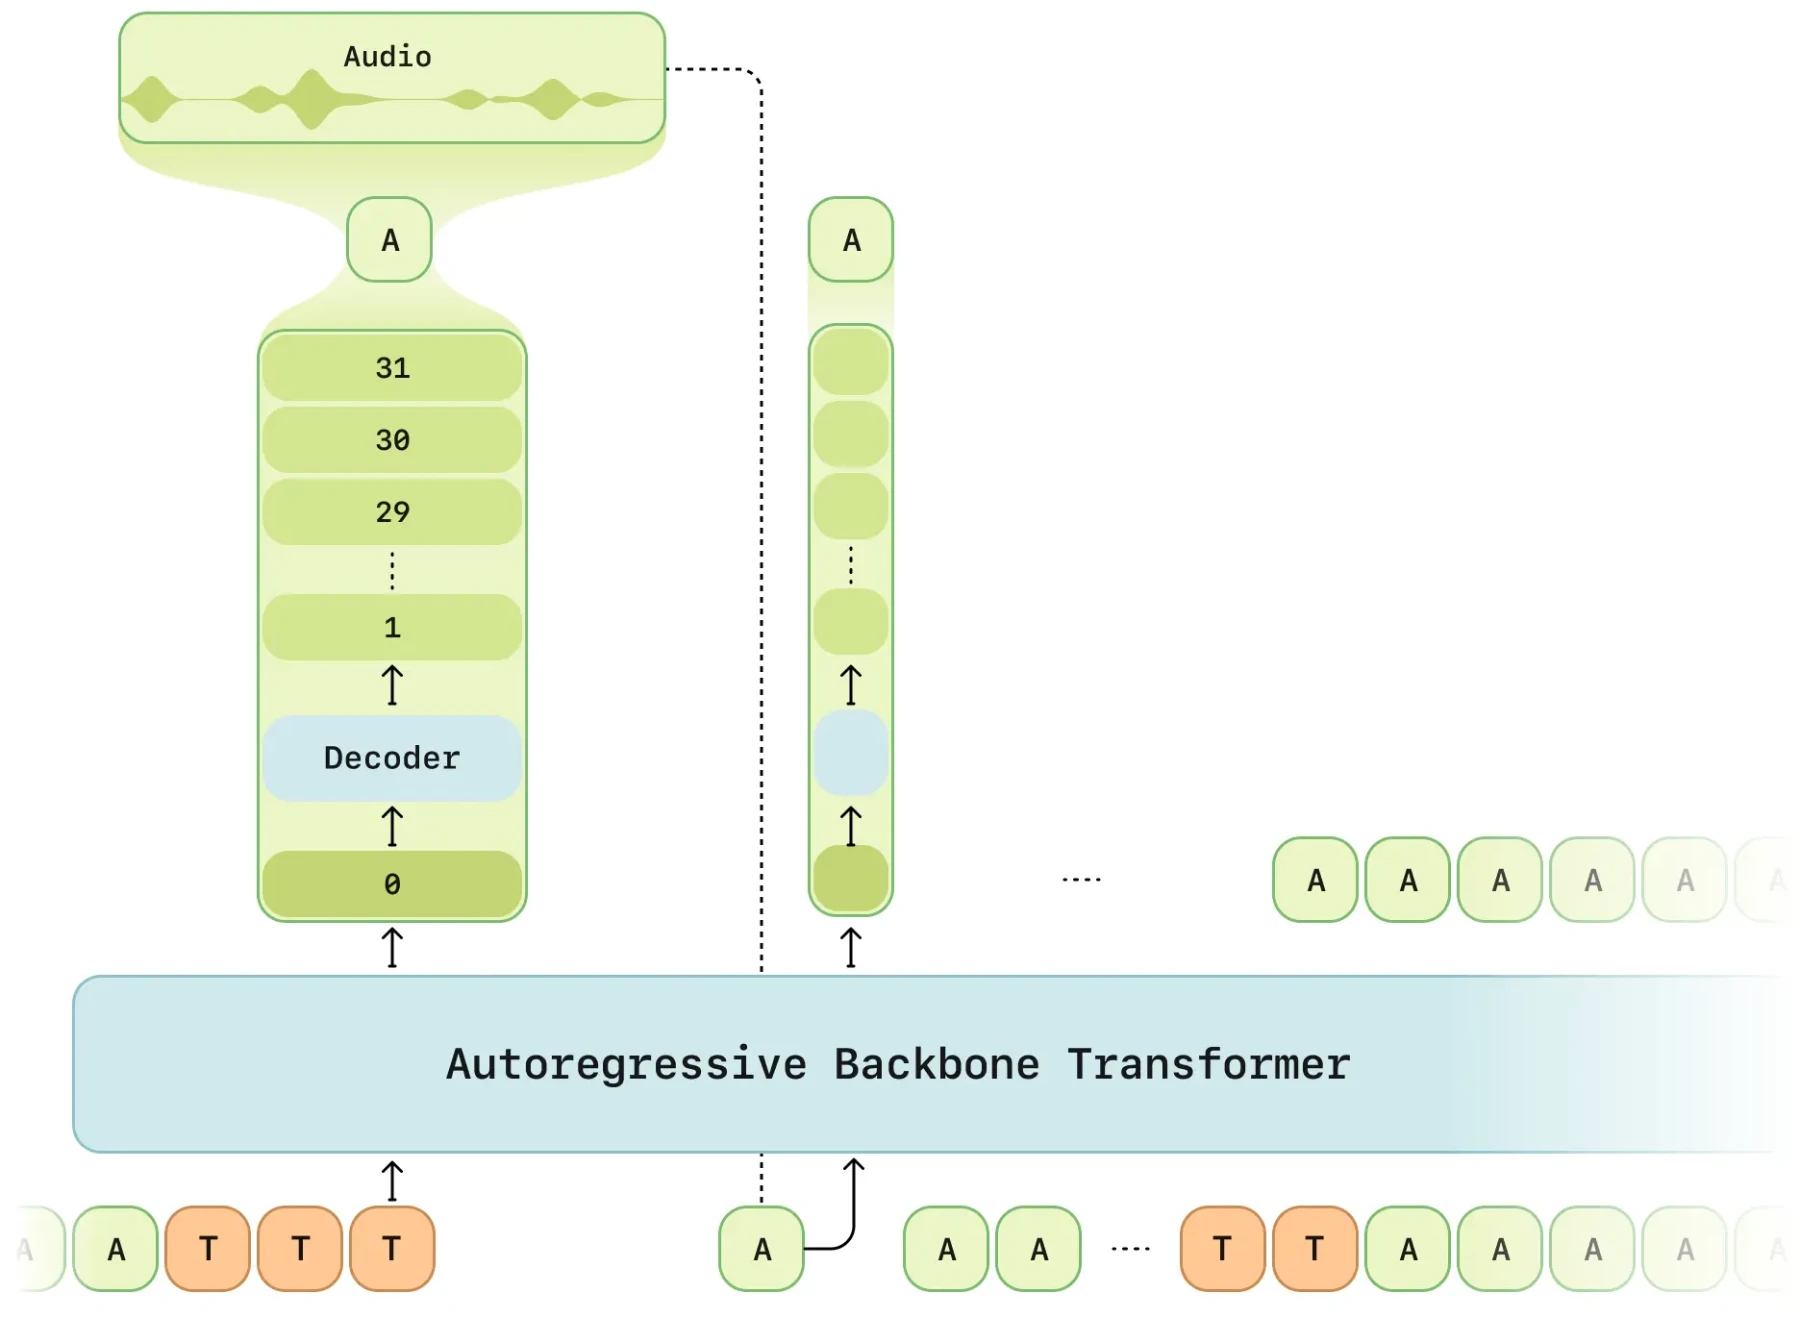
종단간 다중 모달 Transformer 아키텍처: 중간 처리 단계 없이 텍스트로부터 직접 고품질 음성을 생성합니다. Transformer를 핵심으로 사용하여 AI 음성이 문맥 인지 능력을 갖추도록 합니다. 텍스트는 LLaMA Tokenizer로 처리되고, 음성은 Mimi Tokenizer로 인코딩되며, RVQ 양자화 기술이採用됩니다.
Residual Vector Quantization(RVQ) 기반 오디오 인코딩: 시맨틱 Token과 어쿠스틱 Token, 두 가지 오디오 Token을 사용합니다. 시맨틱 Token은 음성의 의미와 발음 특징을, 어쿠스틱 Token은 음높이, 음색, 운율 등 세부 정보를 나타냅니다. 계층적 RVQ 훈련을 통해 각 계층이 핵심 및 세부 특징을 예측하여 정보 손실을 방지하고 음성의 자연스러움을 향상시킵니다.
計算 최적화 및 낮은 지연 추론
지연 모드 최적화: 먼저 낮은 레벨의 RVQ 레이어를 계산한 후, 높은 레벨의 세부 특징을 순차적으로 계산하여 추론 속도를 높입니다.
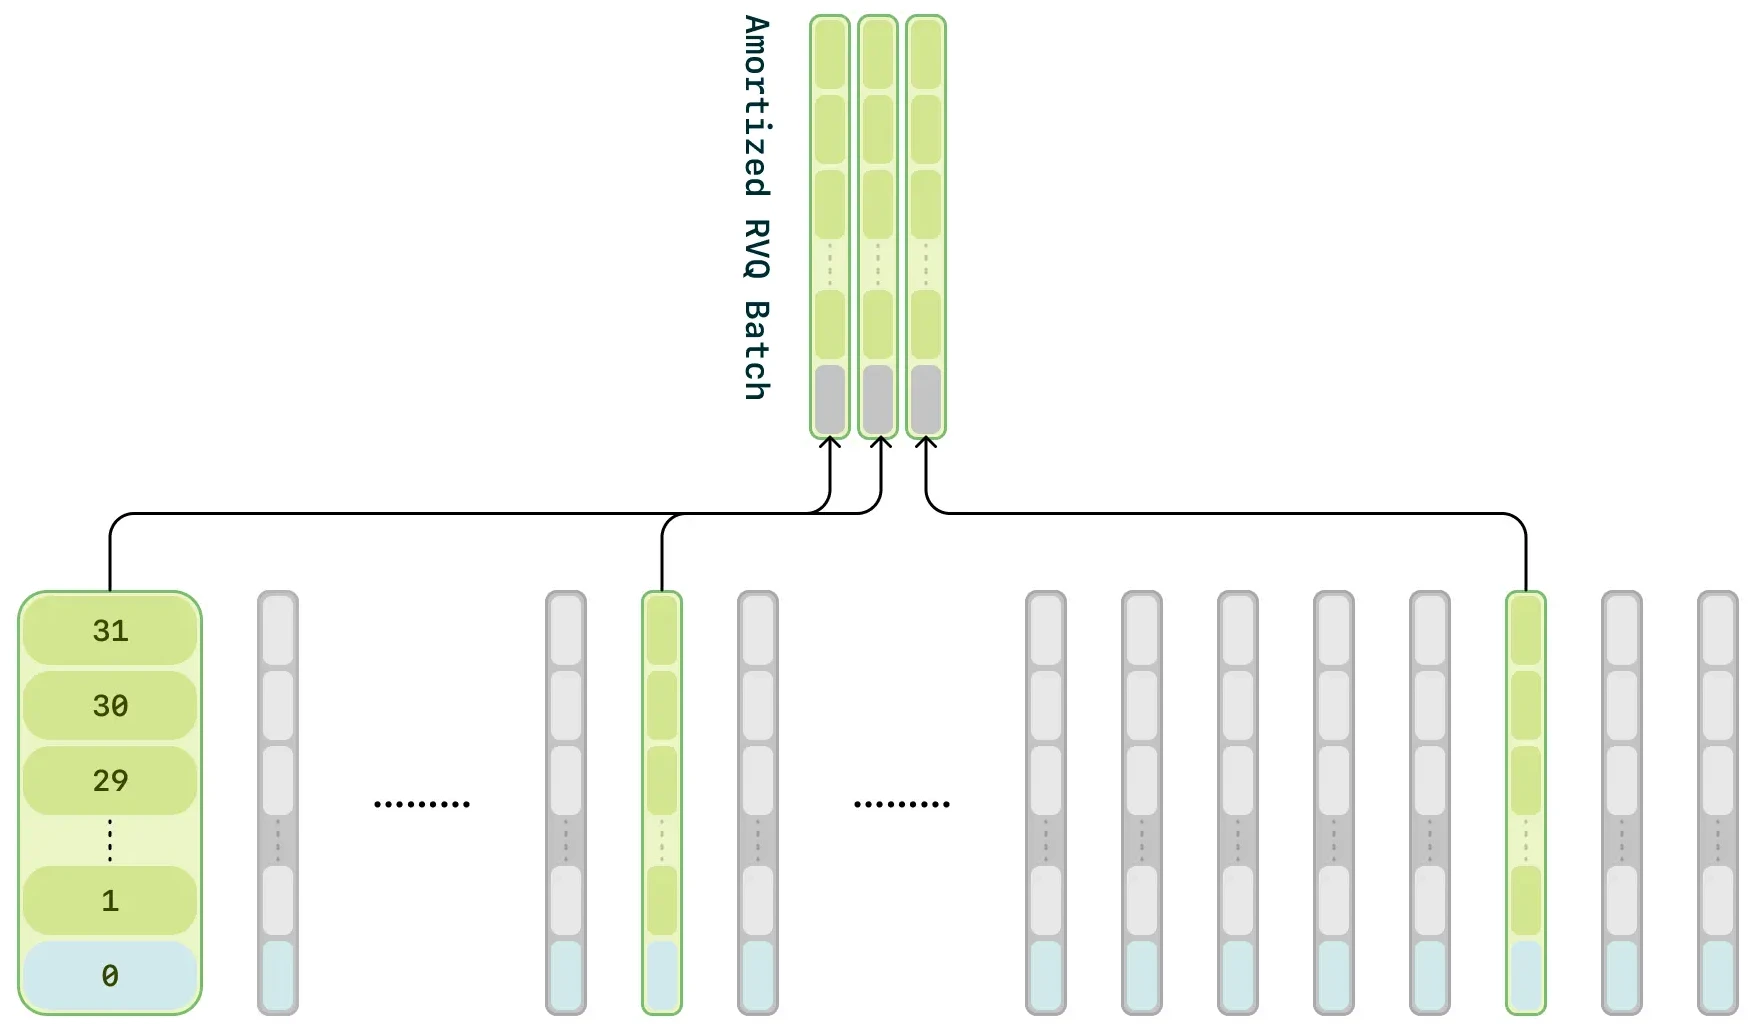
계산 분산: 훈련 단계에서 오디오 프레임의 1/16을 무작위로 샘플링하여 최적화함으로써, 계산 수요를 줄이면서도 오디오 품질에는 영향을 주지 않습니다.
2단계 Transformer 구조: 백본 Transformer가 텍스트와 오디오 정보를 처리하여 기본 구조를 예측하고, 경량 디코더가 오디오를 세분화하여 계산량을 줄이고 추론 속도를 높입니다.
CSM의 광범위한 응용
지능형 어시스턴트: 스마트 스피커와 가상 어시스턴트의 음성 상호작용을 더욱 자연스럽고 친근하게 만들어 마치 실제 사람과 대화하는 듯합니다.
고객 서비스: 고객 서비스 시스템에 적용되어 사용자가 보다 원활한 상호작용 경험을 누리고 만족도를 높일 수 있게 합니다.
교육 및 훈련: 언어 학습 애플리케이션에서 실제와 같은 대화 환경을 조성하여 학습자가 언어 지식을 이해하고 연습하는 데 도움을 줍니다.
엔터테인먼트 산업: 게임, 애니메이션 등 업계의 캐릭터에 생생하고 사실적인 음성을 부여하여 이야기를 더욱 매력적으로 만듭니다.
가상 어시스턴트 구축: 보다 자연스러운 음성을 가진 가상 어시스턴트를 만들어贴心(따뜻하고 세심한) 서비스를 제공합니다.
교육 플랫폼 상호작용: 교육 플랫폼의 상호작용 음성 대화에서 활용되어 학습의 재미와 효과를 높입니다.
CSM 사용 방법
온라인 체험
Sesame 공식 웹사이트(sesame.com/voicedemo)에 방문하여 음성 합성 기술의 효과를 체험할 수 있습니다.
제품에 통합
개발자는 Sesame 음성 모델을 음성 어시스턴트, 지능형 고객 서비스 시스템 등 제품 또는 서비스에 통합하여 음성 상호작용 능력을 향상시킬 수 있습니다.
연구 및 개발
Sesame사는 모델 규모를 확대하고 데이터셋 양을 늘릴 계획입니다. 연구자는 공식 소개 및 데모(https://www.sesame.com/research/crossing_the_uncanny_valley_of_voice )를关注(주시)하여 최신 성과와 기술 동향을 파악할 수 있습니다.
온라인으로 체험해 보고 싶다면 다음 주소를 방문하세요:https://www.sesame.com/research/crossing_the_uncanny_valley_of_voice#demo









