
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
Migician: 칭화대학교 등 팀이 발표한 복잡한 장면의 다중 이미지 객체 그라운딩을 위한 멀티모달 모델
小编 ·

Migician: 칭화대학교 등 팀이 발표한 복잡한 장면의 다중 이미지 객체 그라운딩을 위한 멀티모달 모델
Migician이란 무엇인가요?
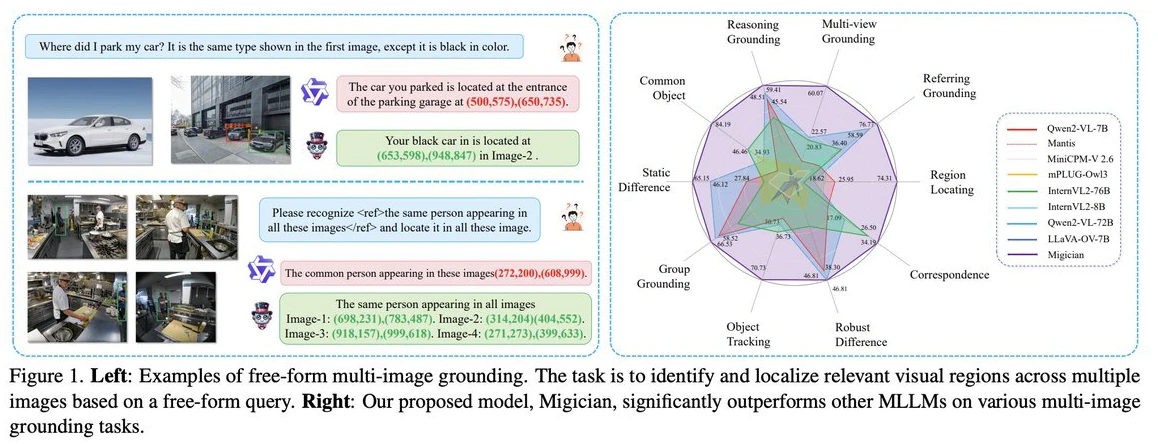
Migician은 칭화대학교(清华大学), 베이징 교통대학(北京交通大学), 화중과기대학(华中科技大学)이 공동 개발한 다중 이미지 시나리오에서 자유 형식(free-form) 및 정밀 위치 지정이 가능한 다모달 대규모 언어 모델입니다. 텍스트 설명, 이미지 또는 이 둘의 결합을 통해 여러 이미지에서 대상 영역을 빠르게 찾아낼 수 있으며, 다중 이미지 시나리오에서의 위치 지정 능력을 향상시킵니다.
Migician의 주요 기능
이미지 간 위치 지정: Migician은 "이미지로 이미지 검색" 및 "텍스트+이미지" 결합 쿼리를 포함한 다양한 이미지 간 위치 지정 방식을 지원합니다. 예를 들어, 보안 감시에서 "검은색 상의, 파란색 청바지, 흰색 야구 모자를 쓴 남자"와 같은 텍스트 설명을 입력하면, 모델은 수많은 감시 화면 중에서 설명에 부합하는 사람을 빠르게 찾아낼 수 있습니다.
다모달 융합: 첨단 신경망 아키텍처를 통해 Migician은 시각과 언어 정보를 효과적으로 통합하여 이미지 간의 의미적 연관성을 깊이 있게 탐색합니다. 예를 들어, "일련의 도시 풍경 이미지에서 빨간 자동차가 있는 화면을 찾으라"는 작업을 처리할 때, 모델은 이미지에서 색상, 모양 등의 시각적 특징을 추출하고, 동시에 텍스트에서 '빨간 자동차'의 의미 정보를 분석한 후, 이 둘을 융합하여 대상을 보다 정확하게 찾아냅니다.
CoT(Chain-of-Thought) 추론 최적화: Migician은 CoT 추론 최적화를 도입하여 복잡한 문제를 여러 개의 단순한 하위 문제로 분해하고, 단계별로 도출하여 최종 답에 도달합니다. 예를 들어, 특정 실내의 물건을 찾을 때, 모델은 먼저 텍스트 설명에 따라 해당 방이 위치할 가능성이 있는 영역을 판단한 후, 해당 영역 내의 이미지에서 물건의 정확한 위치를 찾아냅니다.
엔드 투 엔드 프레임워크: Migician은 엔드 투 엔드 프레임워크를 채택하여 다중 이미지 입력을 직접 처리함으로써, 기존의 단계별 추론 방식에서 발생하는 오차 누적과 낮은 효율성 문제를 방지합니다.
모델 성능
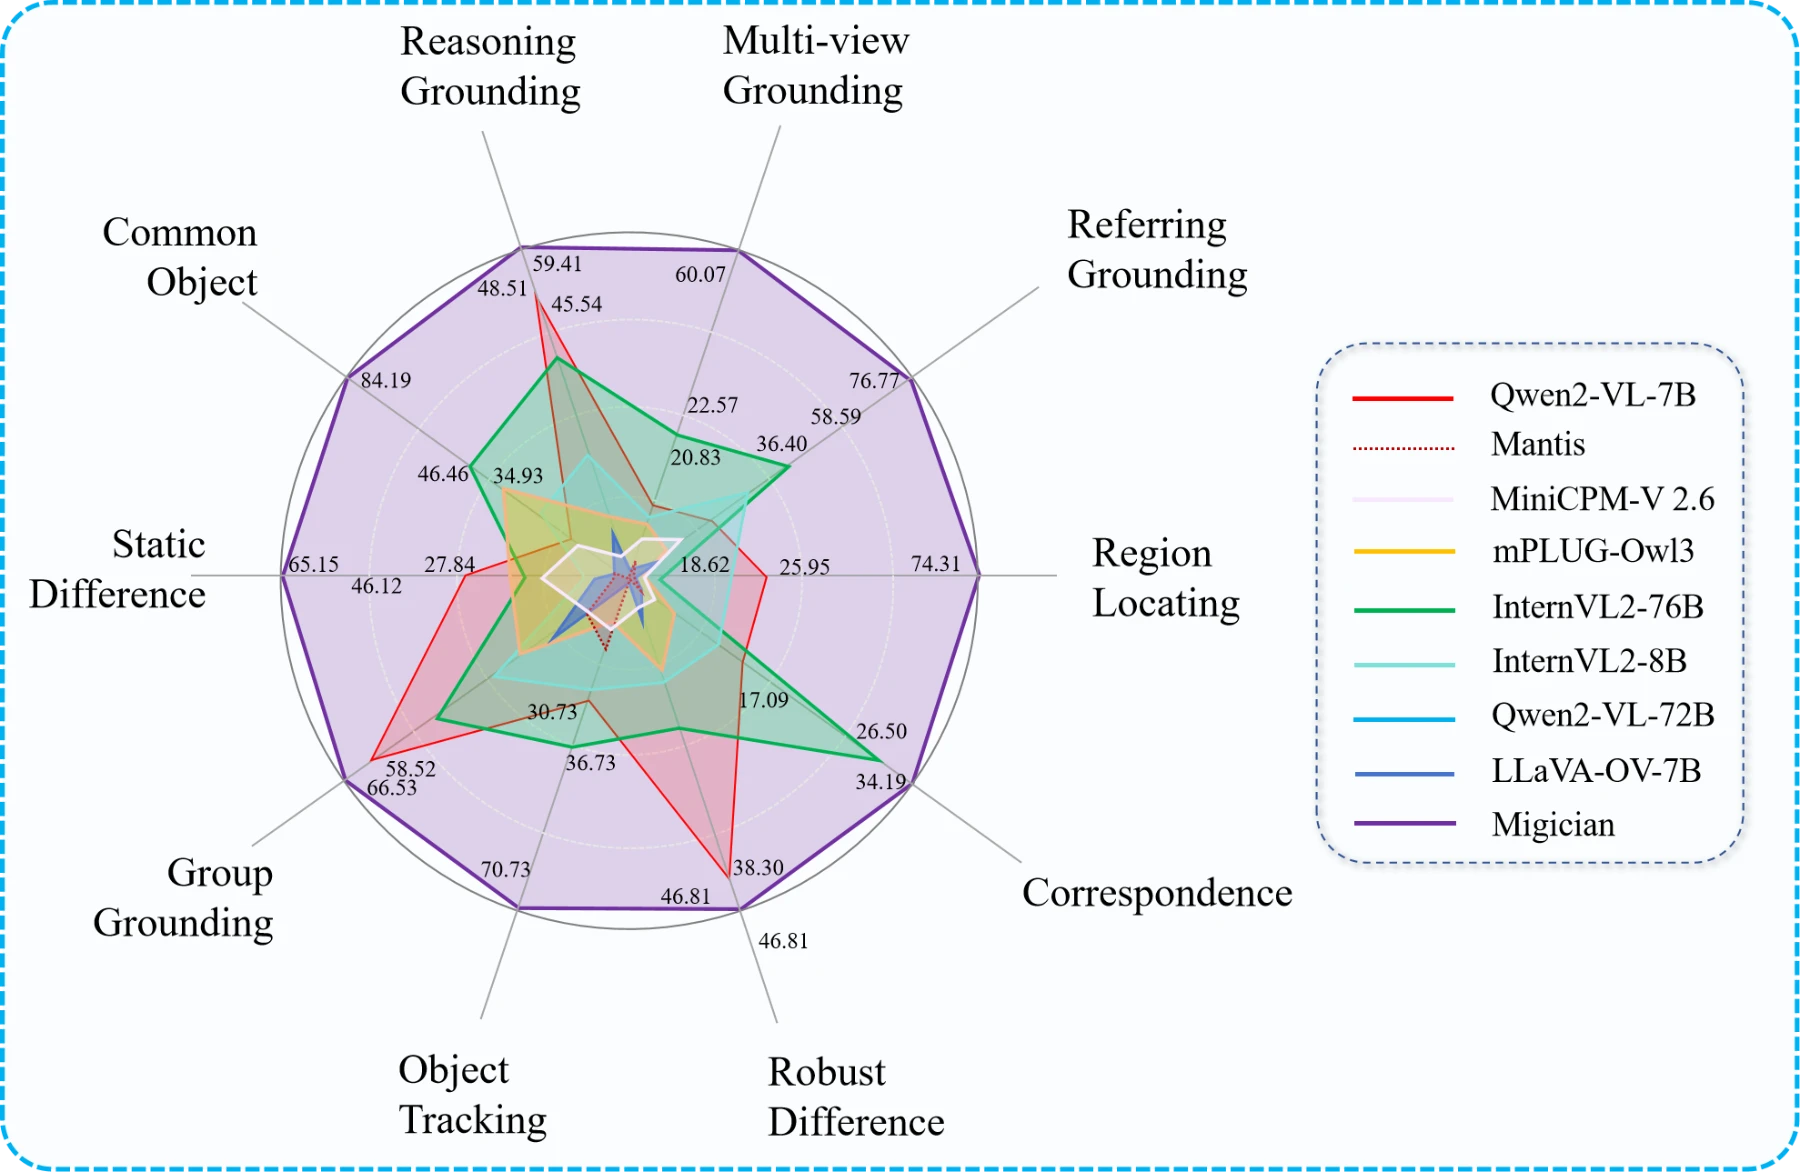
성능表现: Migician은 다중 이미지 위치 지정 작업에서 뛰어난 성능을 보이며, 기존의 MLLM을 크게 능가하고, 여러 작업에서는 더 큰 70B 모델까지도 능가합니다. 구체적으로 말하면, Migician은 MIG-Bench에서 기존 최우수 MLLM 대비 21.61% 더 높은 성능을 달성했습니다.
평가 지표: MIG-Bench는 [email protected], [email protected], [email protected] 및 평균 IOU 등의 평가 지표를 제공하며, 사용자는 MIG_bench_eval.py 스크립트를 실행하여 원클릭 평가를 수행할 수 있습니다.
Migician 활용 시나리오
보안 감시: 여러 감시 카메라의 화면을 실시간으로 분석하여 의심스러운 인물, 차량 또는 이상 이벤트를 빠르게 찾아냅니다.
자율 주행: 차량의 여러 센서에서取得した 이미지 정보를 융합하고, 도로, 장애물, 교통 표지 등에 대한 텍스트 설명을 결합하여 차량이 주변 환경을 보다 정확하게 인지하도록 돕습니다.
의료 영상: 여러 장의 의료 영상에서 병변 영역을 빠르게 찾아내어 질병 진단을 보조합니다.
로봇 휴머노이드 지능: 로봇이 복잡한 환경에서 목표 물체를 빠르게 찾아내어 파지, 운반 등의 작업을 수행하도록 돕습니다.
Migician 프로젝트 리소스
GitHub 저장소:https://github.com/thunlp/Migician
논문 주소:https://arxiv.org/pdf/2501.05767
Migician은 다중 이미지 위치 지정 작업을 전용으로 수행하는 강력한 도구로, 대규모 데이터셋 MGrounding-630k와 종합 테스트 벤치마크 MIG-Bench를 통해 다중 이미지 시나리오에서의 위치 지정 능력이 현저히 향상되었습니다.









