
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
VLM-R1: 더 높은 안정성과 일반화 능력을 갖춘 R1 스타일 시각-언어 모델
小编 ·

VLM-R1: 더 높은 안정성과 일반화 능력을 갖춘 R1 스타일 시각-언어 모델
VLM-R1이란 무엇인가요?
VLM-R1(Visual Language Model - R1)은 Om ai Lab 팀이 개발한全新的 오픈 소스 비전 언어 모델입니다. 그 핵심은 DeepSeek R1 방법을 시각 언어领域에 성공적으로迁移하여 더 높은 안정성과 일반화 능력을实现한 것입니다.
VLM-R1은 Qwen2.5-VL을 기반으로 구축되었으며, 강화 학습을 통해 시각 이해 능력을 향상시켰습니다. 시각 작업, 특히 도메인 간 데이터 이해에서 전통적인 SFT 모델보다 뛰어난 성능을 보이며, 강력한 시각 콘텐츠 이해 능력을 보여주었고, 이는 다중 모달 AI 발전의 중요한 돌파구 중 하나입니다.
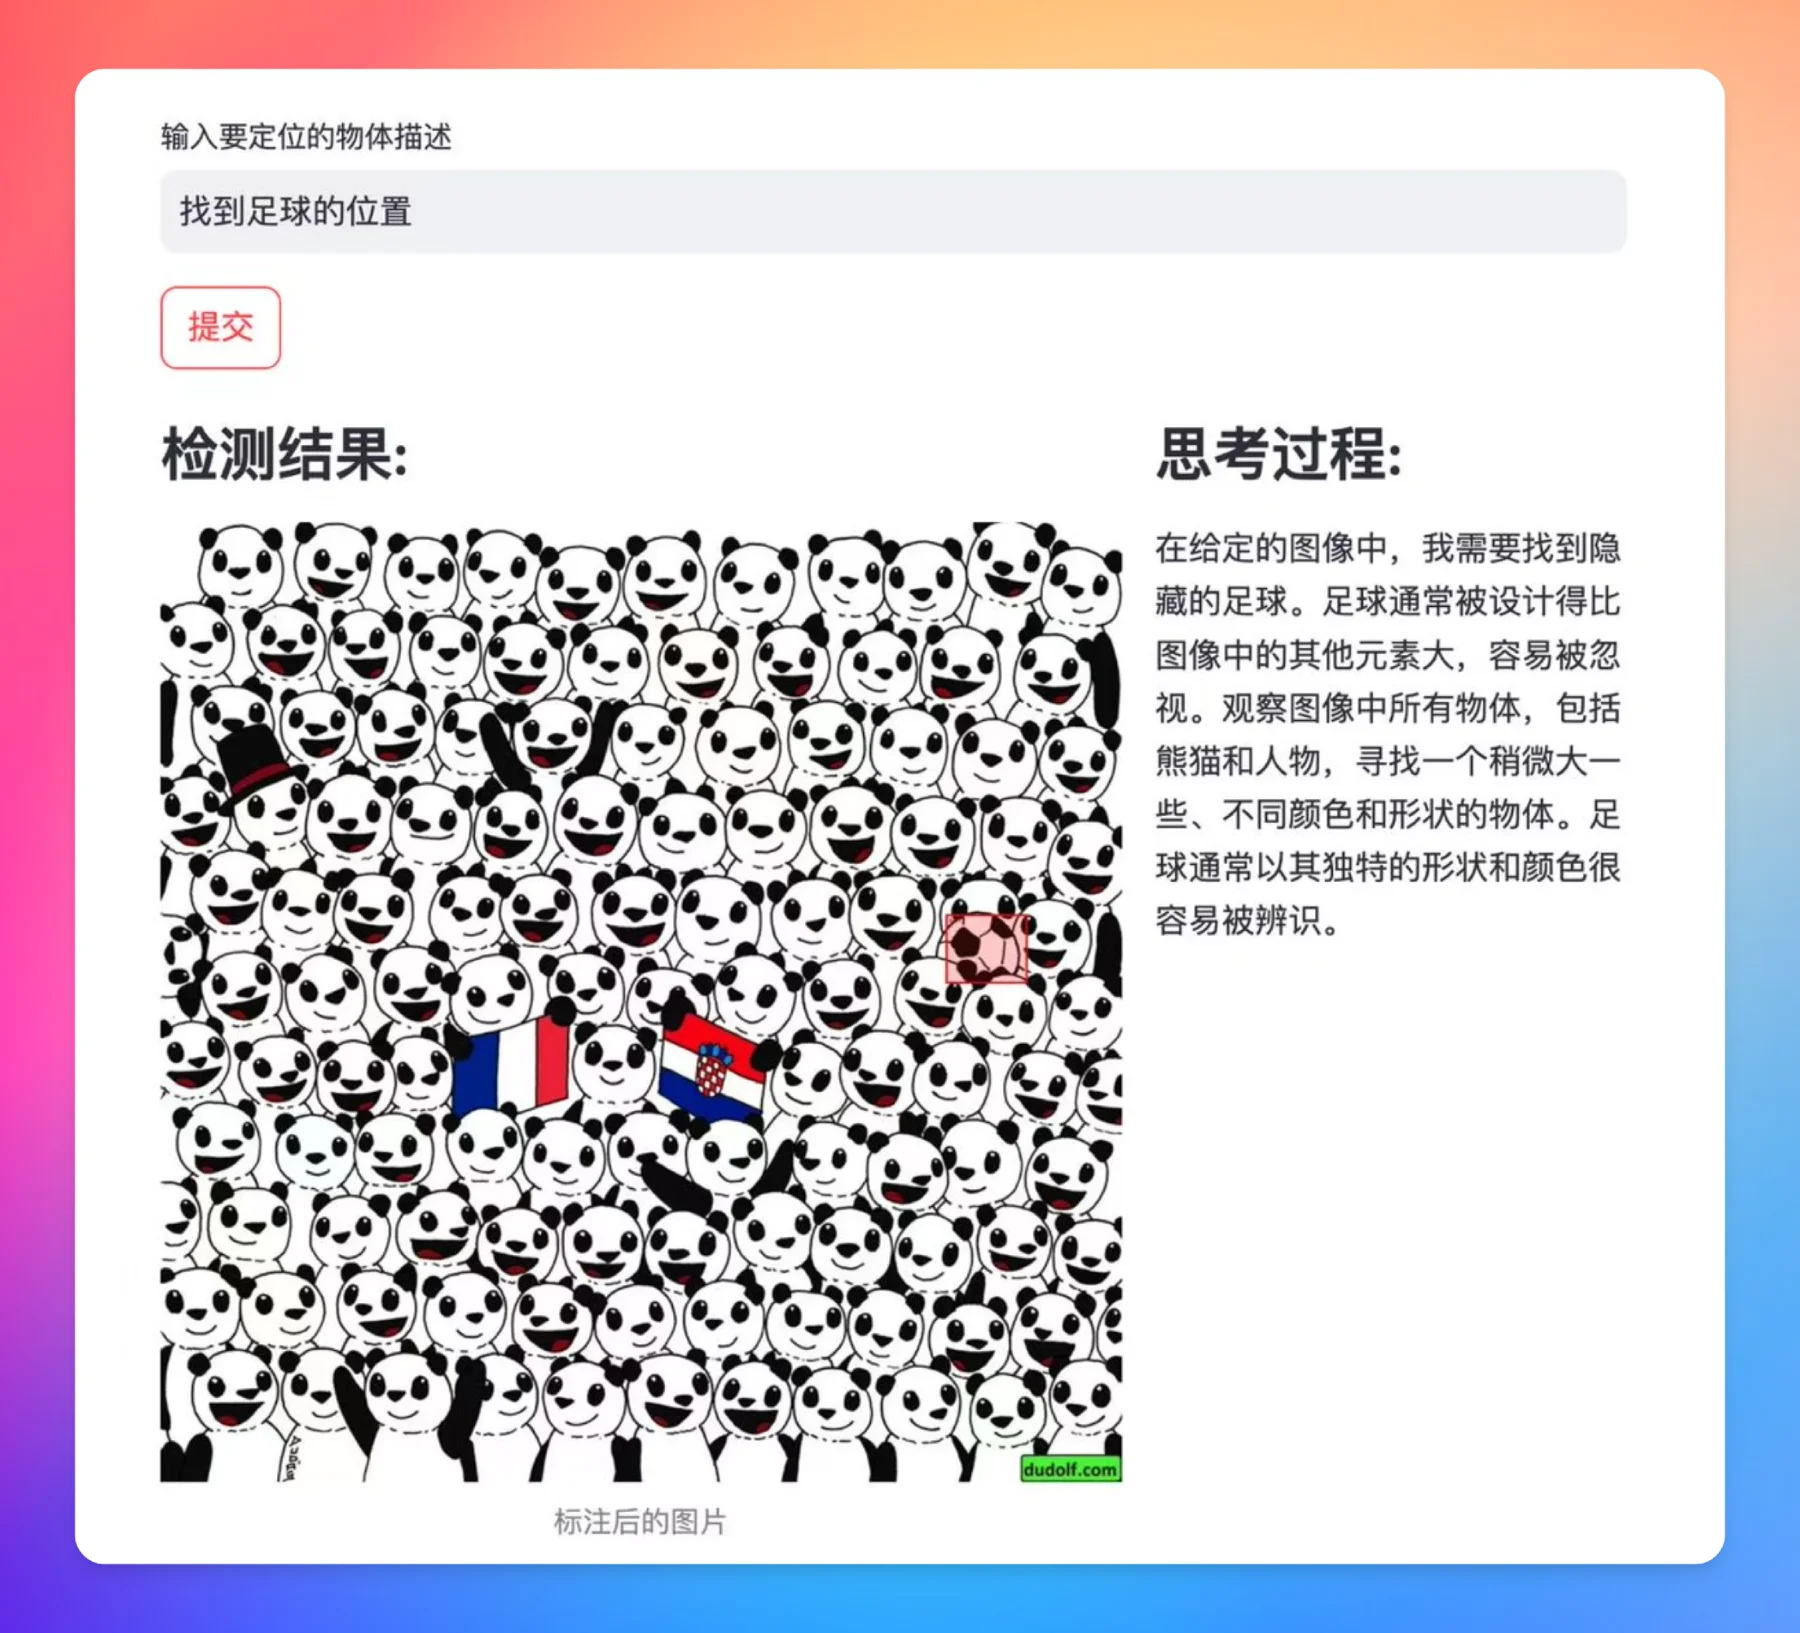
VLM-R1의 기술적 배경:
VLM-R1의灵感은 작년 DeepSeek 팀이 오픈 소스로 공개한 R1 방법에서 왔으며, 이 방법은 GRPO(Group Relative Policy Optimization) 강화 학습 기술을 사용하여 순수 텍스트 대형 모델에서显著的 효과를 거두었습니다. VLM-R1 팀은 이 방법을 시각 언어 모델에 적용하여 다중 모달 분야의 새로운局面을 성공적으로 열었습니다.
VLM-R1의 주요 특징:
도메인 간 견고성:VLM-R1은 복잡하고 변화가 많은 애플리케이션 환경에서도 높은 수준의 성능을 유지할 수 있습니다.
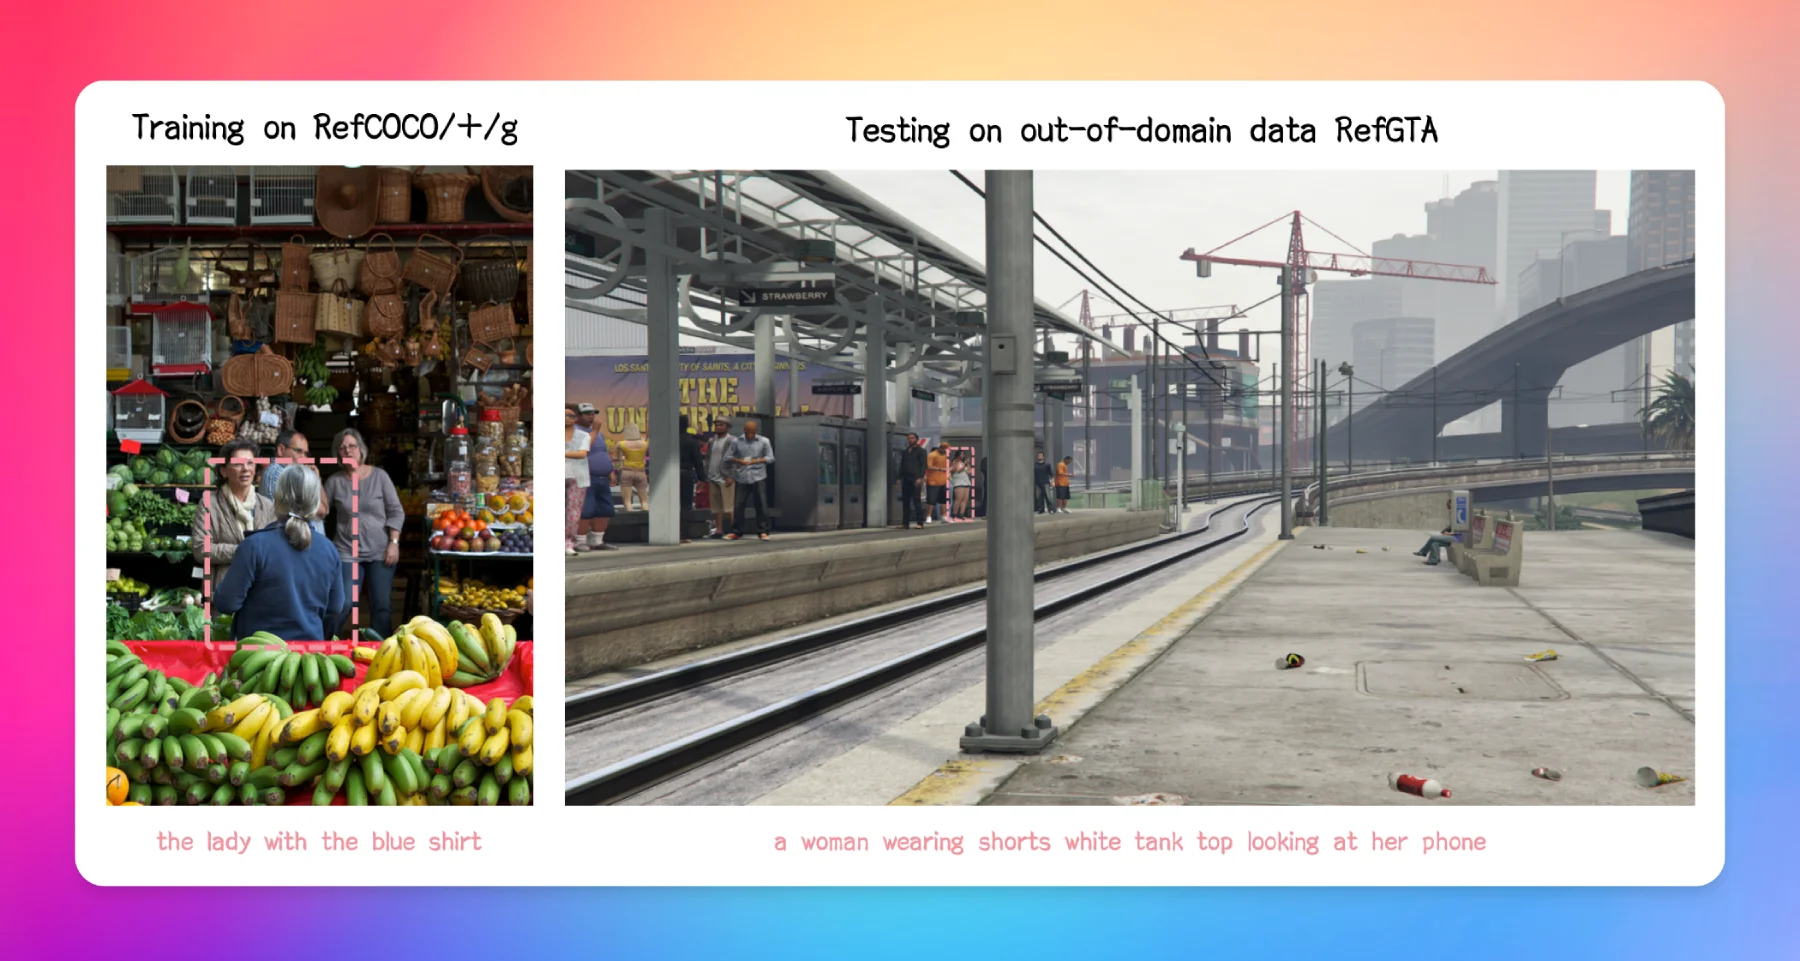
뛰어난 일반화 능력:기존의 지도 미세 조정(SFT)과 달리, VLM-R1은 보지 못한 작업이나 데이터 분포 밖에서도 시간이 지남에 따라 성능이 지속적으로 향상되어 강력한 적응성과 유연성을 보여줍니다.
뛰어난 사용 편의성:완전한 학습 및 평가 프로세스를 통해 사용자는 몇 단계의 조작만으로 빠르게 시작하고 실험을 진행할 수 있으며, 이는 첨단 AI 기술을 활용하고자 하는 연구자와 엔지니어에게 매우 편리합니다.
효율적인 자원 활용률:동적 최적화 기술을 통해 단일 GPU로 대규모 파라미터(최대 수십억 수준)의 모델을 학습할 수 있어 하드웨어 비용门槛을 낮추면서 효율성을 향상시킵니다.
VLM-R1의 기술 구현:
VLM-R1은 Qwen2.5-VL을 기반으로 R1과 전통적인 SFT 방법을 비교했습니다. 결과는 R1 모델이 안정성, 일반화 능력 및 이해 심층성 등 방면에서 모두 전통적인 SFT 모델보다 우수함을 보여주었습니다. 또한 VLM-R1은 실제 사례를 통해 시각 인식, 지식 추론 및 텍스트 표현 방면의 전문 능력을展示했습니다.
VLM-R1의 애플리케이션 시나리오:
VLM-R1은 여러 실제 애플리케이션에서 뛰어난 성능을 보였습니다. 예를 들어, 스마트 어시스턴트, 자율 주행 시스템 및 가상 현실 등에서 강력한 처리 능력과 유연성으로 인해 다중 모달 상호작용에서 광범위한 적용 잠재력을 갖추고 있습니다. 구체적인 데모 사례에서 다양한 재료가 포함된 사진을 제공했을 때, VLM-R1은 그 중 단백질 함량이 높은 음식——계란전을 정확하게 식별하고 그 이유를 추가로 설명했습니다. 또한 이미지에 표시된 객체의 위치를 정확하게 파악하여 뛰어난 텍스트 생성, 논리 추론 및 시각 인식 종합 능력을充分히 보여주었습니다.
VLM-R1의 관련 링크:
GitHub 저장소:https://github.com/om-ai-lab/VLM-R1
데모:https://huggingface.co/spaces/omlab/VLM-R1-Referral-Expression









