
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
LLM 궁극 훈련 가이드: 대규모 GPU 클러스터에서 대규모 언어 모델 학습 (중국어판)
小编 ·

LLM 궁극 훈련 가이드: 대규모 GPU 클러스터에서 대규모 언어 모델 학습 (중국어판)
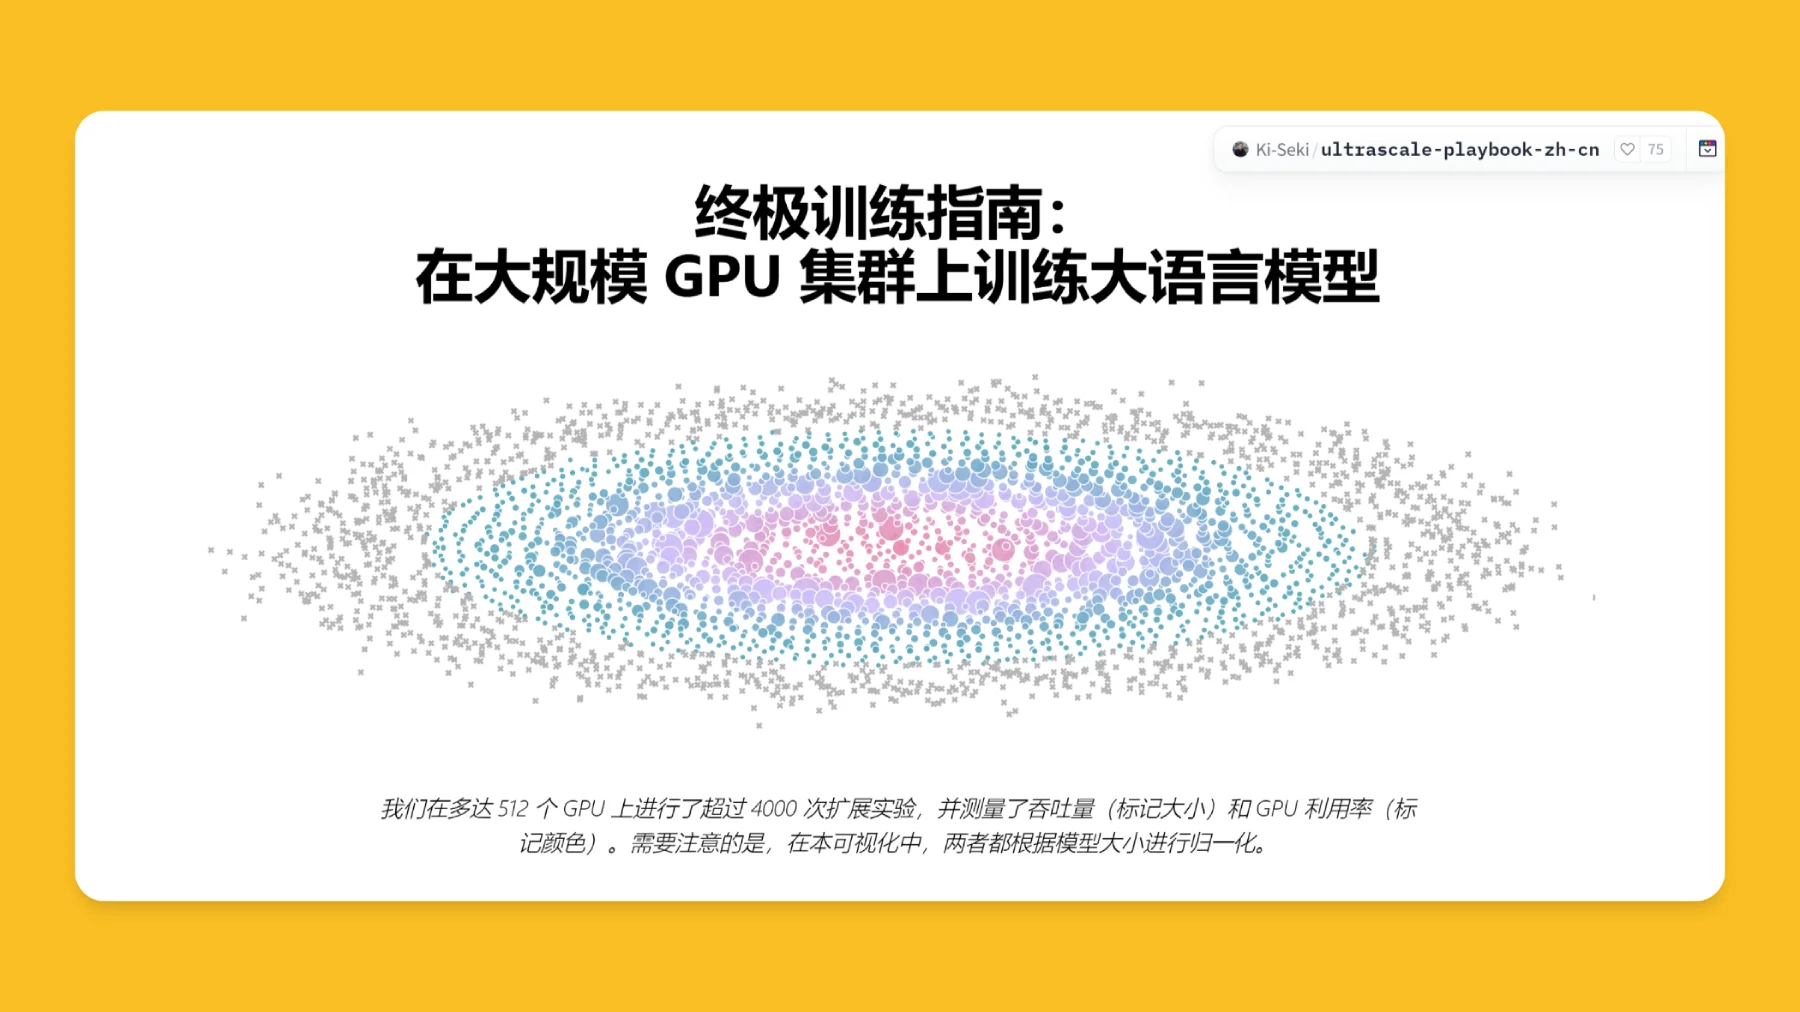
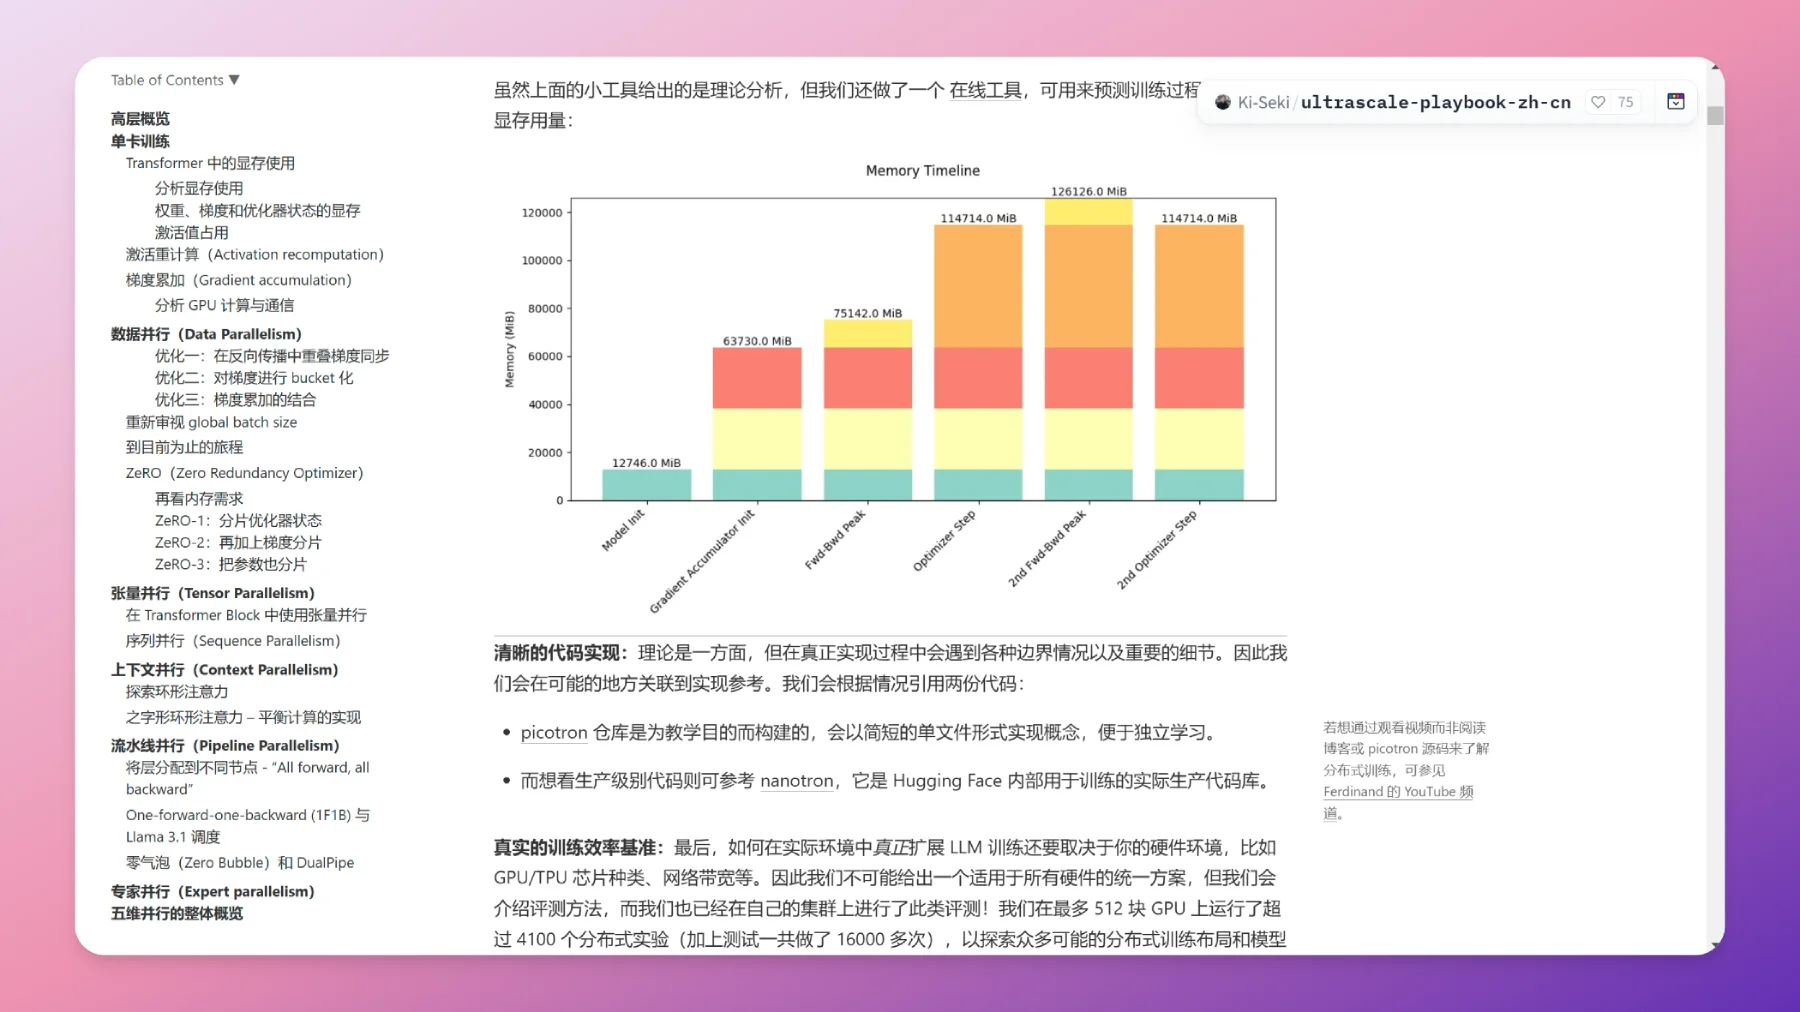
Hugging Face는 Ultra - Scale Playbook이라는 가이드를 출시했습니다. 중국어 제목은 LLM 최종 훈련 가이드: 대규모 GPU 클러스터에서 ai 대규모 언어 모델 훈련하기이며, 기초부터 출발하여 사용자가 대규모 GPU 클러스터에서 대규모 언어 모델(LLM) 훈련을 확장할 수 있도록 방향을 제시합니다. 이 가이드는 1개에서 1,000개 이상의 GPU 클러스터에 걸친 훈련에 대한 포괄적인 지침을 제공하며, 최대 512개의 GPU에서의 확장 실험 결과도展示하고 처리량과 GPU 활용률 같은 데이터를 상세히 분석합니다.
원문: The Ultra-Scale Playbook: Training LLMs on GPU Clusters
교정자: @Ki_Seki_here
LLM 최종 훈련 가이드 중국어판 웹사이트: https://huggingface.co/spaces/Ki-Seki/ultrascale-playbook-zh-cn
아직 교정 중입니다...
연구의 배경
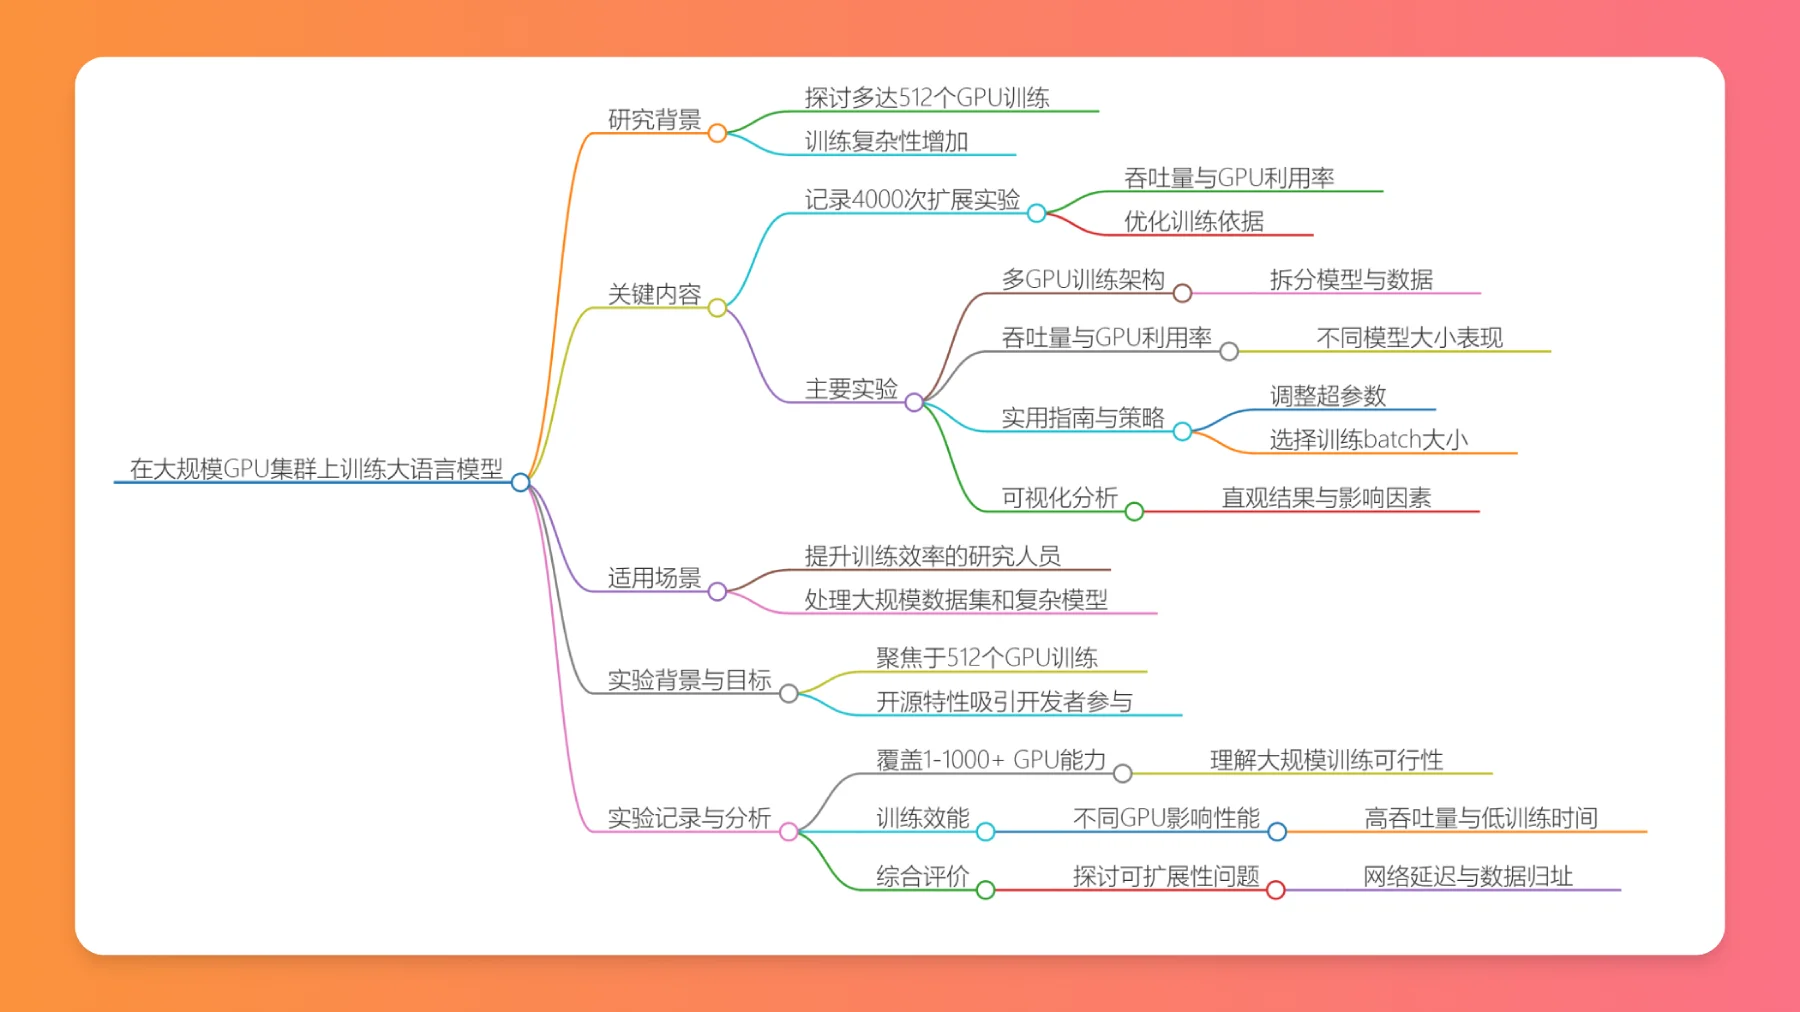
언어 모델의 규모가 계속 확장됨에 따라, 훈련 시 컴퓨팅 자원에 대한 요구가 증가하고 전략 또한 점점 더 복잡해지고 있습니다. 따라서 이 문서는 주로 최대 512개의 GPU로 구성된 클러스터에서 대규모 언어 모델(LLM) 훈련을 어떻게 수행할 것인지에 초점을 맞추고 있습니다.
주요 내용
대규모 실험 기록
문서에는 4,000회의 확장 실험이 상세히 기록되어 있습니다. 이러한 실험에서 처리량(마크 크기)과 GPU 활용률(마크 색상)이 핵심 측정 지표입니다. 이러한 데이터는 훈련 과정 최적화를 위한 신뢰할 수 있는 근거를 제공합니다.
주요 실험 내용
다중 GPU 훈련 아키텍처: 채택된 아키텍처는 모델과 데이터를 효과적으로 분할하여 여러 GPU가 관련 작업을 병렬로 처리할 수 있도록 하며, 이는 효율적인 훈련을 위한 아키텍처 기반을 제공합니다.
처리량과 GPU 활용률: 실제 실험 데이터 분석을 통해 모델 크기에 따라 성능이 달라지는 것을 확인할 수 있습니다. 이러한 분석은 개발자가 자원을 최대한 활용하는 방법을 이해하고 자신에게 적합한 훈련 방식을 찾는 데 도움이 됩니다.
실용적인 가이드와 전략: 초매개변수 조정 방법, 적절한 훈련 배치 크기 선택 등 실용적인 훈련 전략을 정리하였습니다. 이는 모두 최적의 성능을 달성하는 데 있어 중요한 요소입니다.
시각화 분석: 문서에는 다양한 시각화 결과가 포함되어 있습니다. 이러한 결과를 통해 사용자는 확장 실험의 결과와 그背后的 영향 요인을 직관적으로 이해할 수 있어, 복잡한 실험 결과를 쉽게 해석할 수 있습니다.
대상 독자
이 가이드는 특히 대규모 데이터셋과 복잡한 모델을 다루는 연구자와 엔지니어로서, 대규모 언어 모델 훈련 효율을 높이고자 하는 사람들에게 적합합니다.
실험 관련 고려 사항
문서의 특징과 목표
이 문서는 단순히 512개의 GPU에서 훈련하는 방법만을 다루는 것이 아니라, 오픈소스라는 특성도 강조합니다. 이를 통해 더 많은 개발자가 참여하고 이러한 훈련 방법을 활용할 수 있게 됩니다.
실험 기록 범위
실험 기록의 범위는 1개의 GPU에서부터 1,000개 이상의 GPU에 이르는 확장 능력을 포괄합니다. 이는 대규모 클러스터에서 LLM을 훈련할 때의 실현 가능성과 효율성을 이해하는 데 도움이 되는 포괄적인 프레임워크를 구성합니다.
훈련 효율성 분석
서로 다른 GPU 개수가 훈련 성능에 미치는 영향을 관찰할 때, 저자들은 일부 모델이 확장 과정에서 더 높은 처리량을 갖고 훈련 시간이 더 짧다는 것을 발견했습니다. 이러한 발견은 개발자가 GPU 개수와 구성을 선택할 때 보다 구체적인 권장 사항을 제공하는 데 활용될 수 있습니다.
종합적 고려 사항
성능 지표에 대한 관심 외에도, 이 실험은 실제 응용에서의 확장성 문제를 깊이 탐구합니다. 또한 네트워크 지연, 데이터 귀속(归址)과 같이 실제 환경에서 마주칠 수 있는 일부 도전 과제도 연구하는데, 이는 대규모 훈련을 수행할 때 간과할 수 없는 요소들입니다.









