
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
OSUM: 서북공업대학이 오픈소스로 공개한 다중 음성 처리 과제 지원 음성 모델
小编 ·

OSUM: 서북공업대학이 오픈소스로 공개한 다중 음성 처리 과제 지원 음성 모델
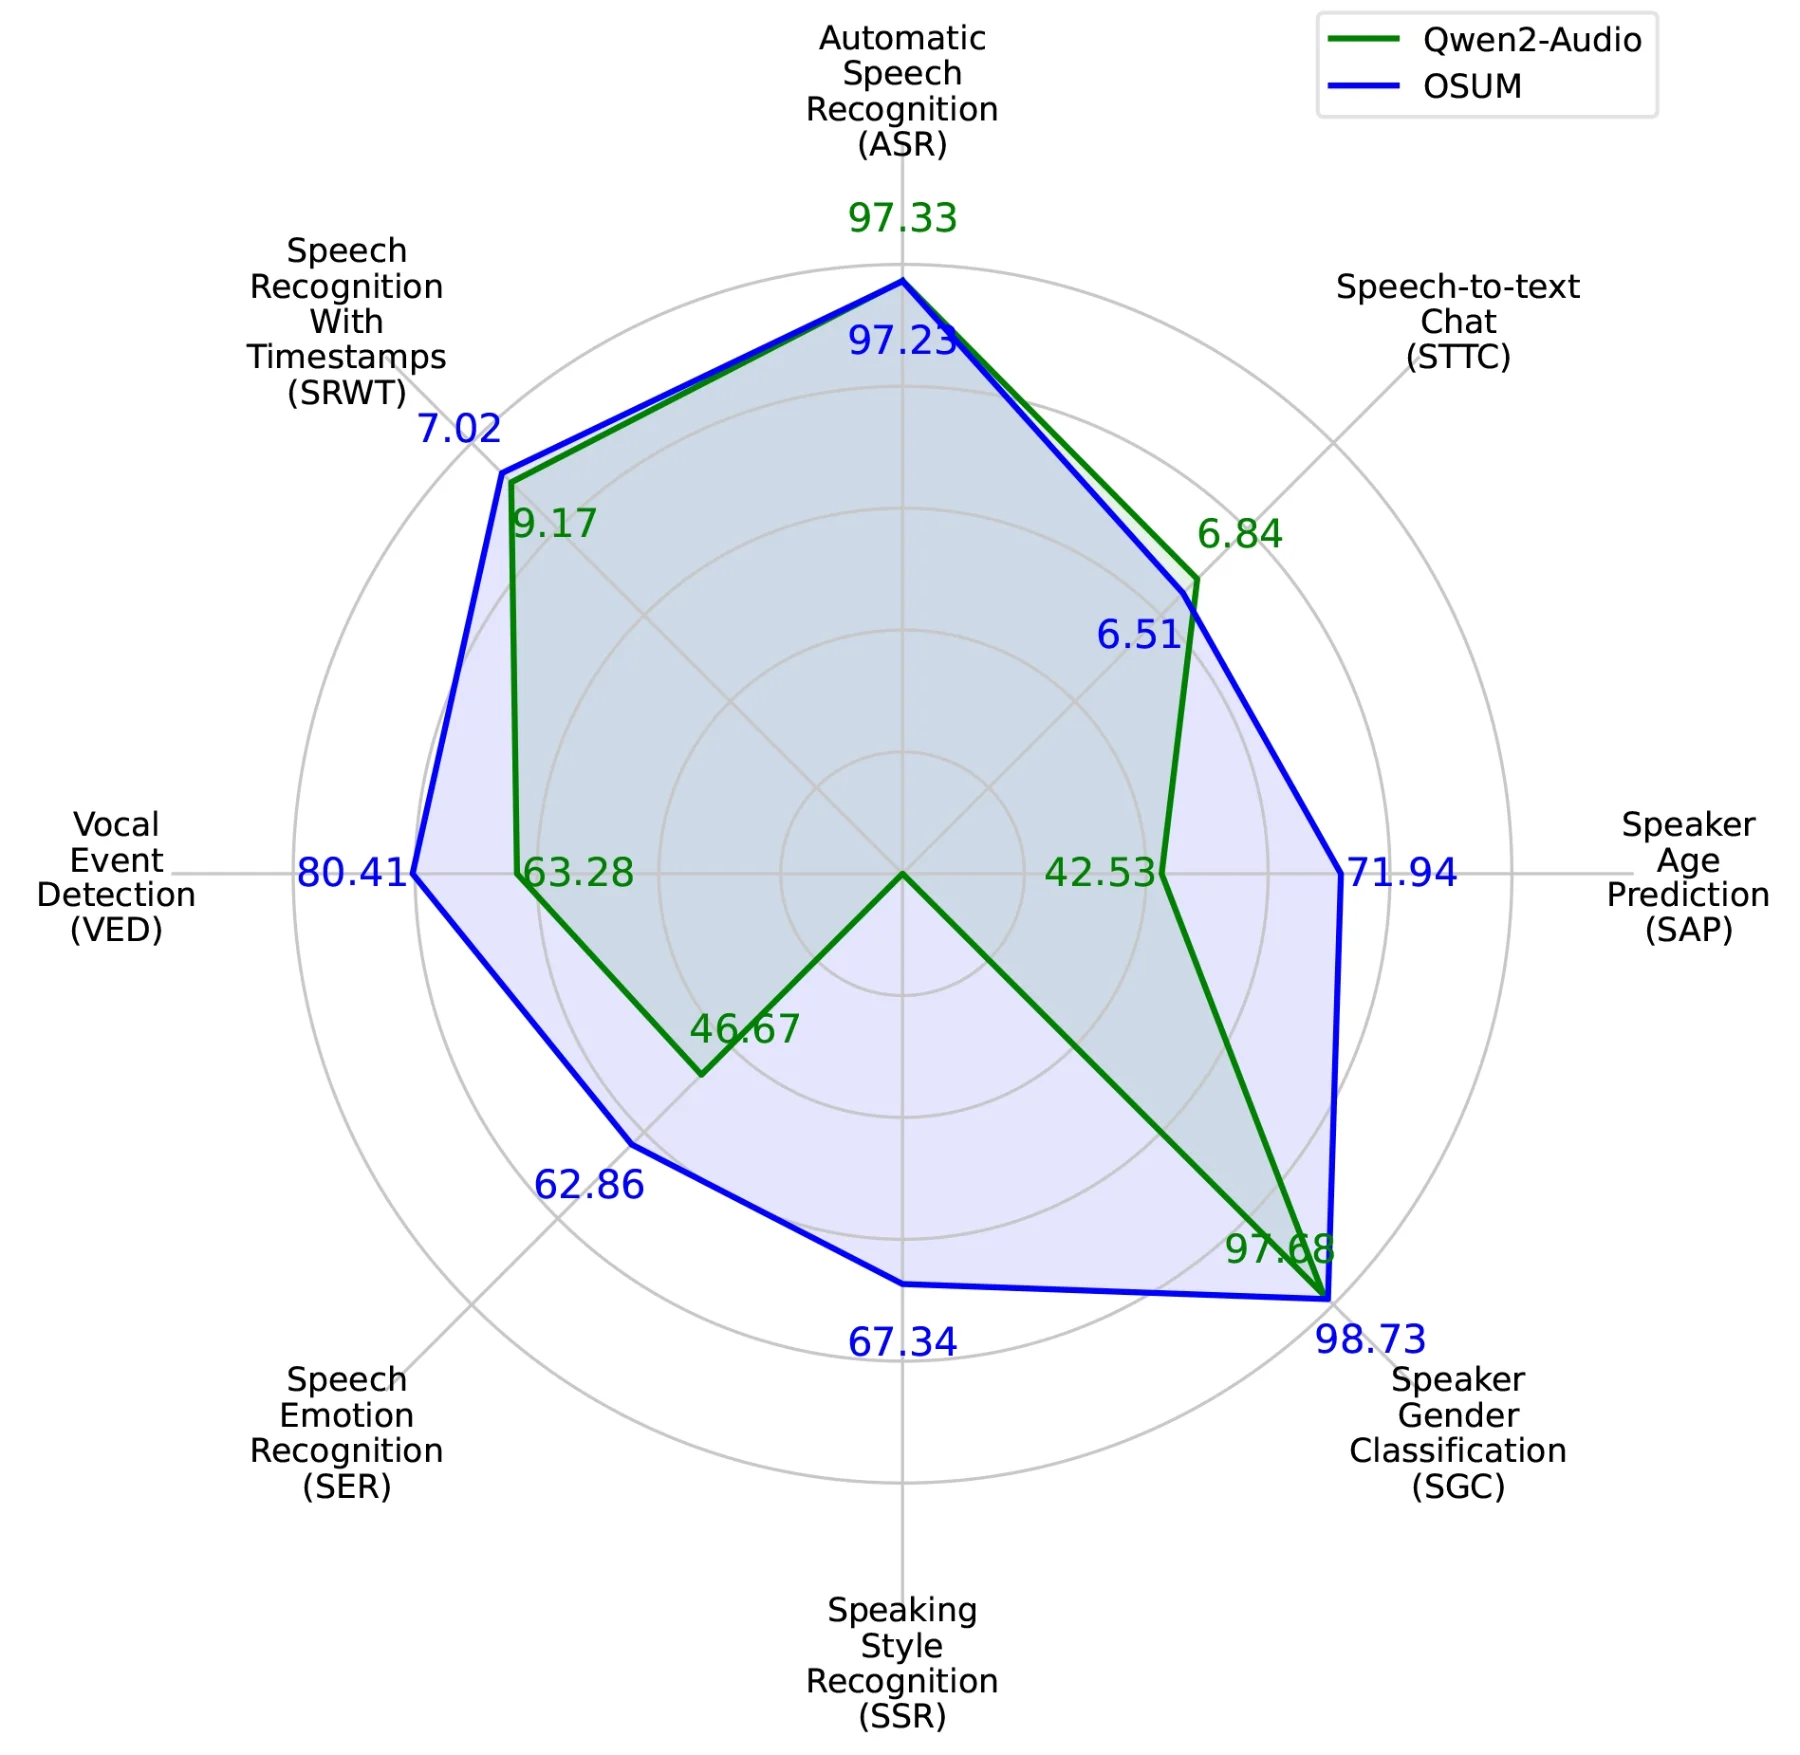
OSUM(Open Speech Understanding Model)은 서북공업대학교 컴퓨터 사이언스 및 기술学院 오디오, 음성 및 언어 처리 그룹(ASLP@NPU)에서 제안하고 오픈 소스로 공개한 음성 모델로, 다양한 음성 처리 작업을 지원하는 데 사용됩니다.
OSUM 기능 특징:
다중 작업 지원:
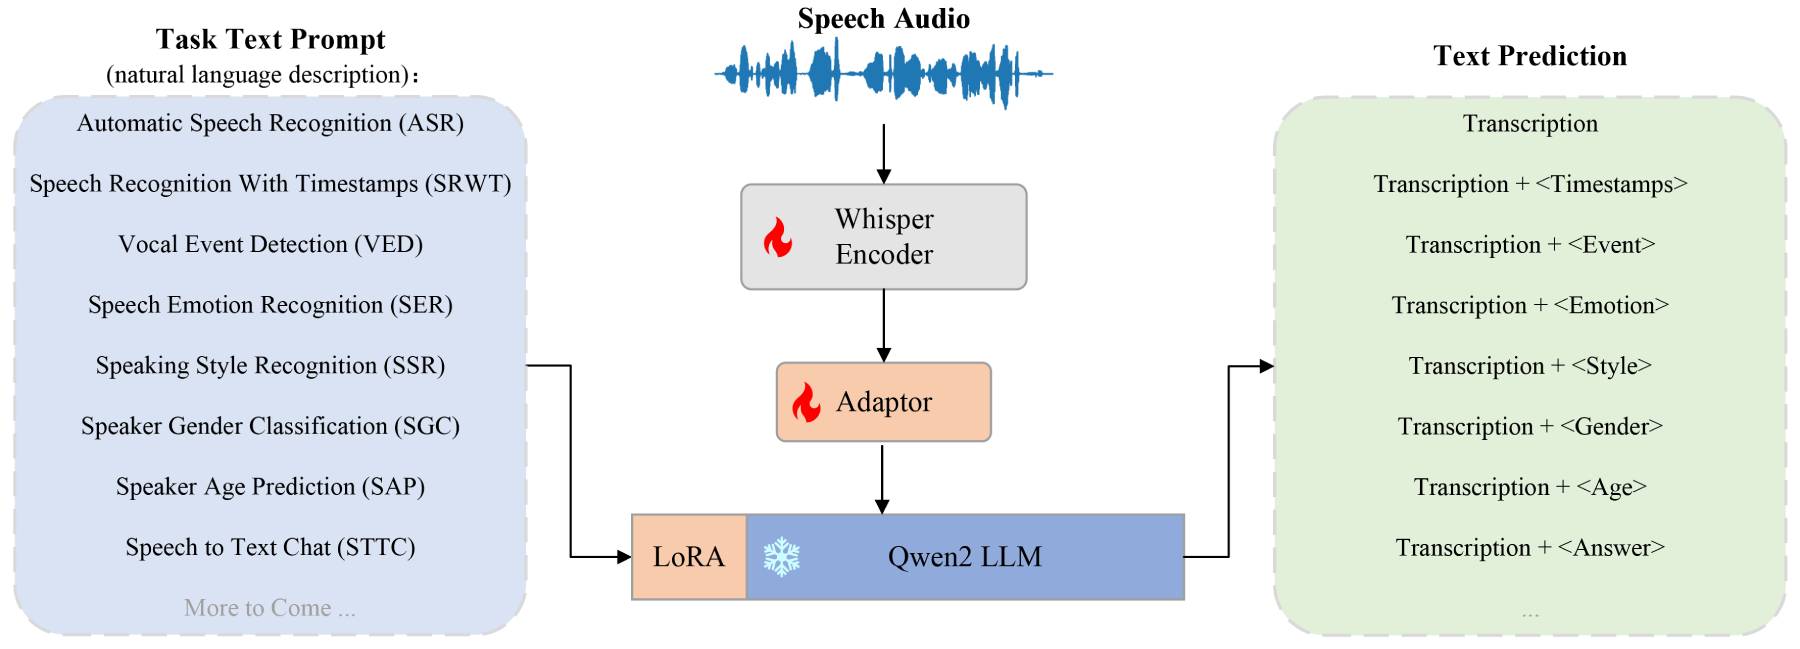
음성 인식(ASR): 음성을 텍스트로 변환합니다.
타임스탬프가 포함된 음성 인식(SRWT): 음성 내용을 인식하고 시간 정보를 표시합니다.
음성 이벤트 감지(VED): 음성 내의 특정 이벤트나 동작을 식별합니다.
음성 감정 인식(SER): 음성 내의 감정 상태를 분석합니다.
말하기 스타일 인식(SSR): 화자의 말하는 방식이나 어조를 식별합니다.
화자 성별 분류(SGC): 음성에 따라 화자의 성별을 판단합니다.
화자 연령 예측(SAP): 화자의 연령을 추정합니다.
음성-텍스트 채팅(STTC): 음성 대화를 읽을 수 있는 텍스트로 변환합니다.
모델 아키텍처:OSUM은 Whisper 인코더와 Qwen2 대규모 언어 모델(LLM)을 결합하고, LORA 기술을 사용하여 LLM을 미세 조정함으로써 효율적인 다중 작업 학습을 구현합니다.
학습 전략:ASR+X 학습 전략을 채택하여 자동 음성 인식(ASR)과 보조 작업(X)을 동시에 최적화함으로써, 효율적이고 안정적인 다중 작업 학습을 실현하고 자원 소모를 줄였습니다.
심층 이해 기능:OSUM 모델은 음성 정보를 텍스트로 변환하는 능력을 갖추고 있을 뿐만 아니라 음성 내의 감정 인식도 지원하여, 사용자에게 더욱 지능화된 상호 작용 경험을 제공할 수 있습니다.
타임스탬프 지원:음성 인식에서 OSUM은 타임스탬프가 포함된 출력을 제공하여 후속 처리 및 분석을 용이하게 합니다.
다중 플랫폼 호환:화웨이 Ascend 910B 및 NVIDIA 플랫폼을 포함한 다양한 컴퓨팅 플랫폼에서 실행할 수 있도록 지원하여, 응용 프로그램의 유연성을 높였습니다.
OSUM 응용 분야:
지능형 비서: 스마트 홈, 가상 비서에서 사용자의 음성 명령을 이해하고 응답하는 데 사용됩니다.
다국어 서비스: YouTube Dubbing 플러그인과 마찬가지로 실시간 번역 및 더빙에 사용되어 언어 장벽을 허물 수 있습니다.
감정 분석: 고객 서비스, 정신 건강 응용 분야에서 사용자의 감정을 분석하고 맞춤형 서비스를 제공합니다.
교육 분야: 학생의 말하기 과제를 자동으로 평가하고 피드백을 제공합니다.
접근성 기술: 청각 장애인이 음성 정보를 이해하도록 돕습니다.
시장 조사: 소비자 피드백의 감정과 의견을 분석합니다.
음성 전사: 회의 기록, 구술 텍스트 변환 등의 상황에서 OSUM을 활용하여 효율적인 음성 전사를 수행합니다.
OSUM 사용 방법:
설치 및 임포트:사용자는 Hugging Face 페이지 또는 GitHub 프로젝트 페이지에서 OSUM의 코드와 모델 가중치를 다운로드하고 제공된 설치 가이드에 따라 설치할 수 있습니다. Python 환경에 OSUM 모델을 임포트하는 예제 코드는 다음과 같습니다:
from osum import OSUM
model = OSUM.from_pretrained("ASLP-lab/OSUM")
작업 실행:사용자는 OSUM 모델을 사용하여 음성 인식 등 다양한 음성 작업을 수행할 수 있습니다. 다음은 음성 인식 작업의 예제 코드입니다:
result = model.transcribe("audio.wav")
print(f"인식 결과:{result}")
사용 방법 측면에서, 사용자는 사전 학습된 모델 체크포인트를 활용하여 미세 조정을 수행함으로써 특정 작업에서 모델의 성능을 더욱 향상시킬 수 있습니다.
GitHub:https://github.com/ASLP-lab/OSUM
프로젝트:https://aslp-lab.github.io/OSUM.github.io/









