
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
SWE-Lancer: OpenAI推出的 오픈소스 소프트웨어 공학 능력 평가 벤치마크
小编 ·

SWE-Lancer: OpenAI推出的 오픈소스 소프트웨어 공학 능력 평가 벤치마크
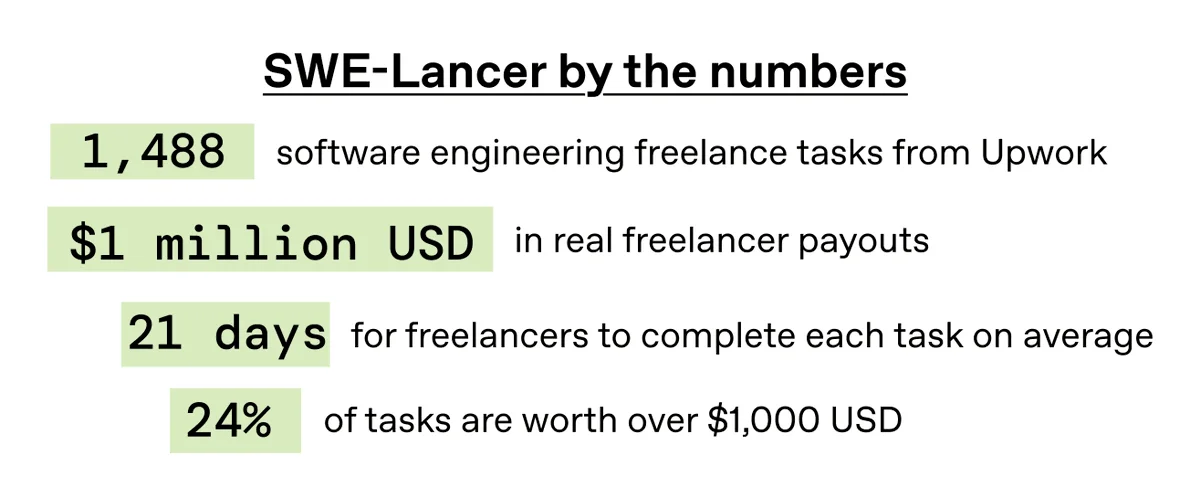
SWE-Lancer는 OpenAI가 출시한 벤치마크로, 주로 개방형 소프트웨어 엔지니어링 작업을 처리하는 모델의 성능을 평가하는 데 사용됩니다. 이 테스트는 Upwork에서 수집한 1,400개 이상의 과제를 포함하며, 총 가치는 약 100만 달러에 달합니다. SWE-Lancer는 코드 패치와 관리 의사 결정 평가를 중점적으로 다루며, 모델이 여러 선택지 중에서 최적의 제안을 선택하도록 함으로써 엔지니어링 팀의 역할 수행 시나리오를 최대한 사실적으로 모사합니다.
핵심 평가 차원:
평가 과제의 다양성 측면
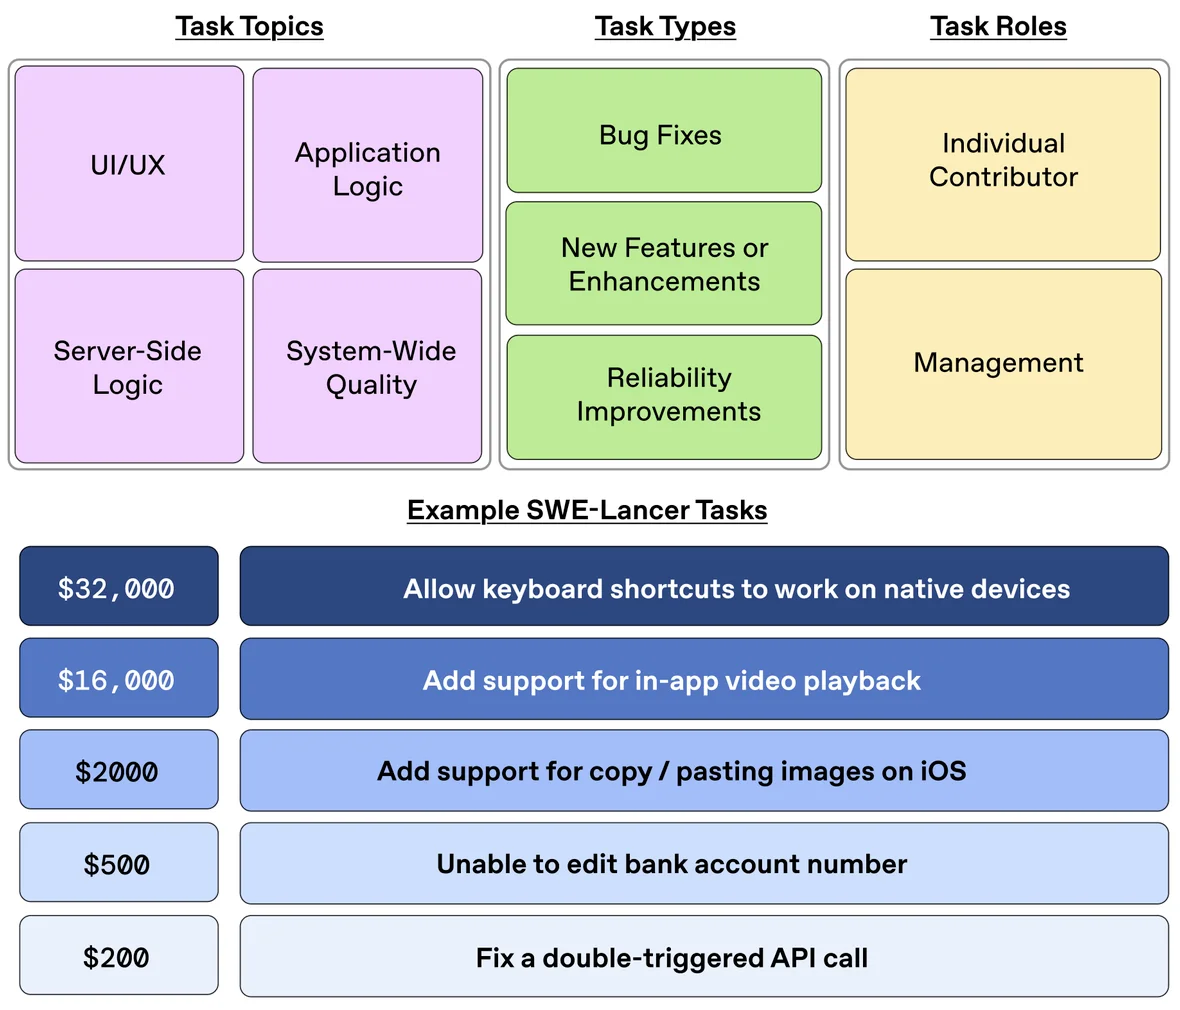
SWE-Lancer는 다양한 유형의 소프트웨어 개발 과제를 포괄하여 모델 능력을 분석하는 데 매우 효과적인 도구입니다. 이 벤치마크는 모델이 주어진 여러 선택지 중에서 최적의 해결책을 선택하도록 요구하며, 이러한 방식은 엔지니어링 팀의 작업 흐름을 보다 현실적으로 반영합니다.
경제적 가치 평가 측면
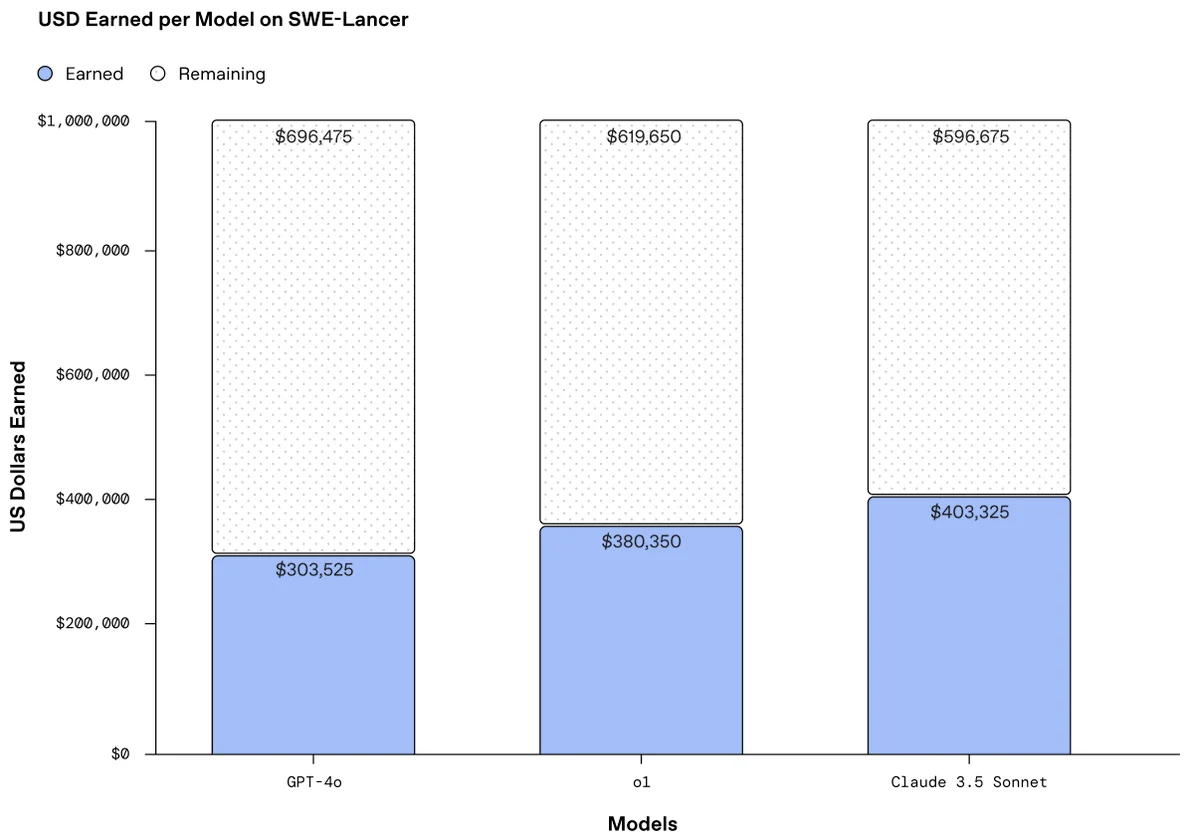
이 벤치마크는 단순히 기술적 능력을 평가하는 데 그치지 않고 과제의 경제적 가치까지 고려합니다. 이러한 평가 방법은 현실 세계 응용 상황에서 모델의 효과성을 측정하는 새로운 시각을 열어주며, 개발자가 AI 모델이 가져올 수 있는 경제적效益를 더 잘 이해할 수 있도록 도와줍니다.
SWE-Lancer의 기능적 특징:
실제 세계 과제: SWE-Lancer는 일련의 실제 소프트웨어 개발 과제를 포함하며, 이 과제들은 미세한 버그 수정부터 대규모 기능 구현까지 폭넓게 다루어 모델이 실제 개발 시나리오에서 효과적으로 평가될 수 있도록 보장합니다.
엔드 투 엔드 테스트: 기존의 유닛 테스트와 달리, SWE-Lancer는 엔드 투 엔드 테스트 방식을 채택하여 모델이 완전한 문제를 처리할 수 있는 능력을 갖추도록 요구하며, 이는 소프트웨어 엔지니어가 실제 업무에서 의사 결정을 내리는 절차에 더 가깝습니다.
다중 선택지 평가: 모델은 여러 가능한 해결책 중에서 최적의 제안을 선택해야 하며, 이는 엔지니어링 팀이 문제에 직면했을 때 의사 결정을 내리는 과정을 모사합니다.
경제적 가치 매핑: 과제의 총 가치가 100만 달러에 달하며, 이는 한편으로 과제의 복잡성과 중요성을 보여주고 다른 한편으로는 모델 성능이 발생시킬 수 있는 잠재적 경제적 영향을 드러냅니다.
SWE-Lancer의 응용:
모델 성능 평가: 연구자와 개발자에게 테스트 플랫폼을 제공하여 대규모 언어 모델의 소프트웨어 엔지니어링 과제 수행 능력을 시험하고 비교할 수 있게 합니다.
소프트웨어 개발 지원: 장기적으로 볼 때, SWE-Lancer는 소프트웨어 개발에서 인공지능의 응용을 최적화하는 데 도움을 줄 수 있으며, 예를 들어 자동 코드 리뷰, 오류 수정 제안 등을 포함합니다.
교육 및 훈련: 학생과 개발자가 소프트웨어 엔지니어링의 모범 사례 및 직면하는 과제를 이해할 수 있도록 돕는 교육 도구로 활용될 수 있습니다.
업계 표준: 소프트웨어 엔지니어링 분야에서 인공지능의 실용성을 평가하는 업계 표준이 될 가능성이 있습니다.
SWE-Lancer 사용 방법:
과제 선택: SWE-Lancer에서 제공하는 과제 목록에서 평가할 과제를 하나 또는 여러 개 선택합니다.
모델 처리: 선택한 과제를 인공지능 모델에 입력하면, 모델은 자체 학습 상황과 능력에 따라 과제를 실행합니다.
결과 평가: 모델이 생성한 결과를 평가하여 사전 설정된 품질 기준에 부합하는지 확인하고, 과제의 경제적 가치에 따라 분석합니다.
논문:https://arxiv.org/abs/2502.12115
자세히 보기:https://openai.com/index/swe-lancer/









