
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
NSA: DeepSeek의 초장문 컨텍스트 학습·추론 가속화 기술
小编 ·

NSA: DeepSeek의 초장문 컨텍스트 학습·추론 가속화 기술
DeepSeek 팀이 2025년 2월 18일 NSA(Native Sparse Attention)라는 혁신적인 어텐션 메커니즘을 출시했습니다. NSA는 긴 텍스트 처리 과정에서 발생하는 계산 효율성과 성능 장애를 해결하는 데 주력하며, 하드웨어 일관성 설계와 네이티브 학습 지원을 통해 추론 속도를 크게 높이고 사전 학습 비용을 절감할 수 있습니다.
NSA의 주요 특징:
하드웨어 친화적: 다양한 하드웨어 아키텍처와의 호환성을 고려하여 설계되어 학습 효율성을 높이는 것을 목표로 합니다.
로컬 학습 능력: 데이터 위에서 직접 학습할 수 있도록 지원하여 모델의 적응성과 유연성을 강화합니다.
효율적인 추론 및 학습: 긴 컨텍스트 처리를 가속화하여 복잡한 모델의 응용을 지원하며, 텍스트 및 비디오와 같이 더 긴 시퀀스 데이터를 효과적으로 처리합니다.
동적 계층적 희소 전략: 세분화된 토큰 선택과 거친 토큰 압축 기술을 활용하여 정보를 보존하면서 계산 복잡성을 줄입니다.
비용 절감: 최적화된 설계를 통해 딥러닝 모델 학습 시 자원 소비를 크게 줄이며, 이는 시간과 계산 비용을 포함하여 연구자와 개발자에게 상당한 가치를 제공합니다.
NSA의 핵심 구성 요소:
동적 계층적 희소 전략: 거친 수준의 토큰 압축과 세분화된 토큰 선택을 결합하여 효율성을 높이는 동시에 모델이 전역 컨텍스트와 로컬 세부 정보를 인식할 수 있도록 보장합니다.
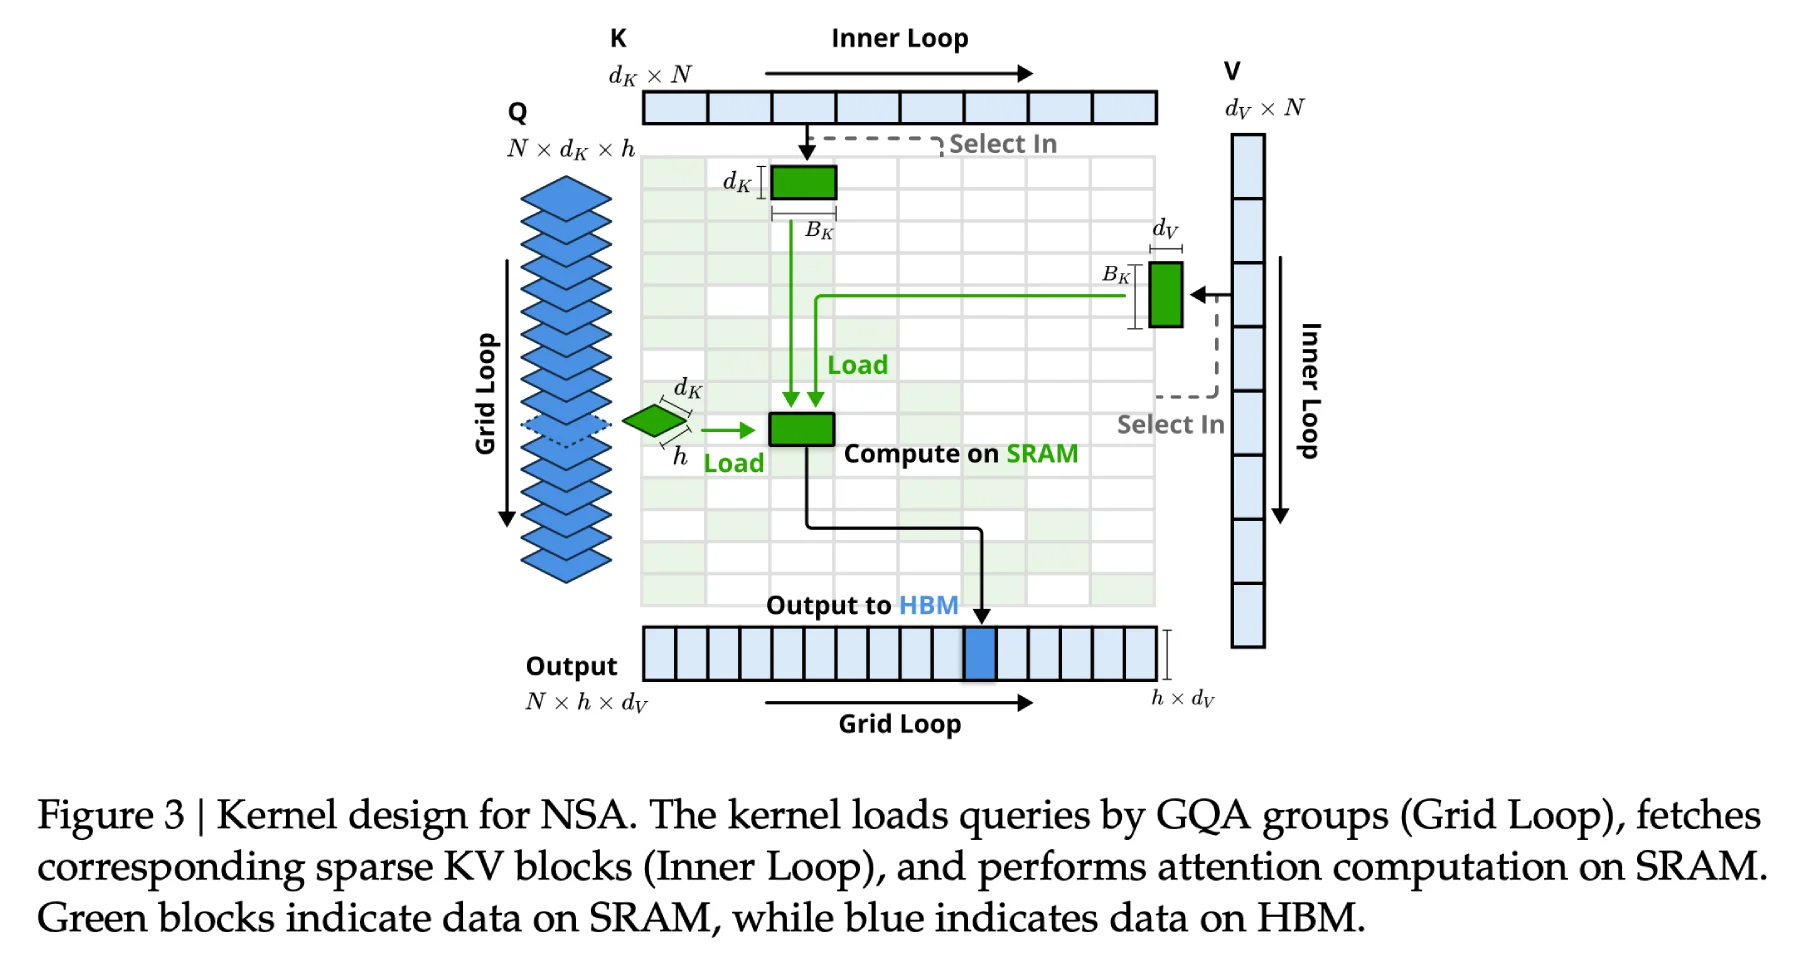
하드웨어 정렬 설계: 메모리 접근을 최적화하고 GPU 텐서 코어에 적응하며, 데이터를 블록 단위로 로드하여 중복 전송을 줄이고 병렬 효율성을 향상시킵니다.
엔드 투 엔드 학습 가능: 사전 학습에서 추론까지의 희소 계산 전 과정을 지원하여 역전파의 안정성을 유지하고 기존 희소 방식의 '학습 낙오' 문제를 방지합니다.
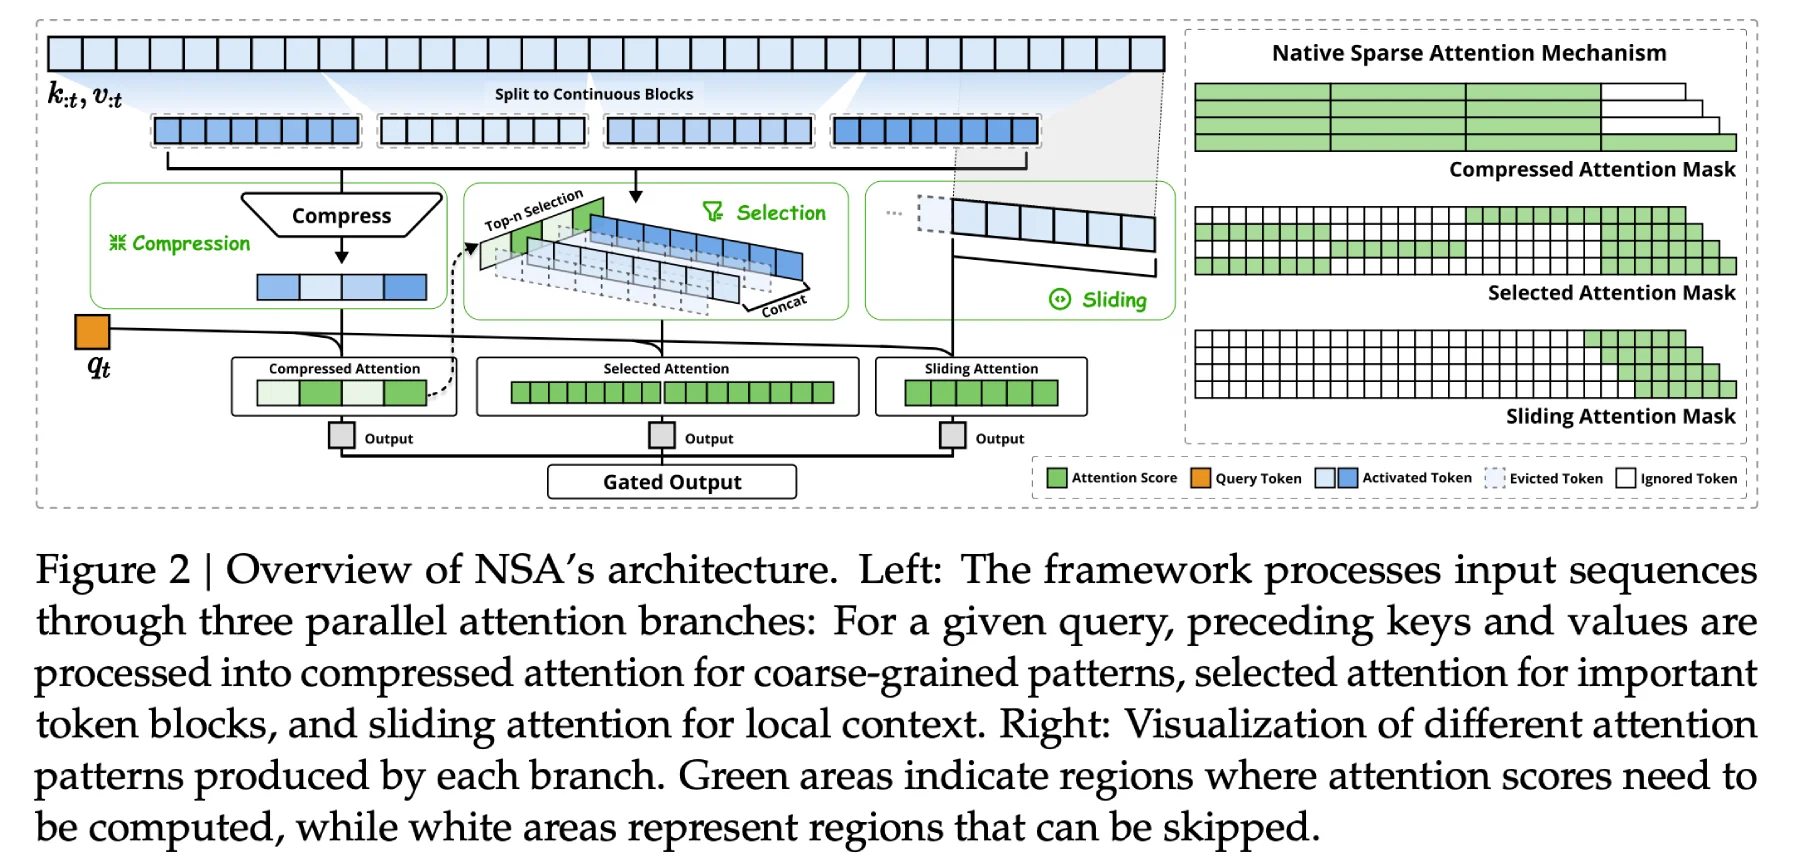
NSA의 기술 세부 사항:
동적 계층적 희소 전략: 핵심 정보와 무시 가능한 정보를 유연하게 결정하여 정보 처리를 최적화하고, 모델이 긴 컨텍스트를 처리할 때 핵심 전역 의미를 포착하는 동시에 계산 부담을 줄이도록 보장합니다.
거친 수준의 토큰 압축: 유사하거나 중요하지 않은 토큰을 통합하여 데이터 처리량을 줄이고 계산을 가속화하는 동시에 텍스트의 거친 의미에 대한 이해를 유지합니다.
세분화된 토큰 선택: 압축된 데이터에서 중요한 토큰을 추가로 필터링하여 모델이 세부 정보에 집중하도록 하고, 로컬 정확성을 유지하며 중요한 정보의 손실을 방지합니다.
슬라이딩 윈도우: 슬라이딩 윈도우 메커니즘을 활용하여 로컬 컨텍스트 정보를 캡처하고 인접 관계를 무시하는 것을 방지합니다.
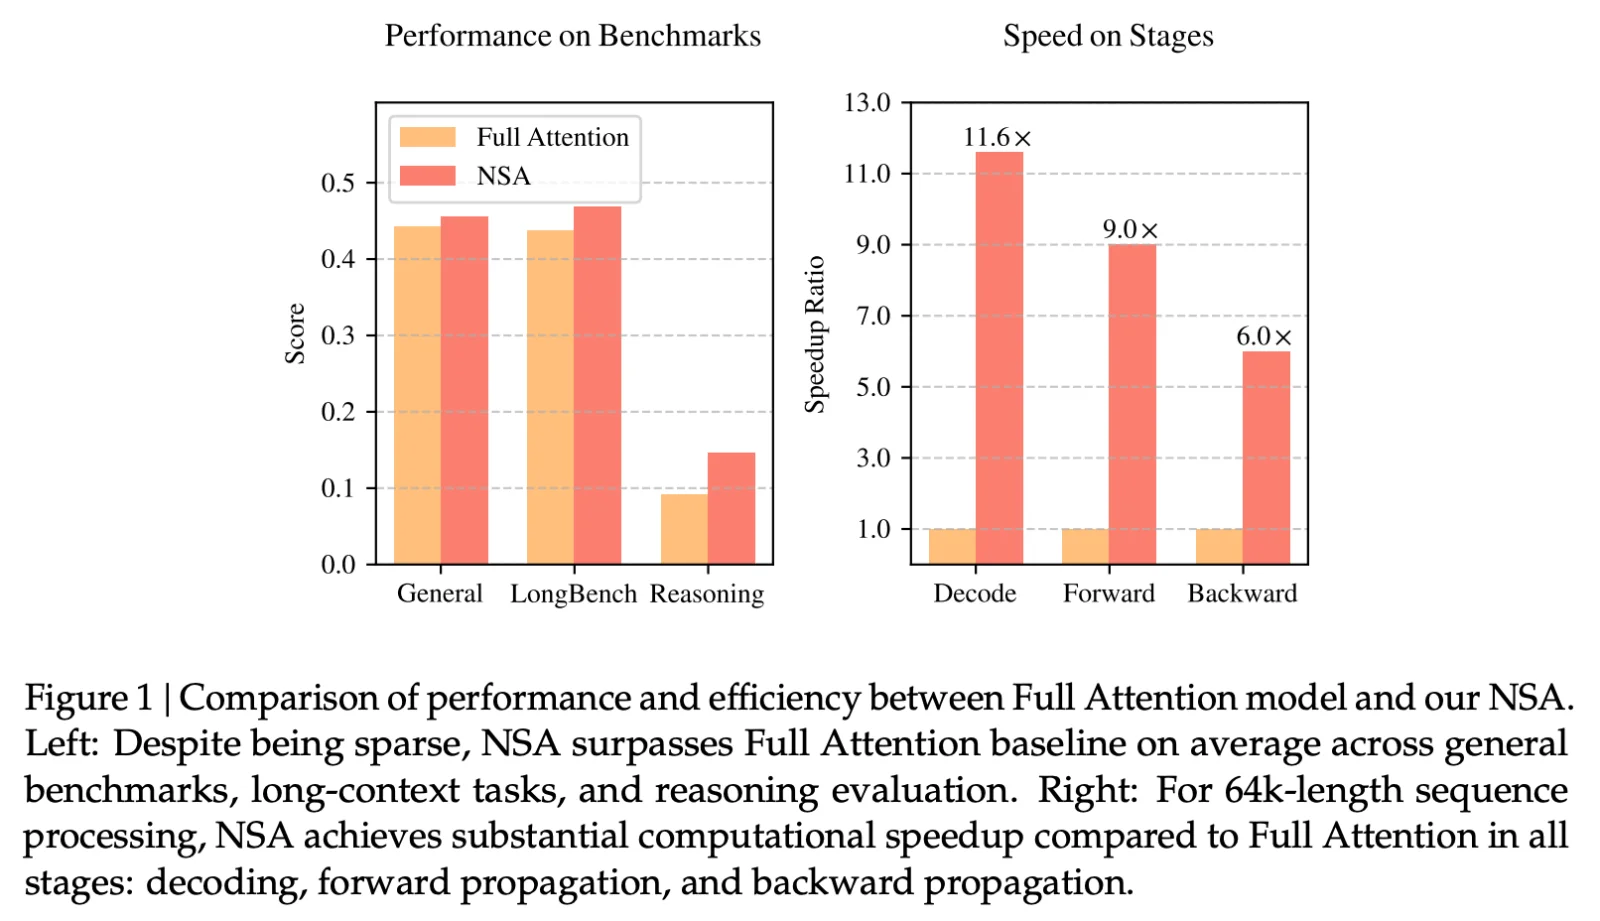
NSA의 성능 결과:
속도 향상: 64k 길이 시퀀스를 처리할 때, NSA는 디코딩, 순전파 및 역전파 단계에서 최대 11.6배의显著한 속도 향상을 실현합니다.
우수한 성능: 여러 벤치마크 테스트에서 NSA는 풀 어텐션 모델과 동등하거나 더 우수한 성능을 보이며, 특히 긴 컨텍스트 작업 및 명령어 추론 측면에서 그렇습니다.
NSA의 응용 분야:
지능형 어시스턴트: 더 복잡한 다중 턴 대화 및 개인화된 서비스를 실현합니다.
과학 계산: 물리 시뮬레이션, 엔지니어링 모델링의 긴 시퀀스 데이터 처리 등.
코드 생성 및 디버깅: 긴 코드 라이브러리를 이해하고 고품질 솔루션을 생성합니다.
NSA의 논문:https://arxiv.org/abs/2502.11089
DeepSeek는 범용 인공지능에 집중하는 중국 기업으로, AGI 핵심 기술을 발굴하고 제품화를 실현하는 데 전념하고 있습니다. DeepSeek는 128k 컨텍스트 긴 텍스트 이해를 지원하는 DeepSeek-V2와 MT-Bench 중국어 평가에서 우수한 성능을 보인 DeepSeek-R1-Lite-Preview 등 여러 고성능 오픈 소스 ai 대형 모델을 출시했습니다.









