
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
node-DeepResearch: Jina AI의 DeepSearch 기능으로 복잡한 질문 깊이 파고들기
小编 ·

node-DeepResearch: Jina AI의 DeepSearch 기능으로 복잡한 질문 깊이 파고들기
Jina AI 가 최근 DeepSearch도구인 node-DeepResearch를 출시했습니다. node-DeepResearch는 오픈 소스 자동화 연구 도구로, 검색과 웹 페이지 읽기, 추론을 통해 질문에 대한 답을 찾을 때까지 동작합니다. 자동화된 정보 검색과 지능형 질의응답 작업에 적합하며, 검색 엔진과 대규모 언어 모델(LLM)을 결합하여 연구 효율을 높여줍니다.
1. 주요 기능:
자동 검색 및 추론: 검색 엔진을 사용하여 관련 웹 페이지를 찾고, 대규모 모델(예: Gemini)로 추론하여 최종 답안을 생성합니다.
지능형 웹 페이지 읽기: Jina Reader와 결합하여 웹 페이지에서 핵심 내용을 추출함으로써 정보 획득의 정확도를 높입니다.
설정 가능한 API: 사용자가 자신의 Gemini API와 Jina Reader API를 구성하여 쿼리 효과를 최적화할 수 있습니다.
2. 활용 시나리오:
문헌 리뷰: 연구자가 관련 분야의 문헌 자료를 빠르게 검색하고 정리하여 문헌 리뷰 보고서를 생성하도록 도와줍니다.
시장 조사: 시장 데이터를 빠르게 수집하고 분석하여 경쟁사의 동향과 업계 트렌드 등을 파악합니다.
뉴스 보도: 뉴스 이벤트의 배경 정보와 관련 보도를 빠르게 수집하고 정리하여 기자가 뉴스 기사를 신속하게 작성하도록 도와줍니다.
학습 보조: 학생이 복잡한 학문적 문제를 해결하고 학습 자료와 참고 답안을 제공하도록 도와줍니다.
정책 연구: 정책 입안자가 관련 정책의 배경 정보와 시행 효과 등을 수집하고 분석하도록 도와줍니다.
3. 주요 목표:
자동화된 정보 검색: 검색 엔진을 통해 관련 정보를 찾습니다.
다단계 추론: 복잡한 다단계 문제를 처리하여 점진적으로 분해하고 해결합니다.
실시간 진행 상황 피드백: 실시간 진행 상황 업데이트를 제공하여 사용자가 쿼리 진행 상황을 추적할 수 있도록 합니다.
유연성: 간단한 사실적 질문부터 복잡한 개방형 질문까지 다양한 유형의 쿼리를 지원합니다.
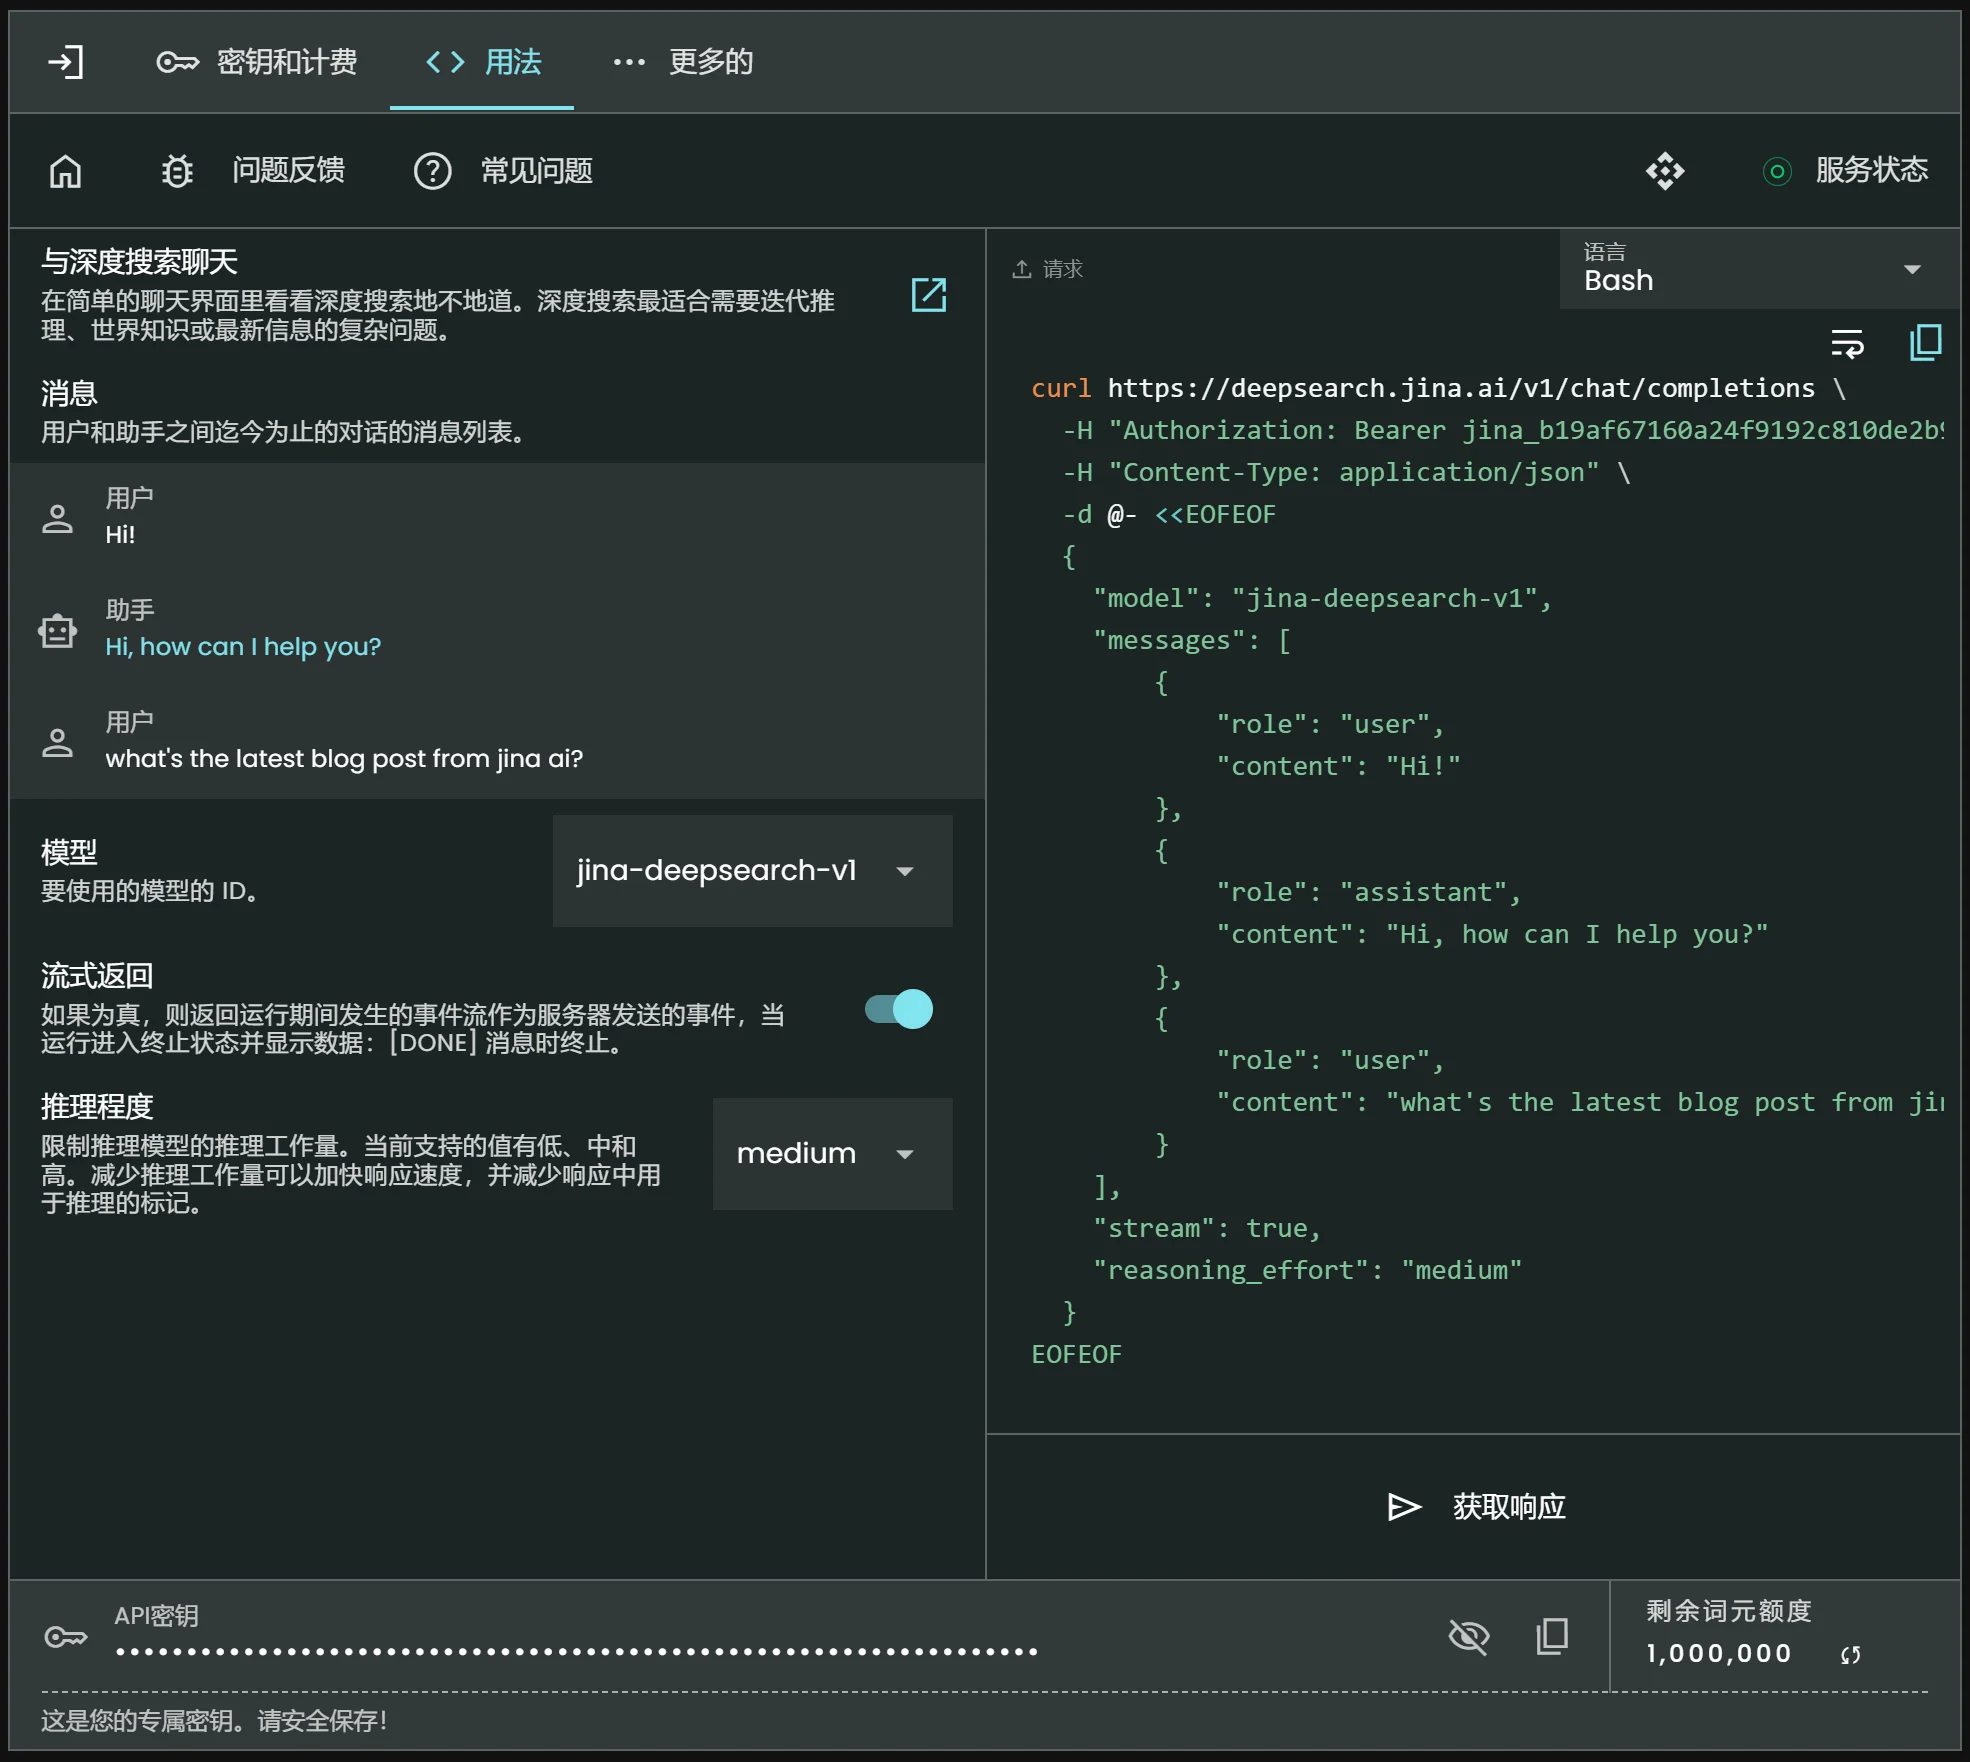
4. 핵심 기능
지속적인 검색 및 읽기:
Brave 또는 DuckDuckGo와 같은 검색 엔진을 기반으로 관련 정보를 찾습니다.
질문에 대한 답을 찾거나 사전 설정된 token 예산 한도에 도달할 때까지 웹 페이지 내용을 읽습니다.
다단계 추론:
복잡한 문제를 여러 단계로 분해하고 각 단계를 하나씩 해결합니다.
장시간 소요되는 작업 처리를 지원하여 정확한 결과를 얻을 수 있도록 합니다.
실시간 진행 상황 피드백:
Web Server API를 통해 실시간 진행 상황 업데이트를 제공하며, 사용자는 HTTP 요청을 통해 쿼리 상태를 확인할 수 있습니다.
유연한 쿼리 방식:
간단한 질문부터 복잡한 개방형 질문까지 다양한 유형의 쿼리 요구 사항을 지원합니다.
5. 기술 원리
언어 모델:
핵심 언어 모델로 Gemini를 사용하며, 답변 생성 및 추론 로직을 담당합니다.
Gemini는 강력한 범용 언어 모델로, 다양한 자연어 작업을 처리할 수 있습니다.
웹 페이지 콘텐츠 처리:
Jina Reader를 활용하여 웹 페이지 콘텐츠를 언어 모델이 처리하기 적합한 순수 텍스트 형식으로 변환합니다.
Jina Reader는 HTML 웹 페이지 콘텐츠 처리에专한 오픈 소스 도구입니다.
검색 및 정보 추출:
검색 엔진과 결합하여 관련 정보를 얻습니다.
추가 분석 및 추론을 위해 유용한 웹 페이지 콘텐츠를 자동으로 추출합니다.
다단계 추론 흐름:
초기화: 초기 컨텍스트와 변수를 설정합니다.
예산 확인: 각 단계에서 token 예산 초과 여부를 확인합니다.
프롬프트 생성: 현재 질문을 기반으로 언어 모델의 입력 프롬프트를 생성합니다.
모델 생성: Gemini를 호출하여 답변 또는 다음 단계를 생성합니다.
동작 처리: 생성된 동작에 따라 해당 작업을 실행합니다.
결과 평가: 생성된 답변이 질문 요구 사항을 충족하는지 평가하며, 충족하지 않을 경우 추론을 계속 진행합니다.
반복 및 종료: 예산 내에서 답을 찾으면 쿼리를 종료하고, 그렇지 않으면 "Beast Mode"로 진입하여 최종 답안을 생성합니다.
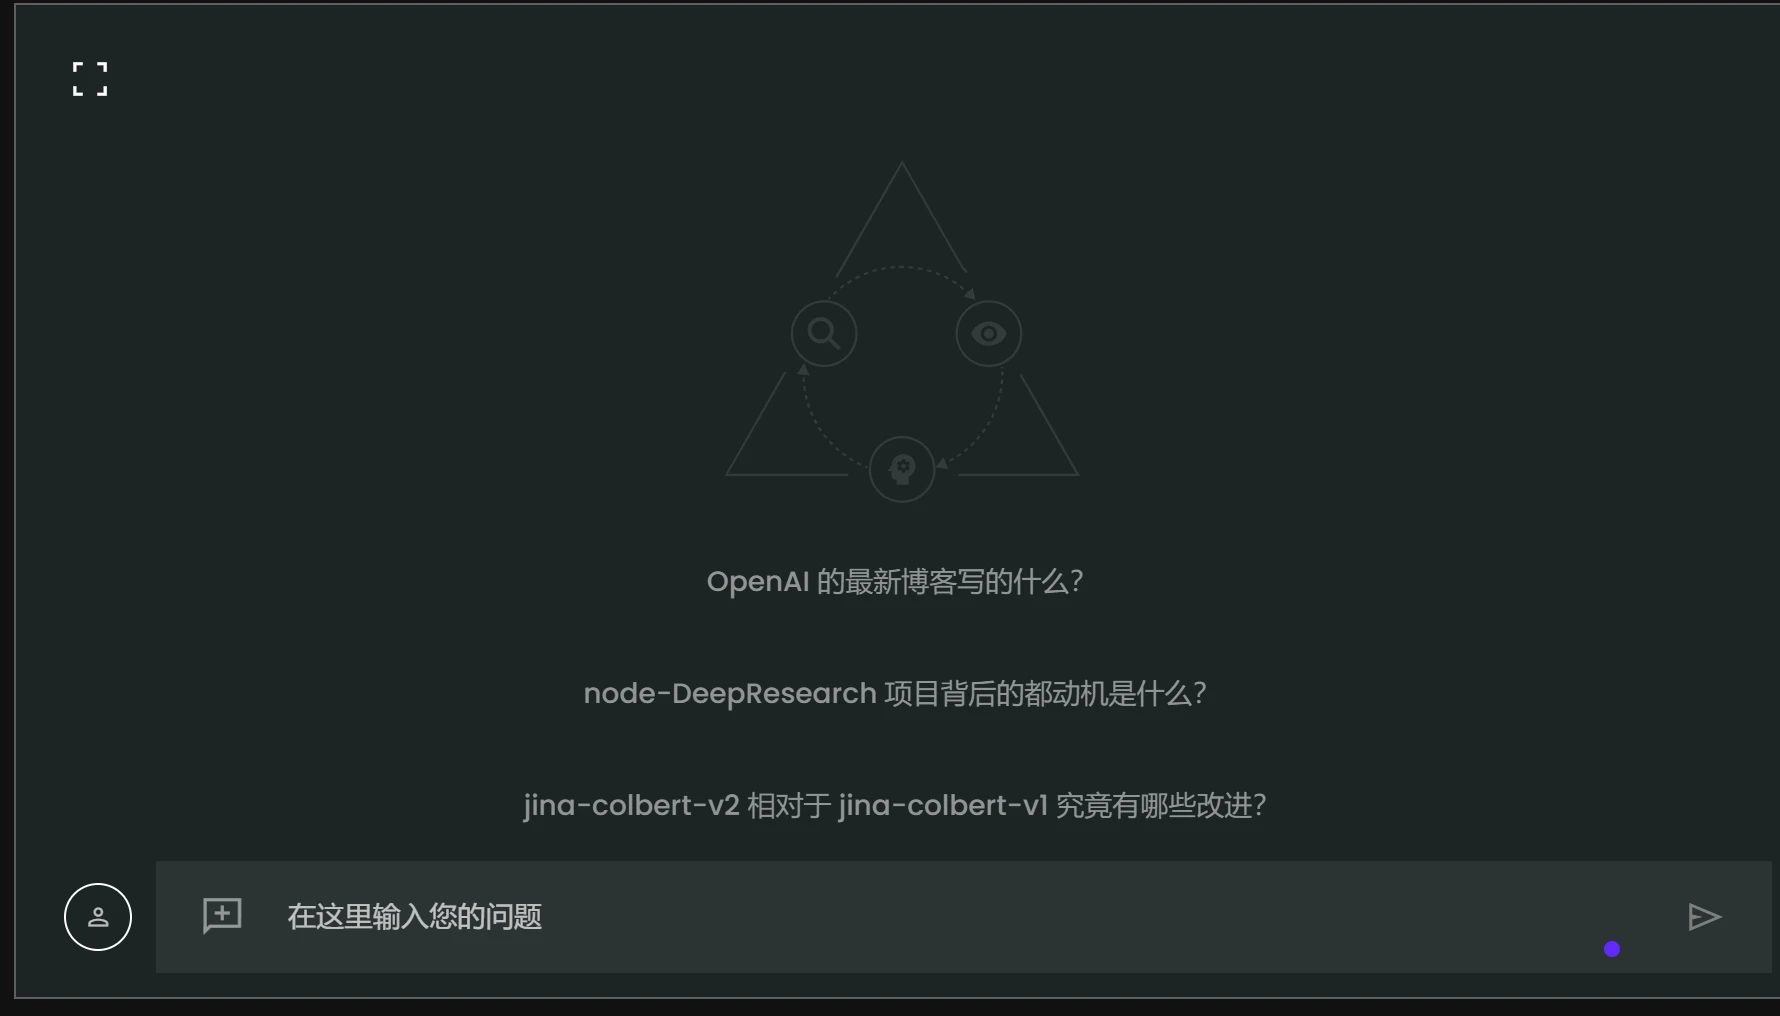
6. node-DeepResearch 배포 방법
1. 의존성 설치
# 설정 필요한 환경 변수
export GEMINI_API_KEY=export JINA_API_KEY=jina_ # 从 https://jina.ai/reader 获取免费的 Jina API 密钥

# 클론 仓库并安装依赖
git clone https://github.com/jina-ai/node-DeepResearch.git
cd node-DeepResearch
npm install
2. 명령줄을 통해 실행
# 제출 쿼리 요청
npm run dev # 예시
npm run dev "what is the capital of France?"
npm run dev "who will be the biggest competitor of Jina AI"
3. API 호출
# 시작 Web Server
npm run serve

# 접속 주소
http://localhost:3000

# 제출 쿼리 요청 (예시)
curl -X POST http://localhost:3000/api/v1/query \
-H "Content-Type: application/json" \
-d '{"query": "What is the capital of France?"}'
GitHub仓库:https://github.com/jina-ai/node-DeepResearch









