
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
MILS: Meta가 발표한 학습 없이 LLM에 멀티모달 능력을 부여하는 방법
小编 ·

MILS: Meta가 발표한 학습 없이 LLM에 멀티모달 능력을 부여하는 방법
MILS(Meta Interpretive Learning System)는 Meta에서 발표한, 별도의 훈련 없이도 LLM이 멀티모달 능력을 갖추도록 하는 오픈소스 AI 모델입니다. 기존의 훈련 방식과는 달리, MILS는 추가적인 특정 작업 훈련 없이도 대규모 언어 모델(LLM)이 시각 및 청각 작업을 처리할 수 있도록 하는 것을 목표로 하며, 이미지와 동영상을 이해하고 소리를 들을 수 있는 제로샷 학습 능력을 갖추고 있습니다.
MILS는 딥러닝과 해석적 학습의 장점을 결합하여 다양한 작업에서 뛰어난 성능을 보이며, 특히 이해와 추론이 필요한 복잡한 시나리오에서 두드러집니다.
MILS는 주로 두 가지 모듈로 구성됩니다. 하나는 후보 솔루션을 생성하는 생성기이고, 다른 하나는 생성기가 만든 후보 솔루션의 품질을 평가하는 평가기입니다. 이 두 모듈은 추가 훈련 없이 반복적인 과정을 통해 멀티모달 작업을 해결합니다.
MILS의 특징으로는 다양한 언어와 멀티모달 입력을 지원하여 텍스트, 이미지, 오디오 데이터를 처리할 수 있다는 점이 있으며, 이미지/동영상/오디오 설명, 이미지 생성 강화, 스타일 전이 등 다양한 멀티모달 작업에 활용할 수 있습니다.
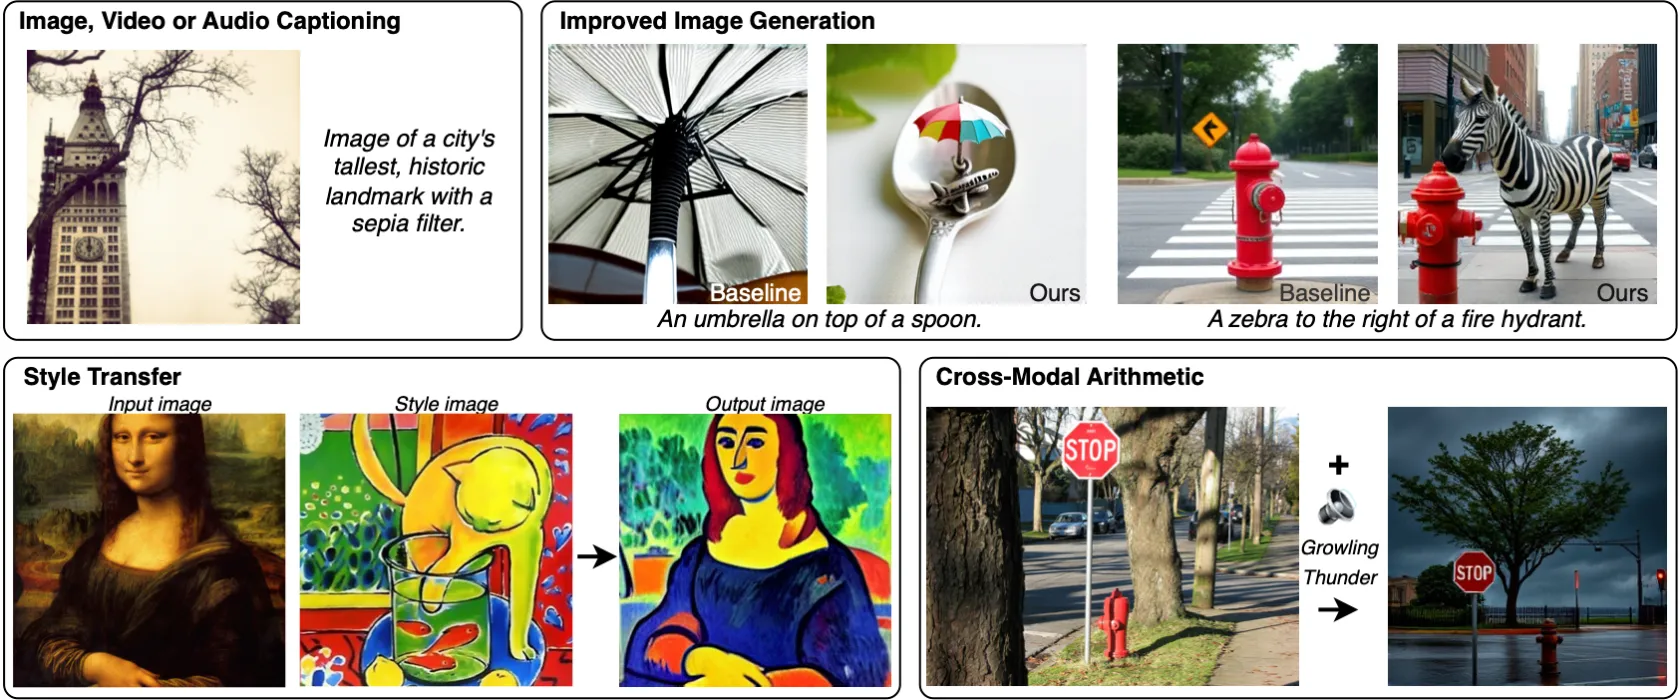
MILS의 핵심 특징 및 작동 원리
제로샷 생성: MILS의 핵심은 제로샷 학습 능력에 있으며, 이는 모델이 특정 모달리티 작업을 위해 직접적으로 훈련받지 않은 상태에서도 멀티모달 문제를 해결할 수 있음을 의미합니다. MILS는 반복적인 피드백 메커니즘을 통해 생성된 출력을 점진적으로 개선하여 고품질의 멀티모달 설명 또는 생성을 달성합니다.
반복적인 피드백 루프: 생성 과정에서 MILS는 먼저 언어 모델이 텍스트 프롬프트 기반으로 초기 멀티모달 출력(예: 이미지 설명)을 생성하도록 합니다. 그런 다음 이 출력이 입력으로 사용되어 모델이 다시 생성하거나 최적화를 시도하며, 끊임없는 자기 피드백과 수정을 통해 최종적으로 만족스러운 솔루션에 도달합니다.
사전 훈련된 모델의 잠재력 활용: MILS는 대규모 언어 모델의 사전 훈련된 지식에 의존하며, 이러한 모델은 이미 방대한 양의 텍스트 데이터를 학습하여 복잡한 의미와 문맥을 이해할 수 있습니다. 이러한 방식을 통해 MILS는 모델의 내재된 능력을 활용하여 이미지, 소리 등 비텍스트 데이터를 이해하고 생성하는 영역으로 확장할 수 있습니다.
논문: https://arxiv.org/pdf/2501.18096
Github: https://github.com/facebookresearch/MILS









