
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
Mistral AI, Mistral Small 3 출시 — 24B 파라미터에 불과하지만 70B급 모델에 버금가는 성능
小编 ·

Mistral AI, Mistral Small 3 출시 — 24B 파라미터에 불과하지만 70B급 모델에 버금가는 성능
Mistral ai는 2025년 1월 30일에 Mistral Small 3를 출시했습니다. 이는 지연 시간을 최적화한 240억 개 파라미터 모델로, 효율적인 성능을 제공하는 것을 목표로 합니다. 이 모델은 Apache 2.0 라이선스 하에 출시되어 사용자가 자유롭게 사용하고 수정할 수 있습니다.
Mistral Small 3 주요 특징:
고성능과 규모: 240억 개의 파라미터에 불과하지만, Mistral Small 3의 성능은 더 큰 규모의 모델(예: Llama 3.3의 700억 개 파라미터 모델)과 견줄 만합니다. 이를 통해 동일한 하드웨어에서 더 빠른 추론 속도를 구현할 수 있습니다.
지연 시간 최적화: Mistral Small 3는 낮은 지연 시간의 워크로드에 최적화되어 있어 빠른 응답이 필요한 애플리케이션 시나리오에 매우 적합합니다.
도메인 전문가 미세 조정: 법률, 의료, 기술 지원 등 분야의 특정 작업을 위한 학습에 적합하며, 전문 지식의 정확도를 향상시킵니다.
로컬 추론: RTX 4090 또는 MacBook 32GB RAM에서 로컬로 실행할 수 있도록 지원하여, 민감하거나 기밀 데이터를 처리하는 개인 및 기업에 적합합니다.
Mistral Small 3는 대부분의 생성형 AI 작업, 특히 강력한 언어 능력과 지시 수행 능력이 필요한 작업을 충족하도록 특별히 설계되었습니다. 이 모델은 MMLU 벤치마크 테스트에서 81% 이상의 정확도를 달성했으며, 동일한 하드웨어에서 초당 150개의 토큰 속도로 실행되어 효율성 측면에서의 장점을 보여줍니다.
또한 Mistral Small 3는 특히 민감하거나 기밀 정보를 다루는 시나리오에서 로컬 배포에 적합하도록 설계되었습니다. 사용자는 단일 RTX 4090 또는 32GB RAM의 Macbook에서 이 모델을 실행할 수 있어, 가용성과 유연성이 더욱 강화되었습니다.
Mistral Small 3는 Hugging Face, Ollama, Kaggle을 비롯한 여러 플랫폼과 협력하여 개발자가 이 모델에 더 편리하게 접근하고 사용할 수 있도록 합니다.
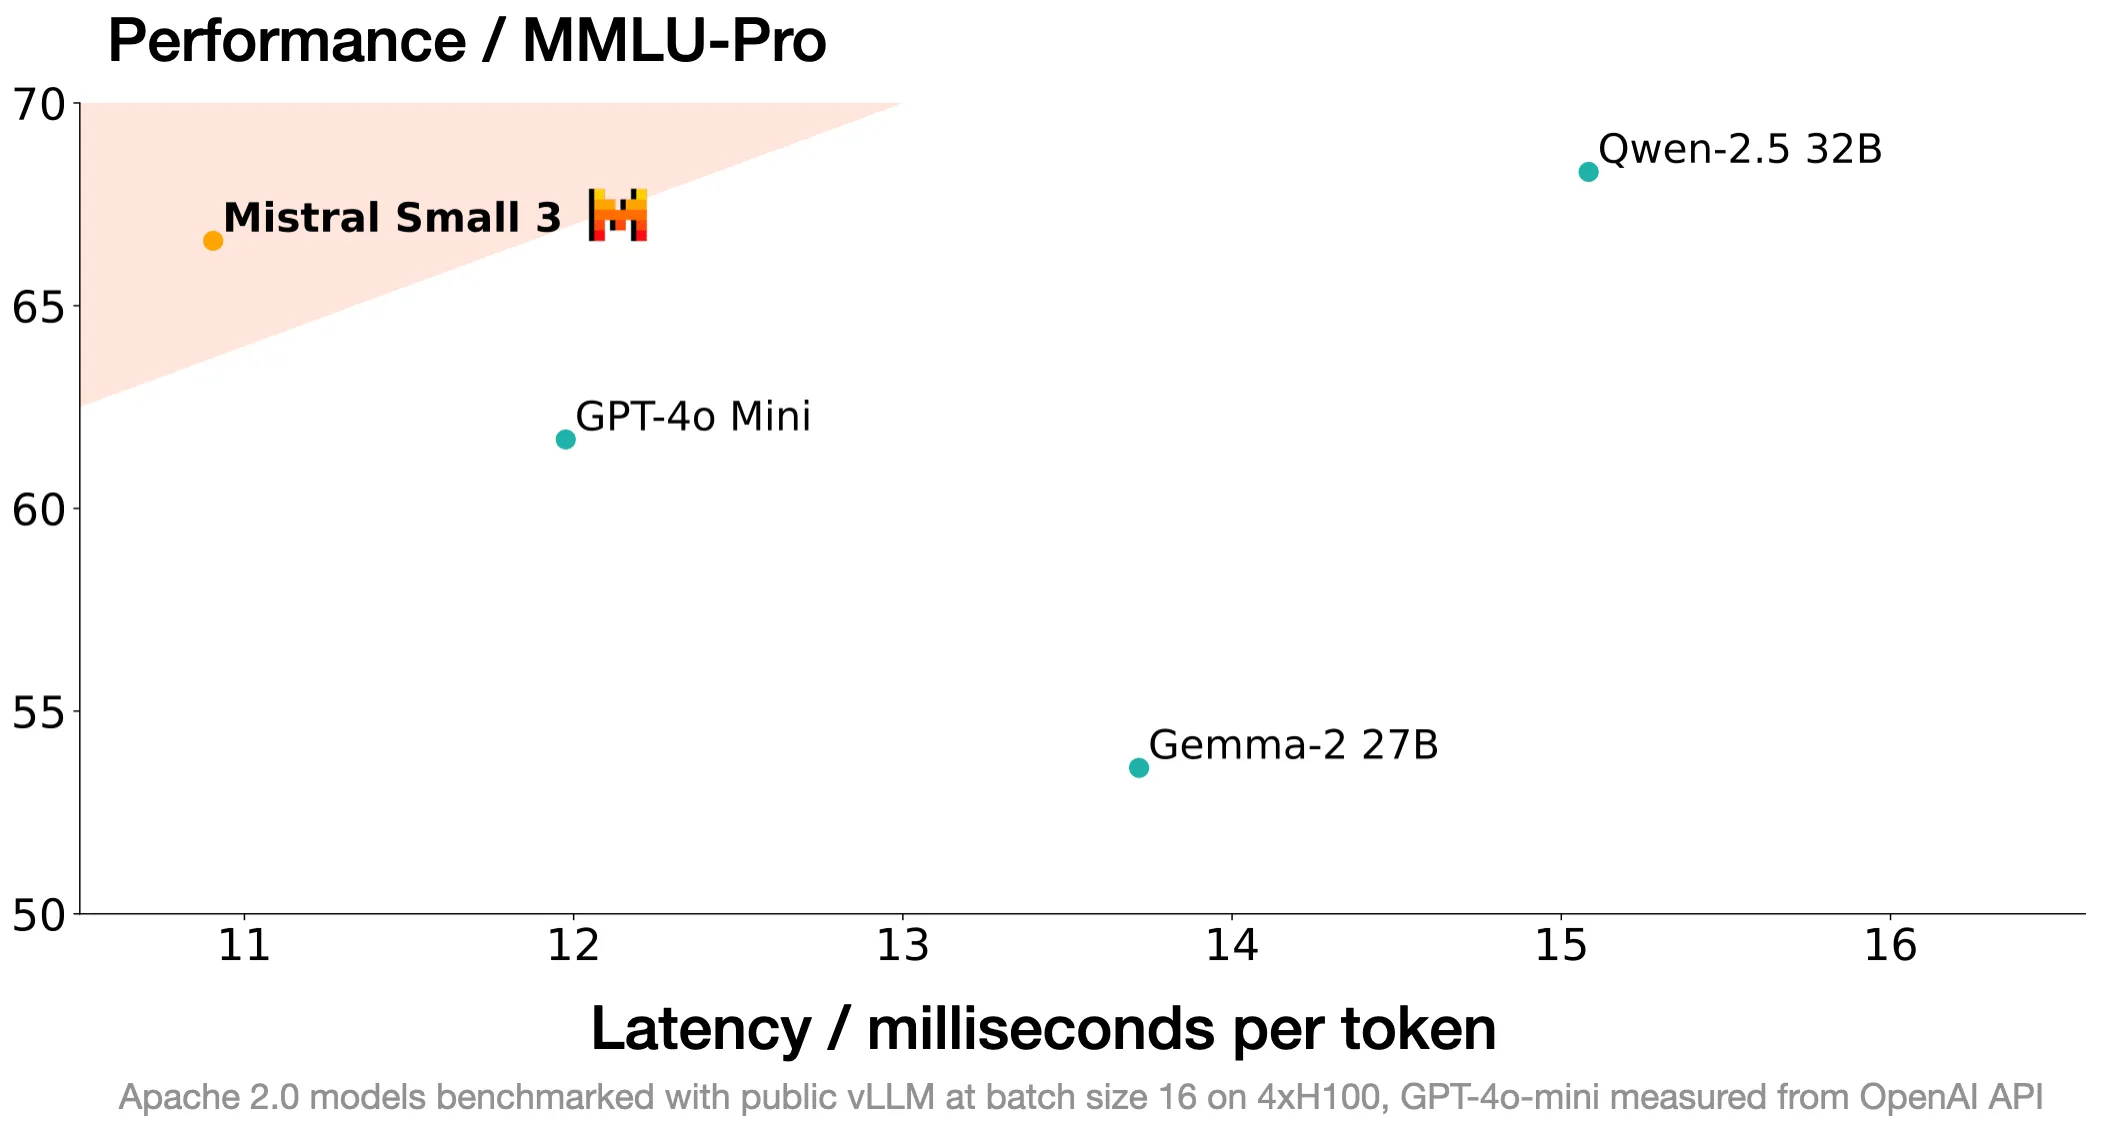
Mistral Small 3 활용 분야
Mistral Small 3는 자연어 처리, 대화 시스템 및 효율적인 추론이 필요한 기타 작업을 비롯한 다양한 애플리케이션에 적합합니다. 설계 목표는 현대 AI 애플리케이션의 요구 사항을 충족하는 유연하고 강력한 도구를 개발자에게 제공하는 것입니다.
대화 어시스턴트: 빠르고 정확한 응답이 필요한 가상 어시스턴트에 적합합니다.
함수 호출: 자동화 또는 에이전트 워크플로우에서 함수를 빠르게 실행할 수 있습니다.
도메인 전문가: 특정 도메인에서 고정밀 전문가 모델을 생성하기 위해 미세 조정할 수 있습니다.
로컬 추론: 민감하거나 기밀 정보를 처리하는 로컬 추론에 적합합니다.
금융 서비스: 사기 탐지에 사용됩니다.
의료 산업: 환자 분류 및 고객 지원에 사용됩니다.
로봇/자동차/제조업: 기기에서 명령 제어를 실행합니다.
공식 소개: https://mistral.ai/news/mistral-small-3/









