
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
대규모 모델의 증류(distillation)란 무엇인가, DeepSeek가 맞은 '모델 증류' 의혹은 무엇인가
小编 ·

대규모 모델의 증류(distillation)란 무엇인가, DeepSeek가 맞은 '모델 증류' 의혹은 무엇인가
DeepSeek는新兴의인공지능 회사이며, 최근 OpenAI의 기술을 사용하여 모델 증류를 했다는 비난을 받으면서 큰 주목을 받고 있습니다. OpenAI는 DeepSeek가 증류 기술을 통해 자사 모델의 지식을 추출하여 경쟁 제품을 개발했을 수 있다고 주장하고 있습니다.
대규모 모델의 증류(Distillation)란 무엇인가요?
대규모 모델의 증류는 하나의 크고 복잡한 모델(교사 모델이라 함)의 지식을 더 작고 효율적인 모델(학생 모델이라 함)로 전달하는 것을 목표로 하는 모델 압축 기술입니다. 이 과정은 학생 모델을 훈련하여 교사 모델의 출력을 모방하도록 함으로써, 성능을 유지하면서 계산 자원 소비를 줄이는 방식입니다.
이 개념은 2015년 Hinton 등에 의해 제안되었으며, 원래 모델의 성능을 최대한 유지하면서 모델 압축, 추론 가속화 및 배포 비용 절감을 위해 자주 사용됩니다. 증류 기술은 딥러닝에서 광범위하게 활용되며, 특히 자연어 처리와 컴퓨터 비전等领域에서 두드러집니다.
아래에서 유튜브 “Jeff 테크 시점(Jeff科技视角)” Jeff Li의마인드맵을 통해 한번 느껴보세요. Jeff Li 선생님은 《제379회: 대규모 모델의 증류(Distillation) 및 DeepSeek가 직면한 비난》영상에서 매우 상세하게 설명해주셨습니다.
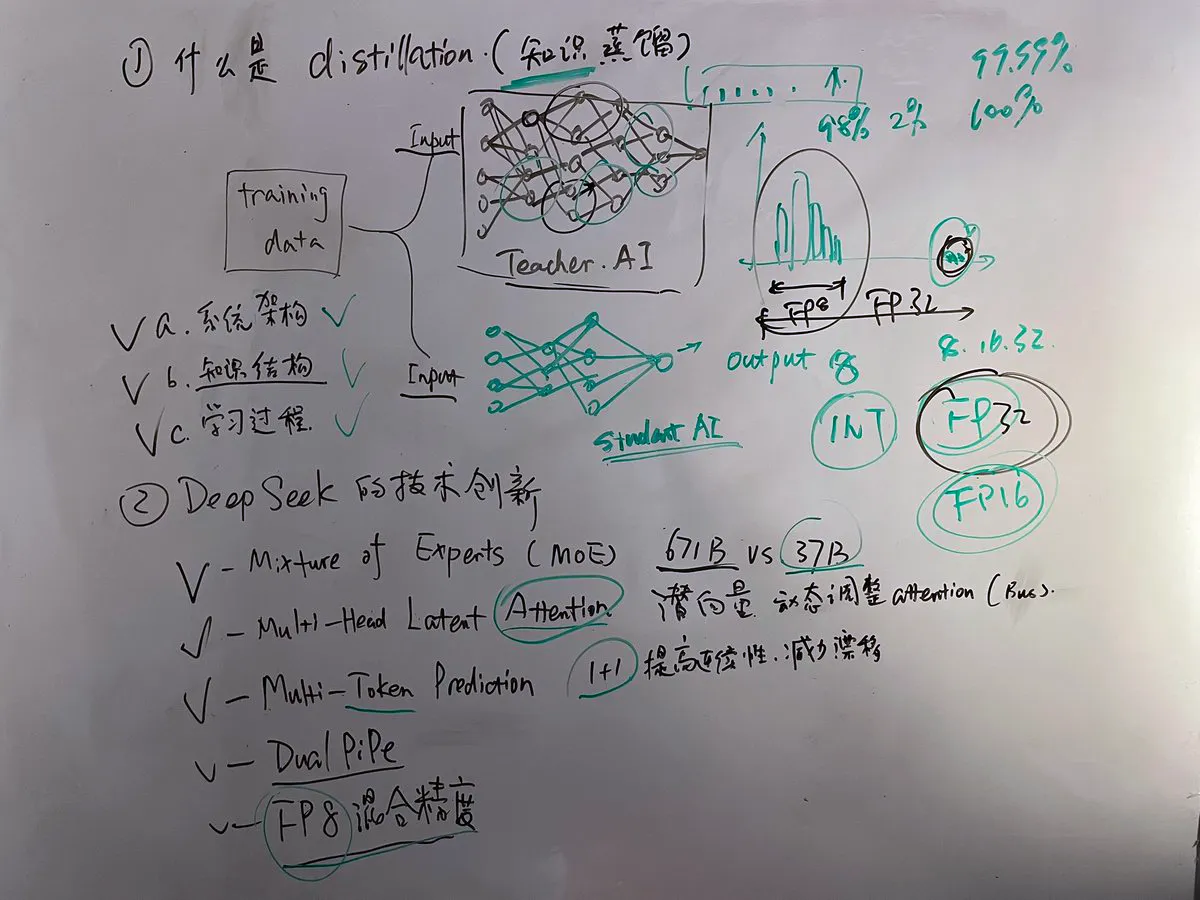
대규모 모델의 증류 구현 방식:
소프트 레이블(Soft Labels): 훈련 시 하드 레이블 대신 교사 모델이 생성한 확률 분포를 사용합니다.
히든 액티베이션(Hidden Activations): 교사 모델의 일부 중간층 출력을 보조 신호로 학생 모델에 전달합니다.
어텐션 가중치(Attention Weights): 시퀀스 모델과 관련된 경우, 어텐션 메커니즘의 관련 정보를 이전할 수도 있습니다.
DeepSeek가 직면한 “모델 증류” 비난
배경:
DeepSeek는 스타트업 기업으로, 자체 대규모 언어 모델 제품을 제공하고 있습니다.
DeepSeek의 저비용 모델 개발, 오픈소스 및 무료 전략은 OpenAI 및 Anthropic 등 회사의 시장 지위를 위협할 수 있으며, 이로 인해 경쟁사들은 DeepSeek가 부당하게 그들의 기술과 데이터를 사용했다고 비판하고 있습니다.
핵심 포인트:
OpenAI의 입장
DeepSeek가 허가 없이 데이터를 수집하여 자사 모델 훈련에 사용했다고指责했습니다.
스스로의存在的问题: OpenAI 역시 인터넷에서 데이터를 불법으로 수집하여 자사 모델을 훈련했다는 지적을 받아왔으며, 특히 저작권이 보호된 기사 작품이 포함되어 있습니다. 또한 OpenAI는 유사한 행위로 인해 《뉴욕 타임즈》 등 출판사로부터 법적 소송을 당한 바 있습니다.
Anthropic의 관점
심각성에 대한 반박: Anthropic은 DeepSeek가 자사 제품에 대한 진정한 위협이 되는 수준에 도달하지 못했다고 주장하며, 그 기술 수준이 단지 몇 개월 전 버전에 불과하다고 평가했습니다.
마이크로소프트의 태도
마이크로소프트는 자사 Azure AI 및 GitHub 플랫폼에 DeepSeek 모델을 출시하여 일정 형태의 지지의사를 보였으며, 이는 이해 상충에 대한 논의를 촉발시켰습니다.
모델 증류에 대한 구체적인 논쟁
합법성 및 규범성: 모델 증류는 흔한 기술 실천이지만, 실제 운영에는 엄격한 규칙 제약이 따릅니다. 특히 상업적 용도 및 기술 공유 협약에 관한 규정은 각 회사마다 다른 해석과 집행 수위를 가지고 있습니다.
"허가받지 않은 방식"으로 데이터를取得하는 것을 어떻게 규정할 것인가?
특정 API 출력 데이터를 새로운 경쟁 모델 훈련에 사용하는 것이 허용되는가?
증거 및 뒷받침 자료: 현재 양측 모두各自의 주장을 뒷받침할 자세한 증거를 완전히 공개하지 않은 상황으로, 사건의 복잡성과 불확실성이 더해지고 있습니다.
업계 반응 및 사회적 여론
커뮤니티 내외에서 이 문제에 대한 견해는 엇갈려, 일부는 이것이 시장 경쟁의 일부 표현이라고 여기지만, 많은 목소리가 사건 이면의 윤리적 및 법적 규정이 충분히 존중받았는지 관심을 두고 있습니다.
DeepSeek가 직면한 "모델 증류" 비난은 현재 AI 업계에 존재하는 치열한 경쟁 상황과 데이터 사용권, 기술 혁신 경계 등의 법적 모호한 영역에서 비롯된 도전을 반영합니다.









