
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
DeepSeek Janus Pro를 로컬에 배포하는 방법
小编 ·

DeepSeek Janus Pro를 로컬에 배포하는 방법
DeepSeek에서 발표한 Janus-Pro-7B는 오픈소스 멀티모달 대형 모델로, 이미지 인식과 생성을 지원하며 성능이 Openai의 DALL·E 3을 능가합니다. 다음은 DeepSeek Janus Pro-7B를 로컬 환경에 배포하는 자세한 단계, 팁 및 주의사항입니다:
1. 환경 준비
하드웨어 요구 사항
GPU: 비디오 메모리 ≥24GB (NVIDIA RTX A6000 이상의 고성능 그래픽 카드 권장); 비디오 메모리가 부족한 경우 저정밀도 모드(model.half())를 시도하거나 생성 파라미터를 줄일 수 있습니다.
저장 공간: 사용 가능한 공간 ≥30GB (모델 파일 약 20GB 이상).
운영 체제: Ubuntu 20.04+ 또는 Windows (CUDA适配 필요) 권장.
Python: 3.8 이상, Conda를 사용하여 가상 환경을 관리하는 것을 권장.
소프트웨어 의존성
CUDA: 11.7+ (PyTorch 버전과 일치해야 함).
PyTorch: 지정 버전 torch==2.0.1+cu117 (공식 인덱스를 통해 설치해야 함).
기타 도구: Git, HuggingFace Hub 다운로드 도구(huggingface-cli).
2. 배포 단계
1단계: 코드 저장소 복제
git clone https://github.com/deepseek-ai/Janus.git
cd Janus
2단계: 가상 환경 생성
conda create -n janus python=3.8 -y
conda activate janus
3단계: 의존성 설치
pip install torch==2.0.1+cu117 --index-url https://download.pytorch.org/whl/cu117
pip install -r requirements.txt
pip install -e .[gradio]  # Gradio 확장에 대한 설명은 아래 캡션을 참조하세요
4단계: 모델 다운로드
방법 1: huggingface-cli를 통해 전체 모델 다운로드 (중국 내 사용자의 경우 미러를 통한 가속 다운로드 권장):
HF_ENDPOINT=https://hf-mirror.com huggingface-cli download deepseek-ai/Janus-Pro-7B \
  --local-dir ./models/Janus-Pro-7B \
  --resume-download --cache-dir ./cache
방법 2: HuggingFace 저장소에서 모델 파일을 수동으로 다운로드하여 ./models/Janus-Pro-7B에 압축 해제합니다.
5단계: 애플리케이션 시작
텍스트 인터랙션 인터페이스:
python demo/app_text.py --model-path ./models/Janus-Pro-7B
멀티모달 인터페이스(이미지 생성과 질의응답 지원):
python demo/app_multimodal.py --model-path ./models/Janus-Pro-7B --port 7860
http://localhost:7860 또는 http://127.0.0.1:7860에 접속하여 인터랙션 인터페이스를 사용하세요.
3. 기능 사용 예제
텍스트-이미지 변환 (Text-to-Image)
from janus.utils import generate_image
generate_image(
    model_path="./models/Janus-Pro-7B",
    prompt="석양 아래 설산, 산 기슭에 푸른 호수가 있는 장면",
    output_dir="./outputs",
    num_images=4  # 4장 이미지 생성)
멀티모달 질의응답 (Visual QA)
from janus.models import MultiModalityCausalLM, VLChatProcessor
processor = VLChatProcessor.from_pretrained("./models/Janus-Pro-7B")
model = MultiModalityCausalLM.from_pretrained("./models/Janus-Pro-7B").to("cuda")
# 입력 대화 및 이미지 경로
conversation = [
    {"role": "", "content": "이 이미지의 내용을 묘사해주세요", "images": ["sample.jpg"]},
    {"role": "", "content": ""}
]
inputs = processor(conversations=conversation)
outputs = model.generate(**inputs)
print(processor.decode(outputs[0]))
4. 자주 발생하는 문제와 최적화
비디오 메모리 부족
생성 파라미터 축소: max_new_tokens=256.
저정밀도 모드 활성화: model = model.half().
다운로드 속도가 느린 경우
중국 내 미러 소스 사용: HF_ENDPOINT=https://hf-mirror.com.
다중 스레드 다운로드 활성화: --workers 8.
의존성 충돌
지정 버전을 엄격히 설치:
pip install transformers==4.33.2
이미지 생성 품질 최적화
CFG 가중치 조정 (5~7 범위).
parallel_size=16으로 병렬 샘플링 수를 늘립니다. parallel_size=16.
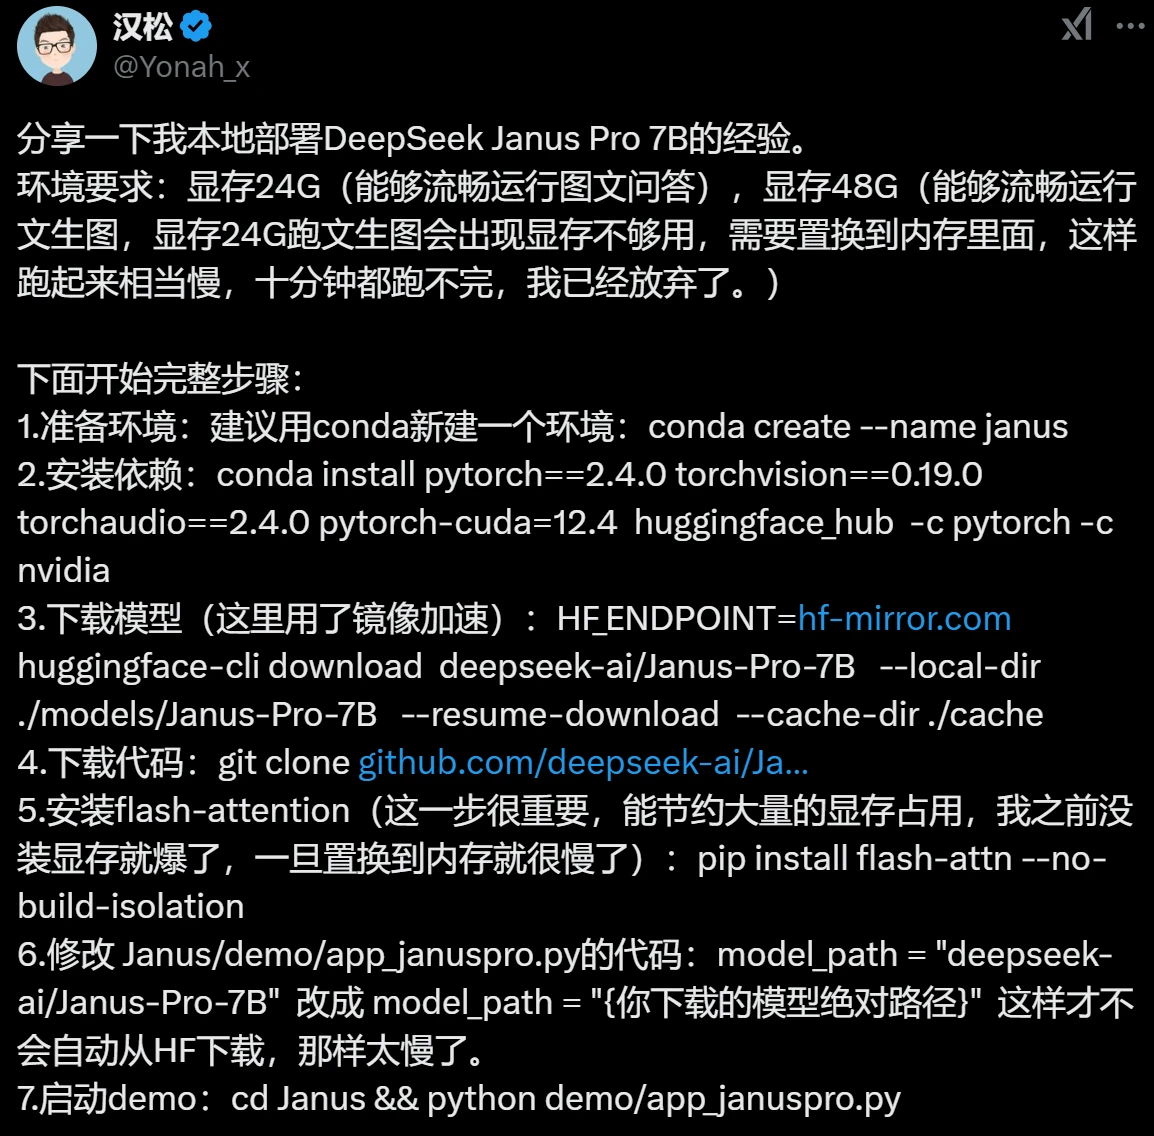
这里也分享X上一位我关注的技术员的本地部署方法:
여기서 X(구 트위터)에서 제가 팔로우하는 한 기술 블로거의 로컬 배포 방법도 공유해 드립니다:
작은 팁:
팁 1: 이전에 conda로 pytorch 환경을 설치한 적이 있다면, conda create --name myenv --clone base 명령어로 기존 환경을 그대로 복제하여 사용할 수 있습니다. 이렇게 하면 매번 pytorch를 새로 다운로드할 필요가 없어 시간을 절약할 수 있습니다.
팁 2: flash-attention을 반드시 설치하세요. 설치하지 않아도 실행은 가능하지만 비디오 메모리가 부족해질 수 있습니다. A100을 사용한다면 이 부분은 무시해도 됩니다.
위 단계를 따라 로컬 환경에서 Janus-Pro-7B의 멀티모달 기능을 빠르게 배포하고 체험할 수 있습니다. 추가로 최적화하거나 모델의 세부 사항을 확인하려면 GitHub 저장소 및 기술 문서를 참고하세요.









