
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
알리바바 통의천문, 차세대 비전-언어 모델 공개: Qwen2.5-VL
小编 ·

알리바바 통의천문, 차세대 비전-언어 모델 공개: Qwen2.5-VL
알리 Qwen2.5-VL은 알리바바 통의천원(通义千问) 팀에서 출시한全新的 시각 이해 모델로, 강력한 시각 이해, 에이전트, 장비디오 이해 및 이벤트 포착 능력을 갖추고 있으며, 다양한 분야에서 AI의 적용과 발전을 추진하는 것을 목표로 합니다.
Qwen2.5-VL 주요 기능
시각 이해: Qwen2.5-VL은 이미지 속의 일반적인 객체(예: 꽃, 새, 물고기, 곤충)를 정확하게 식별할 수 있을 뿐만 아니라, 이미지 내의 텍스트, 차트, 아이콘, 그래프 및 레이아웃을 분석할 수 있습니다. 이를 통해 시각 정보를 처리할 때 뛰어난 성능을 발휘하며, 사용자에게 상세한 이미지 분석 결과를 제공할 수 있습니다.
비디오 이해: 이 모델은 획기적으로 1시간이 넘는 비디오 이해를 지원하며, 비디오 내의 구체적인 이벤트를 식별하고 분석할 수 있습니다. 이로 인해 Qwen2.5-VL은 비디오 콘텐츠 분석 및 처리 측면에서显著的 우위를 가지고 있습니다.
동적 추론 능력: Qwen2.5-VL은 동적 추론 능력을 갖추고 있어, 시각 환경과 텍스트 명령에 따라 복잡한 의사 결정과 작업을 수행할 수 있습니다. 이를 통해 AI 시각 지능체로서 스마트폰, 컴퓨터 등 기기를 직접 조작할 수 있습니다.
다양한 크기 버전: Qwen2.5-VL은 3B, 7B, 72B 세 가지 서로 다른 규모의 모델을 제공하며, 사용자는 요구 사항에 따라 적절한 버전을 선택하여 다양한 컴퓨팅 자원과应用 시나리오에 대응할 수 있습니다.
주요 특징
다양한 크기 버전
3B, 7B, 72B 세 가지 서로 다른 파라미터 규모의 버전을 제공하며, 각각 다양한应用 시나리오와 하드웨어 구성에 적합합니다.
3B 버전: 모바일 및 기타 자원이 제한된 환경에 적합합니다.
7B 버전: 성능과 자원 소모의 균형이 잡혀 있어 대부분의应用 시나리오에 적합합니다.
72B 버전: 최고 성능 버전으로, 고정확도와 강력한 기능을 필요로 하는应用에 적합합니다.
고급 기능
시각 위치 파악 능력: 이미지 내 객체를 정확하게 식별하고 좌표 형태로 위치 정보를 반환할 수 있습니다.
범용 이미지 인식: 일반적인 객체(예: 꽃, 새, 물고기) 인식뿐 아니라, 이미지 내 텍스트, 차트, 아이콘 등의 요소도 분석할 수 있습니다.
문서 파싱: 문서와 표에 대한 이해 능력이 크게 향상되었으며, 특히 학술 문제 해결, 수학 능력, 문서 검증 등에서 뛰어난 성능을 보입니다.
비디오 이해: 장시간 비디오(시간 단위까지) 이해를 지원하며, 초 단위 이벤트 위치 파악 능력을 갖추고 있어 비디오 핵심 내용을 요약하고 핵심 정보를 추출할 수 있습니다.
시각 에이전트: 특정 작업에 대한 미세 조정 없이 컴퓨터와 스마트폰을 조작하여 복잡한 추론 및 의사 결정 작업을 수행할 수 있습니다.
텍스트 인식 및 이해: OCR 인식 능력이 강화되어 다양한 시나리오, 다국어 및 다방향의 텍스트 인식과 정보 추출을 지원합니다.
개선된 부분
시공간 인식 능력: 모델이 시간적·공간적 규모를 인식하는 능력이 강화되어, 다양한 유형의 데이터를 더 잘 이해하고 처리할 수 있습니다.
네트워크 구조 간소화: 윈도우 어텐션 메커니즘을 도입하여 계산 부담을 줄이고 모델 효율을 높였습니다.
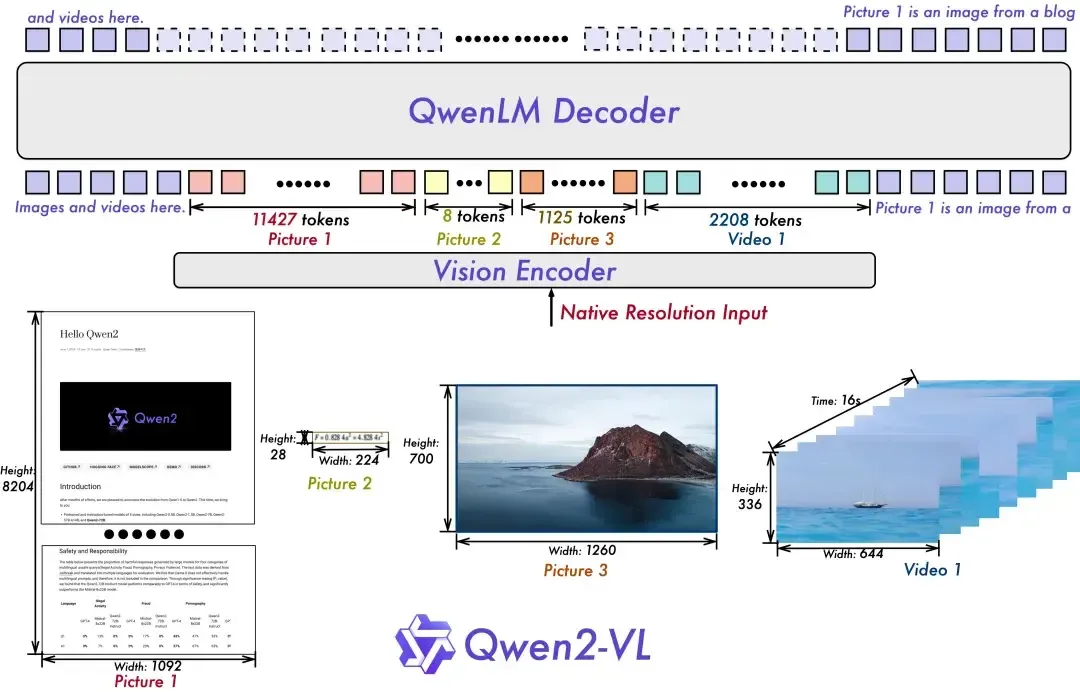
동적 해상도: 네이티브 동적 해상도의 ViT를 사용하여 모델이 네이티브 해상도를 유지하면서도 계산 부담을 줄이도록 하였습니다.
성능表现
다수의 벤치마크 테스트에서 선두: 여러 분야의 벤치마크 테스트에서 우수한 성능을 보였으며, 특히 문서 이해, 시각 질의응답, 비디오 이해, 시각 에이전트 등 다양한 작업에서同类 경쟁 모델을 능가했습니다.
구체적인 사례:
문서 이해: DocVQA 등 작업에서 뛰어난 성능을 보입니다.
비디오 이해: 최대 몇 시간에 달하는 비디오 콘텐츠를 정확하게 이해하고, 중요한 이벤트를 빠르게 위치 파악 및 요약할 수 있습니다.
시각 에이전트: 별도의 조정 없이도 기기와 소프트웨어 인터페이스 제어 등 복잡한 자동화 작업을 수행할 수 있습니다.
Qwen2.5-VL 应用 시나리오
지능형 고객 서비스: Qwen2.5-VL은 비디오 고객 서비스 시나리오에 적용될 수 있으며, 사용자가 보여주는 제품 이미지나 바코드를 실시간으로 분석하고 관련 상품 정보를 제공합니다.
금융 및 비즈니스 분야: 이 모델은 구조화된 출력을 지원하여 인보이스, 양식 등 데이터 처리에 적합하며, 특히 금융 및 비즈니스 분야의应用에 적합합니다.
교육 및 훈련: 교육 분야에서 Qwen2.5-VL은 교육 비디오를 분석하여 학생이 복잡한 개념과 내용을 이해하도록 돕는 데 활용될 수 있습니다.
의료 영상 분석: 이 모델의 시각 이해 능력은 의료 영상 분석에도 활용될 수 있으며, 의사가 영상 데이터를 더 잘 해석하도록 돕습니다.
Qwen2.5-VL 모델은 이전 세대 Qwen-VL의 구조를 이어받아 ViT(비전 트랜스포머)와 Qwen2의 직렬 구조를 채택하여 이미지와 비디오의 통합 입력을 지원합니다. 이러한 설계로 인해 모델이 시각 정보와 언어 정보를 더 잘 융합하여 다중 모달 데이터에 대한 이해 능력을 높일 수 있습니다. 또한 Qwen2.5-VL은 다중 모달 회전 위치 인코딩(M-ROPE)을 도입하여 위치 인코딩을 시간, 공간(높이 및 너비) 세 부분으로 분해함으로써 모델의 다중 모달 처리 및 추론 능력을 강화했습니다. 이 모델은 임의 해상도의 이미지 인식 능력도 갖추고 있어 다양한 해상도와 가로세로 비율의 이미지를 처리할 수 있으며, 입력 정보와 이미지 정보의 일관성을 보장합니다.
Qwen2.5-VL 획득 방법:
오픈소스 주소: Hugging Face
Github: Qwen2.5-VL
온라인 체험: Qwen Chat









