
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
알리바바, 오픈소스 대규모 모델 Qwen2.5-1M 공식 출시
小编 ·

알리바바, 오픈소스 대규모 모델 Qwen2.5-1M 공식 출시
알리바바는 2025년 1월 27일에 오픈소스 대형 모델 Qwen2.5-1M 시리즈를 정식 출시했으며, 이는 통의천문(Tongyi Qianwen) 팀이 처음으로 오픈소스 모델의 컨텍스트 길이를 100만 토큰(약 10권의 장편 소설 또는 3만 줄의 코드에 해당)으로 확장하고, 장문 처리 성능에서显著한 돌파구를 마련한 것입니다.
1. Qwen2.5-1M의 주요 특징
초장문 컨텍스트 지원: Qwen2.5-1M 모델은 최대 100만 토큰의 컨텍스트 처리를 지원하며, 이는 약 100만 개의 영단어 또는 150만 개의 한자와 같습니다. 이러한 특성 덕분에 모델은 책, 법률 문서, 장문 보고서와 같은 장문 문서를 번거로운 텍스트 분할 없이 처리할 수 있습니다.
다양한 모델 크기: 이번에 발표된 모델에는 Qwen2.5-7B-Instruct-1M과 Qwen2.5-14B-Instruct-1M이 포함되어 있으며, 다양한 파라미터 규모를 제공하여 여러 가지 응용 시나리오의 요구를 충족합니다.
효율적인 추론 프레임워크: Qwen 팀은 vLLM 기반의 추론 프레임워크를 오픈소스로 공개했으며, 희소 어텐션 메커니즘을 통합하여 1M 토큰 입력을 처리할 때의 속도를 3배에서 7배까지 향상시켰습니다. 이러한 효율성 덕분에 개발자는 모델을 더 빠르게 배포하고 활용할 수 있습니다.
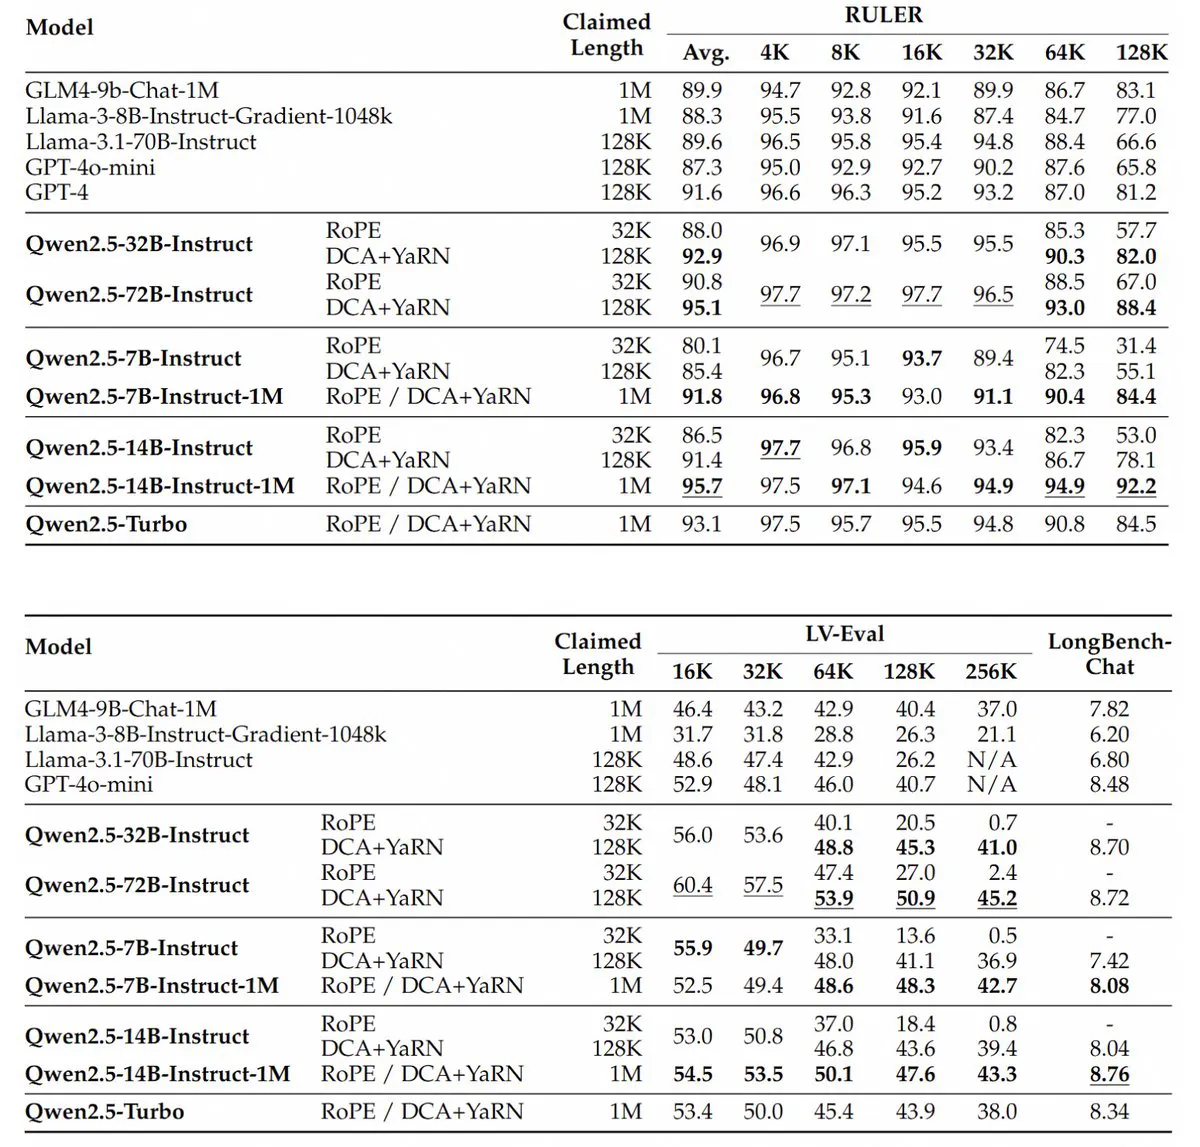
성능 우위: 장문 작업에서 Qwen2.5-1M 모델의 성능은 이전 128K 버전을显著하게 능가하며, 특히 64K를 초과하는 길이의 작업을 처리할 때 더 강력한 능력을 보여줍니다.
2. 모델 특성과 성능
장문 컨텍스트 처리 능력
백만 토큰 지원: Qwen2.5-1M 시리즈는 7B와 14B 두 가지 버전을 포함하며, 1M 토큰의 컨텍스트 길이를 네이티브하게 지원하여 장문 문서, 코드 저장소 또는 복잡한 다회 대화를 분할 입력 없이 처리할 수 있습니다.
정확한 검색 및 이해: "바다에서 바늘 찾기"(Passkey Retrieval) 작업에서 모델은 1M 토큰 문서에서 숨겨진 정보를 정확하게 추출할 수 있으며, 7B 버전에서만 소수의 오류가 발생합니다. RULER, LV-eval 등 장문 이해 벤치마크 테스트에서 14B 버전은 자사의 비공개 모델인 Qwen2.5-Turbo와 Openai의 GPT-4o-mini를 안정적으로 능가하는 성능을 보입니다.
단문 작업 호환성
7B와 14B 모델은 단문 작업(예: 질의응답, 요약)에서 128K 버전과 동등한 성능을 보이며, 장문 컨텍스트 능력의 강화로 인해 기본 성능이 손상되지 않았습니다. 예를 들어, 14B 모델은 단문 작업에서 GPT-4o-mini와 비슷한 성능을 보이지만, 컨텍스트 길이는 그 8배에 달합니다.
3. 기술적 돌파와 오픈소스 프레임워크
점진적 훈련과 길이 외삽
단계적 확장: 사전 훈련부터 감독 미세 조정에 이르기까지, 컨텍스트 길이를 4K에서 256K로 점진적으로 확장한 후, 강화 학습을 통해 단문 정렬 능력을 최적화합니다56.
Dual Chunk Attention (DCA): 혁신적인 위치 인코딩 외삽 기술을 도입하여, 추가 훈련 없이 모델이 지원하는 컨텍스트 길이를 256K에서 1M으로 확장할 수 있게 했으며, 장거리 위치 인코딩의 어텐션 퇴화 문제를 해결했습니다.
효율적인 추론 최적화
희소 어텐션 메커니즘: vLLM 프레임워크에 희소 어텐션(MInference)을 통합하고, 청킹 프리필과 동적 병렬 기술을 결합하여 1M 토큰 입력의 추론 속도를 3.2~6.7배 향상시키고, 메모리 사용량을 크게 줄였습니다(예: 7B 모델의 활성화 메모리 96.7% 감소).
오픈소스 프레임워크 지원: 추론 프레임워크와 훈련 기술 보고서를 완전히 오픈소스로 공개하여, 개발자가 모델을 빠르게 배포할 수 있으며, FP8 양자화를 지원하여 하드웨어 요구 사항을 낮춥니다.
4. 응용 시나리오
텍스트 생성: Qwen2.5-1M 모델은 장문의 기사, 보고서, 이야기를 생성하는 데 사용할 수 있으며, 콘텐츠 제작, 뉴스 작성을 포함한 분야에 적합합니다.
정보 검색: 초장문 컨텍스트 처리 능력 덕분에, 모델은 장문에서 효과적인 정보 검색을 수행할 수 있으며, 법률, 의료 등 대량의 문서를 처리해야 하는 산업에 적합합니다.
대화 시스템: 이 모델은 복잡한 대화 내용을 이해하고 생성할 수 있는 지능형 대화 시스템을 구축하는 데 사용될 수 있으며, 사용자 경험을 향상시킵니다.
멀티모달 응용: Qwen2.5-1M 모델의 설계는 이미지, 오디오 등 다른 모달리티와 결합할 수 있게 해주어, 멀티모달 이해 및 생성 작업으로 응용 범위를 확장합니다.
Qwen2.5-1M의 출시는 오픈소스 모델의 초장문 컨텍스트 처리 분야의 공백을 메웠을 뿐만 아니라, 기술 혁신과 생태계 개방을 통해 개발자에게 고성능, 저문턱의 도구 선택지를 제공합니다. 그 성공은 글로벌 AI 산업의 장문 응용 탐구를 가속화하고, AGI 경주에서 오픈소스 커뮤니티의 역할 격상을 촉진할 가능성이 있습니다.









