
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
FunAudioLLM: 알리바바의 음성 AI 돌파구
小编 ·

FunAudioLLM: 알리바바의 음성 AI 돌파구
FunAudioLLM은 알리바바(阿里巴巴)가 개발한 음성 처리 모델로, 인간과 대규모 언어 모델 간의 음성 상호작용을 개선하는 것을 목표로 합니다. 이 모델은 두 가지 주요 모델, 즉 SenseVoice와 CosyVoice로 구성됩니다.
SenseVoice:다양한 언어의 음성을 인식하고 화자의 감정을 식별하며 오디오 내 특수 이벤트(예: 음악, 웃음 등)를 감지할 수 있는 음성 인식 모델입니다. 빠르고 정확하게 음성 내용을 전사할 수 있습니다.
CosyVoice:음성 생성 모델로, 자연스럽고 감정 표현이 풍부한 음성을 주로 생성합니다. 다양한 화자를 모방할 수 있으며, 몇 초 분량의 오디오 샘플만으로 한 사람의 목소리를 복제하는 것도 가능합니다.
SenseVoice와 CosyVoice의 결합을 통해 FunAudioLLM은 포괄적인 음성 이해 및 생성 능력을 제공하여 인간과 대규모 언어 모델 간의 음성 상호작용을 보다 자연스럽고 풍부하게 만듭니다.
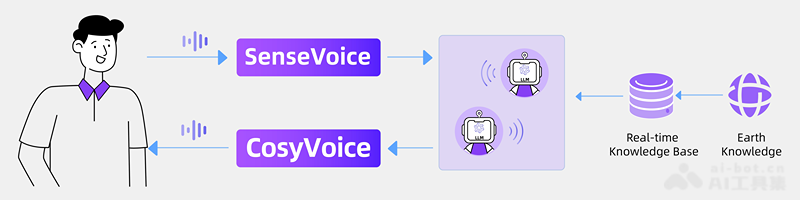
SenseVoice와 CosyVoice의 주요 특징:
SenseVoice는 다국어 음성 인식, 감정 인식 및 오디오 이벤트 감지에 집중하여 고정밀·저지연의 음성 처리 능력을 제공합니다. CosyVoice는 자연스러운 음성 생성과 제어에 집중하며, 다양한 언어, 음색, 말투의 생성을 지원하여 제로샷(zero-shot) 학습과 세밀한 음성 제어를 구현합니다. 이 둘의 결합 덕분에 FunAudioLLM은 다양한 응용 시나리오에서 우수한 음성 상호작용 경험을 제공할 수 있습니다.
SenseVoice 주요 특징
1. 다국어 음성 인식
SenseVoice-Small:중국어, 영어, 광둥어(粤語), 일본어, 한국어 등 다섯 가지 언어를 지원합니다. 비자기회귀(non-autoregressive) 엔드투엔드(end-to-end) 아키텍처를 채택하여 인식 지연이 매우 낮습니다. Whisper-small보다 5배, Whisper-large보다 15배 빠릅니다.
SenseVoice-Large:고정밀 음성 인식을 지원하며, 50개 이상의 언어를 지원합니다.
2. 감정 인식
발화의 음높이, 리듬, 억양 변화를 감지하여 발화 속의 감정(예: 기쁨, 슬픔, 분노 등)을 식별합니다.
3. 오디오 이벤트 감지
음성 내의 특수 이벤트(예: 음악, 웃음, 박수 등)를 감지하고 이벤트의 시작과 종료 시간을 예측합니다.
SenseVoice-Small은 배경 음악, 박수, 웃음, 울음, 기침, 재채기 등 다양한 인간-기계 상호작용 이벤트를 감지할 수 있습니다.
4. 언어 식별
화자가 사용하는 언어를 식별하여 음성 인식 및 문맥 이해의 정확성을 보장합니다.
5. 역방향 텍스트 정규화(ITN)
가독성과 정확성이 향상된 구두점 및 서식이 포함된 전사 결과를 제공합니다.
FunAudioLLM의 주요 특징:
다국어 음성 인식:40만 시간 이상의 학습 데이터로 Whisper 모델보다 우수한 인식 성능을 제공합니다.
효율적인 추론:SenseVoice-Small 모델은 비자기회귀 엔드투엔드 프레임워크를 채택하여 추론 지연이 매우 낮습니다. 10초 분량의 오디오를 처리하는 데 단 70밀리초만 소요되어 Whisper-Large보다 15배 빠릅니다.
감정 인식:여러 테스트 데이터셋에서 현재 가장 뛰어난 감정 인식 모델과 동등한 결과를 달성했습니다.
이벤트 감지:다양한 일반적인 오디오 이벤트 감지를 지원합니다.
편리한 미세 조정(fine-tuning):편리한 미세 조정 스크립트와 전략을 제공하여, 사용자가 비즈니스 시나리오에 맞춰 롱테일(long-tail) 샘플 문제를 손쉽게 해결할 수 있습니다.
서비스 배포:서비스 배포 파이프라인을 제공하며, 다수의 동시 요청을 지원합니다. 클라이언트 언어로는 Python, C++, HTML, Java, C# 등이 있습니다.
CosyVoice의 주요 특징:
1. 음성 생성
중국어, 영어, 광둥어, 일본어, 한국어를 포함한 다국어 음성 생성을 지원합니다.
자연스럽고 감정 표현이 풍부한 음성을 생성할 수 있으며, 다양한 말투와 감정 표현을 지원합니다.
2. 다양한 음성 제어
음색 제어:생성된 음성의 음색을 정밀하게 제어하여 특정 화자의 목소리와 일치시킬 수 있습니다.
말투 제어:텍스트 명령을 통해 감정, 말하기 속도, 음높이 등 음성의 말투를 제어할 수 있습니다.
3. 제로샷(Zero-shot) 학습
몇 초 분량의 오디오 샘플만으로 음성을 복제할 수 있으며, 추가적인 학습 데이터가 필요하지 않습니다.
크로스 언어 음성 복제를 지원하여, 한 언어의 음성을 다른 언어에서 사용하도록 할 수 있습니다.
4. 부언어적(Paralinguistic) 특성의 세밀한 제어
웃음, 숨소리, 추임새 등의 미세한 음성 특성을 삽입하는 것을 지원하여, 생성된 음성을 더욱 자연스럽고 생생하게 만듭니다.
텍스트 명령 제어:텍스트 명령을 통해 화자의 정체성, 감정, 말투를 정밀하게 제어할 수 있습니다.
5. 다중 역할 대화
인터랙티브 팟캐스트, 감정 채팅 등 시나리오에 적합한 다중 캐릭터 대화 음성을 생성할 수 있습니다.
프로젝트 주소:https://github.com/FunAudioLLM









