
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
Seed-ASR: 바이트댄스의 자동 음성 인식 모델

Seed-ASR: 바이트댄스의 자동 음성 인식 모델
Seed-ASR, 바이트댄스의 자동 음성 인식 모델로, 다양한 음성을 텍스트 정보로 변환할 수 있습니다. 기존 TTS가 단일 작업에만 초점을 맞추는 것과 달리, Seed-TTS는 다양한 음성을 모델링할 수 있을 뿐만 아니라 여러 차원에서 동시에 조작이 가능하여, 서로 다른 언어, 방언, 억양, 심지어 발음이 뭉개지는 등의 음성 결함까지도 인식할 수 있습니다.Seed-ASR은 2,000만 시간 이상의 음성 데이터와 약 90만 시간의 쌍을 이루는 ASR 데이터로 학습되었습니다.표준 중국어뿐만 아니라 13종의 중국 방언과 7종의 외국어, 다양한 억양의 영어도 인식할 수 있습니다.
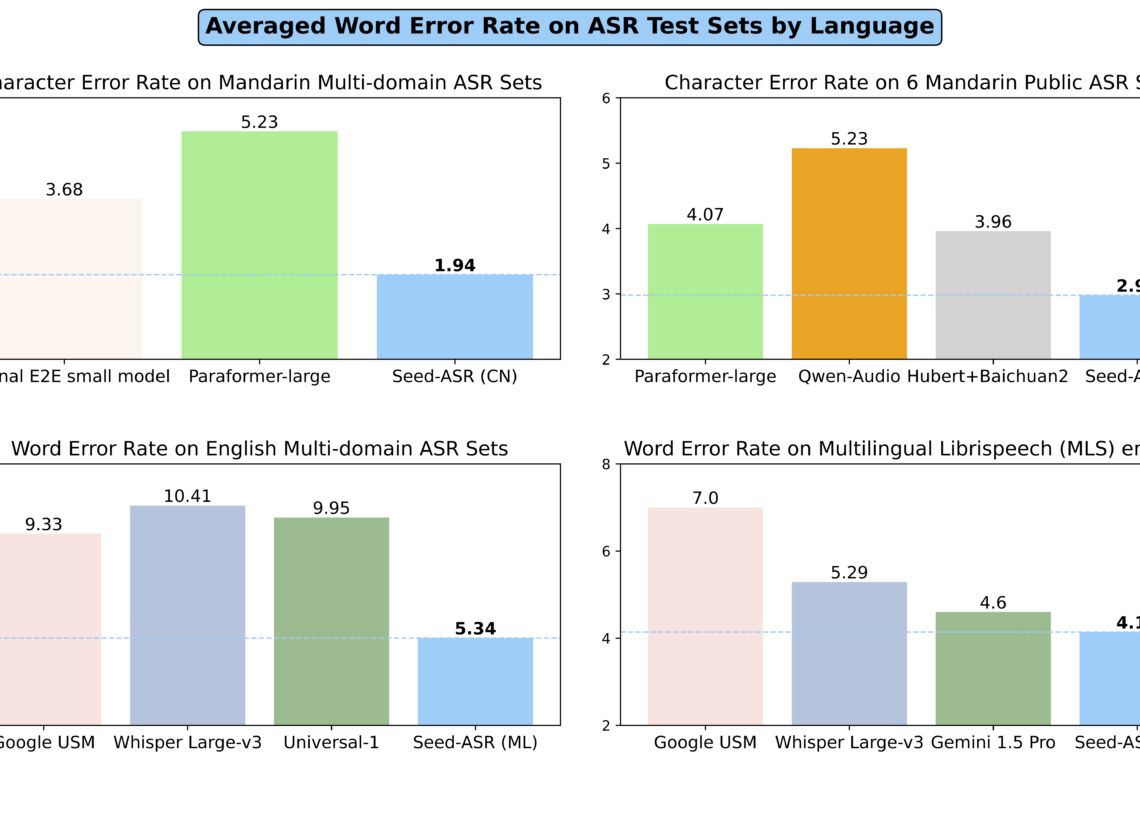
Seed-ASR은 강력한 문맥 인지 능력을 갖추고 있어 특정 문맥 속의 음성 내용을 인식할 수 있습니다. 예를 들어, 모델은 과거 대화나 회의 기록을 활용해 현재 음성 속 인명, 지명 또는 기타 문맥 관련 키워드를 더 정확하게 인식할 수 있습니다.
Seed-ASR은 강력한 확장성을 갖췄습니다. 이는 고정된 시스템일 뿐만 아니라 특정 요구에 맞춰 맞춤 제작할 수 있는 플랫폼이기도 하다는 것을 의미합니다. 예를 들어, 의학 용어를 특화하여 인식하도록 하거나, 특정 특수한 억양을 이해하도록 만드는 것도 미세 조정을 통해 구현할 수 있습니다.
Seed-ASR의 가장 핵심적인 기술은 대규모 언어 모델을 음성 인식에 융합한 것으로, 이를 통해 Seed-ASR에 문맥 이해 능력을 부여했습니다. 이는 단순히 두 시스템을 결합한 것이 아니라 음성 처리 방식을 근본적으로 변화시킨 것입니다. 마치 음성 인식 시스템에 슈퍼 두뇌를 장착한 것과 같아서, 듣기만 할 뿐만 아니라 사고까지 할 수 있습니다.
Seed-ASR 기술亮点:
고정밀 인식:수십억 개의 매개변수를 가진 모델이 복잡한 음성 입력을 처리하여 고정밀 인식을 실현합니다.
대용량 모델:대규모 언어 모델을 사용하여 음성 인식의 정확성과 문맥 이해 능력을 향상시켰습니다. 이는 마치 "슈퍼컴퓨터"로 필기를 받아쓰는 것과 같아서, 생각만 해도 매우 멋집니다.
다국어 지원:표준 중국어, 13종의 중국 방언 및 다양한 외국어를 포함하며, 40여 종의 언어로 확장할 계획입니다.
문맥 인지:문맥 정보를 결합하여 인식 정확도를 높일 수 있어, 마치 친구와 대화할 때 이전에 나눈 대화를 이해한 후 그 정보를 바탕으로 지금 하는 말을 더 정확하게 이해하는 것과 같습니다.
단계별 학습 방법:자기지도 학습, 지도 미세 조정, 문맥 미세 조정, 강화 학습을 포함하여 모델 능력을 점진적으로 강화합니다.
Seed-ASR 应用场景:
인간-기계 상호작용:음성 입력 채널을 제공하여 음성을 실시간으로 텍스트로 변환함으로써 기기/하드웨어/응용 프로그램과 빠르고 편리하게 상호작용하는 목적을 달성합니다.
콘텐츠 심사:녹음을 텍스트로 인식한 후 품질 검사 규칙을 통해 텍스트를 분석하여 위반 콘텐츠를 적시에 발견하고 개입하여 처리합니다.
회의 및 인터뷰 전사:회의, 인터뷰 오디오를 실시간 또는 비동기적으로 텍스트로 인식하고 음성 부분을 자동으로 분할하여 인식함으로써 비용을 절감하고 효율을 높입니다.
오디오비디오 자막:오디오 및 비디오의 음성, 가사를 자동으로 인식하여 텍스트로 변환하고, 한 번의 클릭으로 오디오 및 비디오에 대응하는 자막 내용을 생성하는 기능을 지원합니다.
Seed-ASR은 이미 豆包(Doubao) APP에 적용되어 영어 회화, 가상 대화 동반자, 가족 및 지인의 음성 복제 등 여러 시나리오에서 사용되고 있습니다. 더 많은 기업 고객을 대상으로 Seed-ASR은 화산 엔진(火山引擎)에 기반하여 음성 상호작용, 콘텐츠 심사, 회의 및 인터뷰 전사, 오디오 및 비디오 자막 등의 시나리오에서도 활용되었습니다.
현재까지 豆包 대규모 모델 팀의 음성 분야에서는 Seed-TTS, Seed-ASR 등 다수의 기술 성과를 발표했습니다.
Seed-ASR 공식 사이트:https://bytedancespeech.github.io/seedasr_tech_report/









