
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
Hallo: 초상화 이미지 애니메이션을 위한 계층적 오디오 기반 시각 합성
小编 ·

Hallo: 초상화 이미지 애니메이션을 위한 계층적 오디오 기반 시각 합성
Hallo는 단일 이미지와 오디오 입력을 기반으로 노래 및 말하는비디오를 생성할 수 있으며, 인물의 표정과 자세를 제어할 수 있습니다.EMO와 비교했을 때, Hallo는 계층적인 오디오 기반 시각 합성을 구현하기 위해 확산 모델을 사용하기 때문에,음성을 입력으로 하여 해당 인물의 입술 동기화, 표정 변화 및 자세 변화가 있는 애니메이션을 생성할 수 있습니다. 음성과 생성된 애니메이션 간의 정렬 정밀도를 향상시켜 애니메이션의 입술, 표정 및 자세가 음성과동기화되도록 합니다.
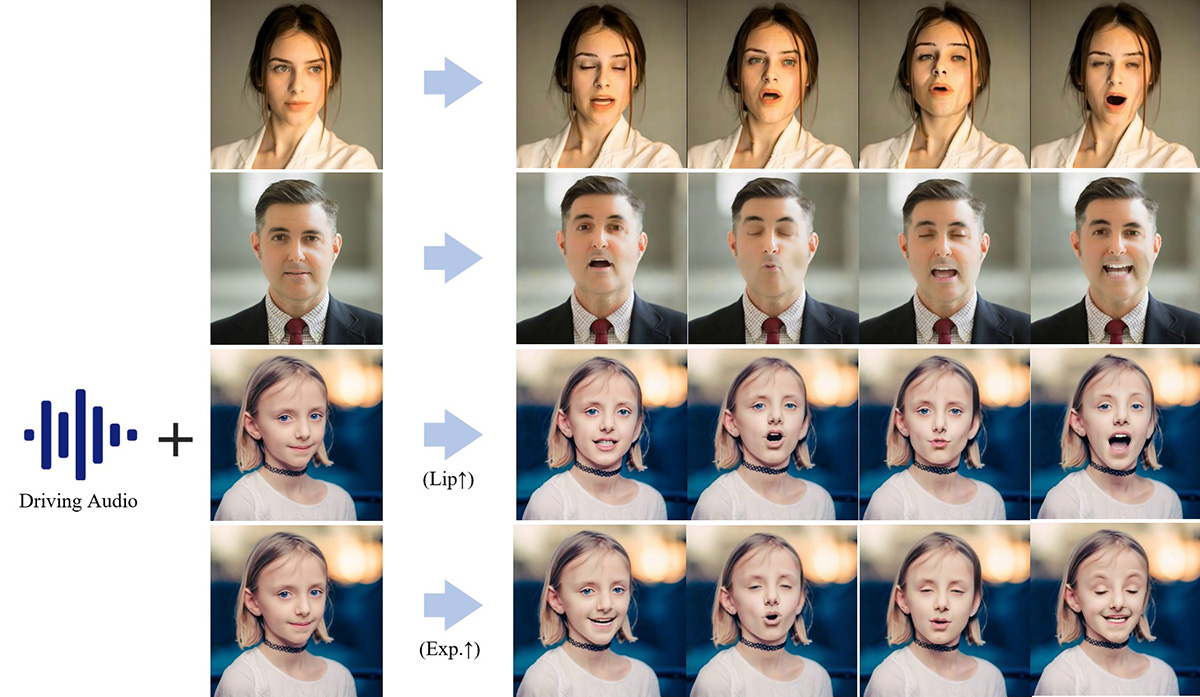
Hallo 기능 특징:
가상 캐릭터 애니메이션 생성: 음성 오디오 입력을 통해 사실적이고 역동적인 가상 캐릭터 애니메이션을 생성하며, 가상 캐릭터의 입 모양, 표정 및 자세의 정밀한 동기화를 실현합니다.
실제 캐릭터 애니메이션 생성: 기술을 실제 인물의 음성 기반 애니메이션 생성에 적용하여, 실제 인물의 표정과 동작 변화를 정확하게 반영하는 애니메이션을 생성합니다.
다양한 모션 제어: 캐릭터의 표정, 자세 및 입술 움직임에 대한 정밀한 제어를 제공하며, 다양한 표정 및 자세의 적응형 제어를 지원하여 애니메이션의 다양성과 사실성을 향상시킵니다.
크로스 배우 적용: 다양한 정체성의 개인화된 애니메이션 생성을 지원하며, 오디오 입력을 통해 다양한 캐릭터 정체성에 적응하는 애니메이션 효과를 생성합니다.
노래 애니메이션 생성: 음성 및 노래 오디오 입력을 통해 동기화된 노래 애니메이션을 생성하며, 애니메이션은 노래 부를 때의 입 모양과 표정 변화를 정확하게 반영할 수 있습니다.
Hallo 기타 특징:
실시간성: 확산 모델 구조를 채택하여 애니메이션 생성의 실시간성을 강화하고, 생성된 애니메이션을 더욱 사실적이고 자연스럽게 만듭니다.
개인화: 다양한 배우나 캐릭터에 따라 서로 다른 개인화된 애니메이션 효과를 맞춤 설정할 수 있습니다.
다양성: 표정, 자세 및 입술 움직임을 포함한 다양한 모션 제어를 제공하여 애니메이션을 더욱 다양하고 사실적으로 만듭니다.
Hallo 프로젝트 주소:https://fudan-generative-vision.github.io/hallo
Hallo Github:https://github.com/fudan-generative-vision/hallo
Hallo 논문:https://arxiv.org/abs/2406.08801
HuggingFace:https://huggingface.co/fudan-generative-ai/hallo









