
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
Seed-TTS: ByteDance의 고품질 텍스트-음성 변환 모델
小编 ·

Seed-TTS: ByteDance의 고품질 텍스트-음성 변환 모델
최근 TTS 분야에서 폭발적인 발전이 일어나고 있습니다. chatTTS가 오픈소스화된 직후, Byte가 seed-tts를 공개했으며 그 효과가 매우 뛰어나다는 평가를 받고 있습니다.
Seed-TTS는 ByteDance가 개발한 고품질 텍스트 음성 합성(TTS) 모델로, 사람 음성과 거의 구별할 수 없을 정도의 음성을 생성할 수 있습니다.
음성 생성을 위한 기초 모델로서,Seed-TTS는 음성 문맥 학습에서 뛰어난 성능을 보이며, 화자 유사도와 자연스러움 측면에서 객관적·주관적 평가 모두에서 실제 사람 음성에 필적하는 성능을 나타냅니다.
Seed-TTS는 별도의 학습 없이도 짧은 음성 샘플만으로 매우 자연스럽고 표현력이 풍부한 음성을 클로닝하여 생성할 수 있으며, 소설 낭독이나 더빙 등의 작업도 수행할 수 있습니다.
Seed-TTS는 감정, 억양, 말하기 스타일 등 다양한 음성 속성에 대한 고급 제어 기능을 제공하며, 텍스트를 편집하여 생성된 음성을 편집할 수도 있습니다.
Seed-TTS는 음색, 음높이, 감정을 유지하면서 오디오의 내용을 수정할 수 있습니다.
Seed-TTS는 음성 속도 조절이 가능하여 오디오 속도를 자유롭게 제어할 수 있습니다.
Seed-TTS는 감정과 같은 다양한 음성 속성에 대해 탁월한 제어 가능성을 제공하며, 실제 환경의 화자에 대해 매우 표현력이 풍부하고 다양한 음성을 생성할 수 있습니다.
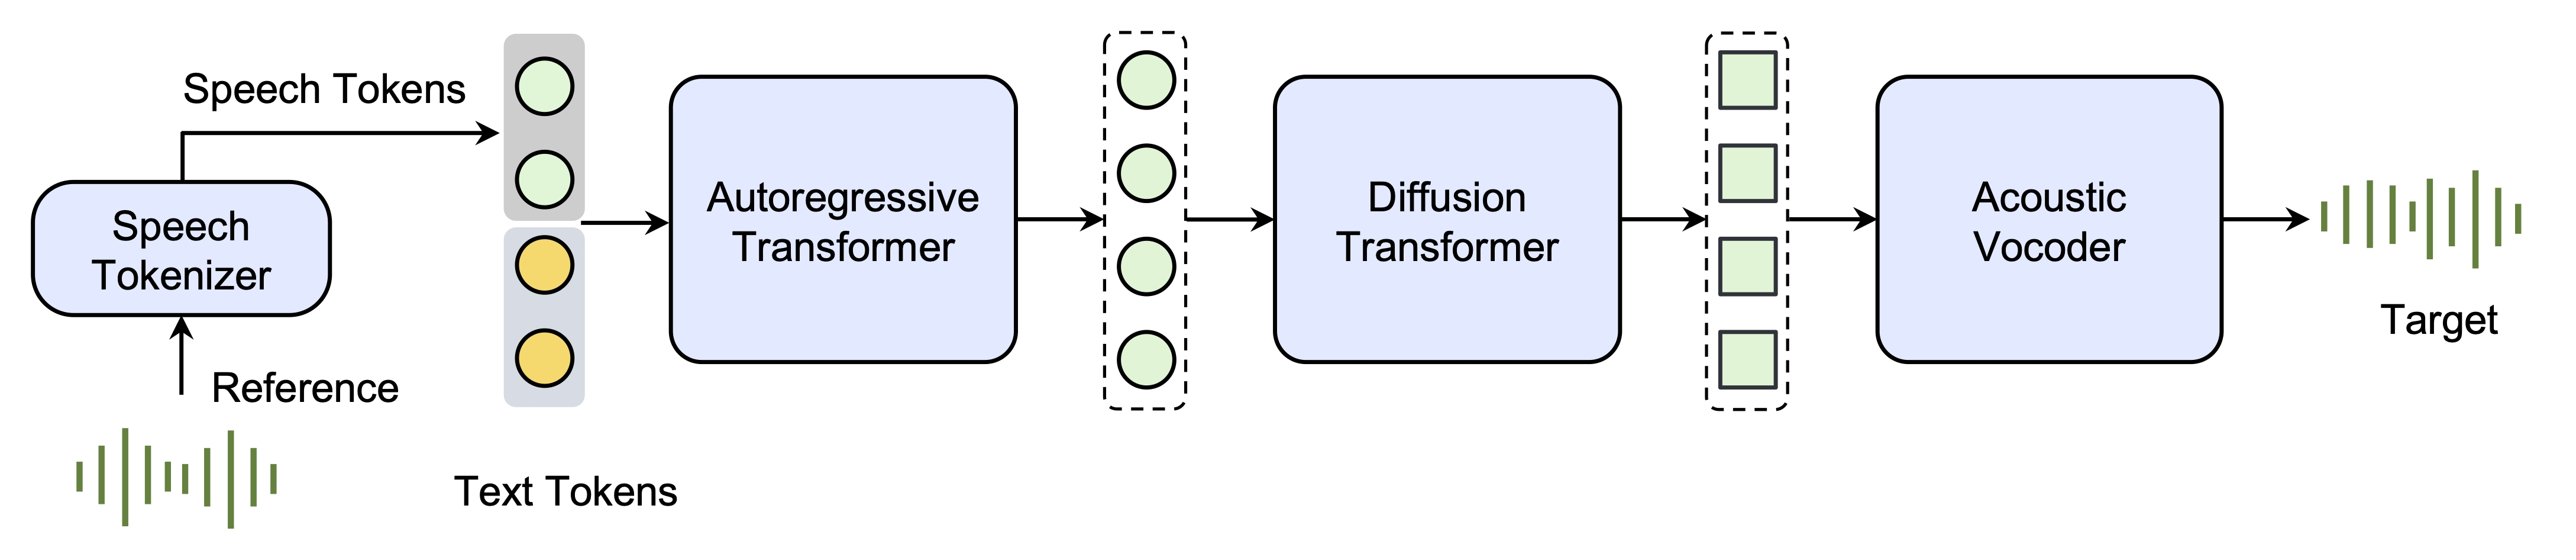
또한, 우리는 음성 분해를 위한 자기 증류 방법과 모델의 견고성, 화자 유사성 및 제어 가능성을 향상시키기 위한 강화 학습 방법을 제안합니다. 또한 Seed-TTS DiT라는 Seed-TTS 모델의 비자기회귀(NAR) 변형 모델을 제안하며, 이는 완전히 확산(diffusion) 기반 아키텍처를 채택합니다. 기존의 NAR 기반 TTS 시스템과 달리, Seed-TTS DiT는 사전에 추정된 음소 지속 시간에 의존하지 않으며 엔드 투 엔드 방식으로 음성 생성을 수행합니다. 우리는 이 변형 모델이 객관적·주관적 평가 모두에서 언어 모델 기반 변형 모델과 동등한 성능을 달성하며, 음성 편집에서의 효과를 입증한다는 것을 보여줍니다.
논문: https://arxiv.org/abs/2406.02430









