
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
Mobile-Agent-v2: 강력한 모바일 기기 조작 어시스턴트
小编 ·

Mobile-Agent-v2: 강력한 모바일 기기 조작 어시스턴트
알리바바와 북경교통대학의 Mobile-Agent-v2는 다중 에이전트 협업을 통해 효과적인 탐색을 구현하는 모바일 기기 조작 어시스턴트인 Mobile-Agent-v2를 출시했습니다. 이는 다중 에이전트 협업을 통해 모바일 기기의 자동화된 조작 및 시각 인지 기능을 구현하여 ai가 실제 사람처럼 클릭, 슬라이드, 입력 등의 작업을 시뮬레이션하여 사용자의 휴대전화를 제어함으로써 다양한 작업을 수행할 수 있게 합니다.
Mobile-Agent-v2 배경
전통적으로 모바일 기기 조작 작업은 다중 작업 처리 측면에서 부족함이 있었으며, 이는 주로 현재 다중 모달 LLM(MLLM)의 탐색 및 포커스 관리 제한 때문입니다. 이러한 제한의 결과는 긴 시퀀스 및 혼합 데이터 형식에서의 성능 저하를 포함하며, 이는 작업 진행 상황과 포커스 콘텐츠의 효과적인 탐색을 특히 어렵게 만듭니다. MLLM 기반 에이전트의 등장은 도구 호출을 통해 MLLM의 확장 기능을 강화하여 새로운 솔루션을 가져왔지만, 모바일 기기 조작에 내재된 탐색 문제를 해결하지는 못했습니다.
Mobile-Agent-v는 다중 에이전트 아키텍처 기반의 순수 시각 솔루션으로, 더 강력한 작업 분해, 크로스 애플리케이션 조작, 다국어 기능을 갖추고 있습니다.
Mobile-Agent-v2 아키텍처 및 방법론
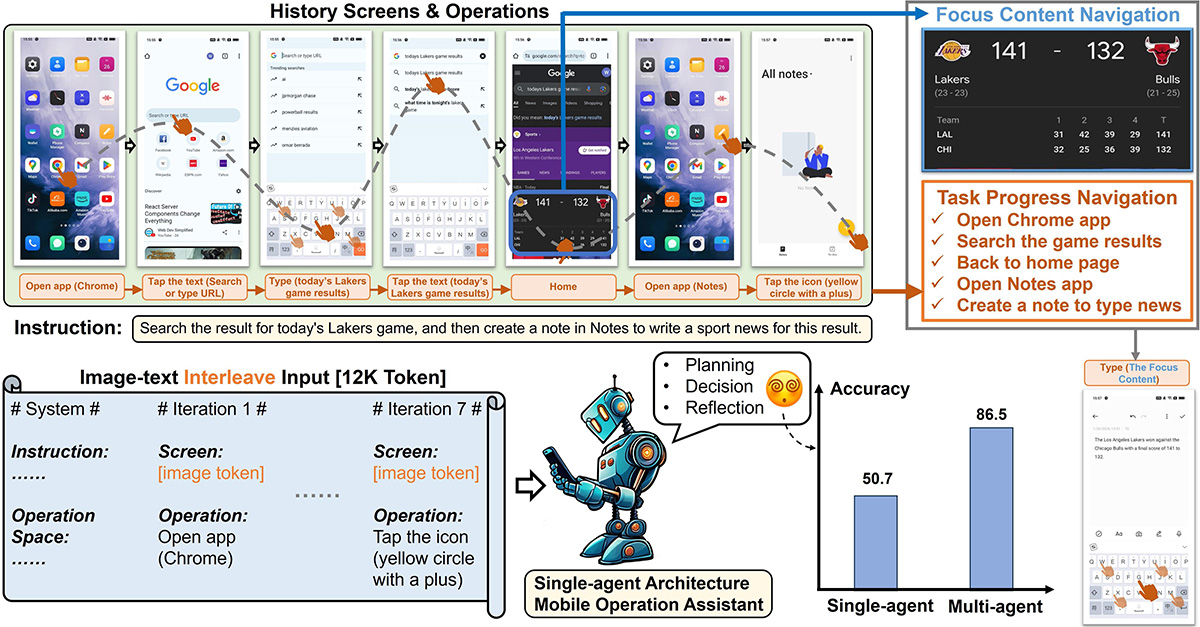
Mobile-Agent-v2는 세 개의 전문 에이전트(계획 에이전트, 결정 에이전트, 반성 에이전트)로 구성된 다중 에이전트 시스템을 도입했습니다. 각 에이전트는 서로 다른 역할을 수행하여 탐색 및 결정 과정을 함께 강화합니다.
계획 에이전트: 이 에이전트는 이러한 기록을 관리 가능한 순수 텍스트 작업 진행 상황으로 요약 및 압축하여 긴 조작 기록의 복잡성을 해결합니다. 작업 진행 상황은 결정 에이전트에 전달되어 컨텍스트 길이를 줄임으로써 더 쉬운 탐색과 결정을 촉진합니다.
결정 에이전트: 결정 에이전트는 시각 인지 모듈 내에서 작동하여 농축된 작업 진행 상황을 처리하고 현명한 조작 결정을 내립니다. 향후 단계에서 참조할 수 있도록 관련 포커스 콘텐츠로 메모리 단위를 업데이트하는 역할을 담당합니다. 이 기능은 에이전트가 과거 화면을 기반으로 정확한 포커스 컨텍스트를 유지할 수 있도록 보장합니다.
반성 에이전트: 잠재적인 잘못된 조작을 관리하고 수정하기 위해 반성 에이전트는 예상 결과와 관련하여 각 조작의 결과를 평가합니다. 조작 전후의 화면 변화를 분석하여 오류 및无效 조작을 식별, 분류 및 대응함으로써 작업 실행의 신뢰성을 강화합니다.
Mobile-Agent-v2 시나리오 응용
상품 검색 및 구매: 쇼핑 애플리케이션에서 자동으로 상품을 검색하고 장바구니에 추가하여 구매를 완료합니다.
이메일 발송: Gmail에서 자동으로 메일을 작성하고 발송합니다.
네비게이션: Google Maps에서 자동으로 내비게이션 작업을 수행합니다.
동영상 시청: YouTube에서 특정 동영상을 검색하고 댓글을 답니다.
Mobile-Agent와 비교: 단일 에이전트에 의존하여 작업을 수행합니다. Mobile-Agent-v2: 다중 에이전트 협업 아키텍처를 도입하여 여러 에이전트가 협력하여 작업함으로써 더 효율적인 탐색과 작업 실행을 구현합니다.
실험 결과는 이전 모바일 에이전트 아키텍처에 비해 실질적인 개선을 보여주었습니다. Mobile-Agent-v2의 작업 완료율은 30% 이상 향상되었으며, 이는 다중 에이전트 협업의 효과를 잘 보여줍니다. 여러 단계와 교차 모드를 포함하는 작업은 모바일 기기 조작의 복잡성을 효과적으로 탐색하고 관리할 수 있기 때문에 새로운 아키텍처의 큰 이점을 누릴 수 있습니다.
Mobile-Agent-v2 논문:https://arxiv.org/abs/2406.01014
Mobile-Agent-v2 코드:https://github.com/X-PLUG/MobileAgent
Modelscope-agent:https://github.com/modelscope/modelscope-agent









