
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
ViViD: 확산 모델을 활용한 가상 착용 영상
小编 ·

ViViD: 확산 모델을 활용한 가상 착용 영상
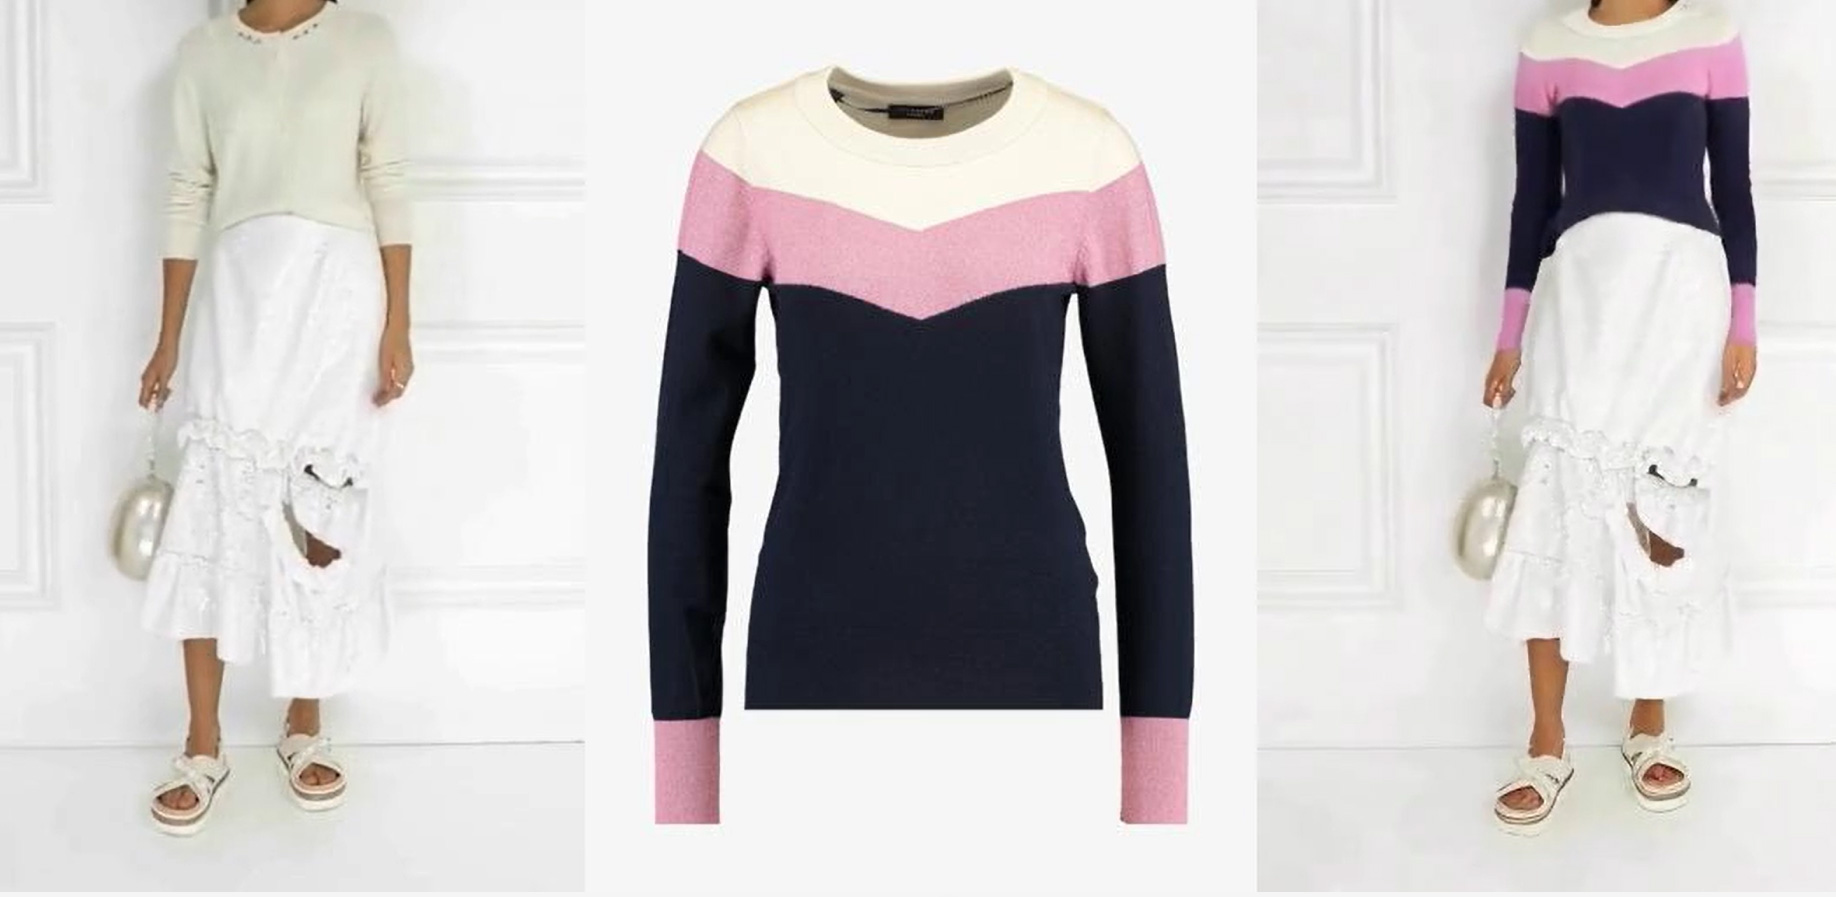
ViViD는 알리바바가 개발한 비디오 가상 착용 기술로, 비디오 속 인물의 옷을 자유롭게 교체할 수 있으며, 자연스럽고 사실적인 가상 착용 비디오를 생성할 수 있습니다. 비디오 속 인물에게 의상을 전달하면서 비디오의 나머지 부분은 변경되지 않도록 유지할 수 있습니다.
ViViD 데모 사이트: https://becauseimbatman0.github.io/ViViD
ViViD 논문 주소: https://arxiv.org/abs/2405.11794
전자상거래의 급속한 발전에 따라 소비자는 온라인 타오바오, 징둥 등 전자상거래 플랫폼을 통해 다양한 유형의 의류에 편리하게 접근할 수 있습니다. 그러나 전자상거래 웹사이트의 의류 이미지에만 의존하는 경우, 소비자는 의류를 본인의 몸에 입었을 때의 모습을 상상하기 어렵습니다. 이미지 기반 의상 교체 기술은 이미 상당히 성숙되었지만, 특히 신체 동작과의 상호작용 측면에서 비디오 의상 교체 기술은 여전히 보기 드뭅니다.
가상 착용 비디오는 의류를 대상人物에게 옮기는 방식으로 작동합니다. 이미지 기반 착용 기술을 프레임 단위로 비디오 분야에 직접 적용하면 시간적 일관성이 없는 결과가 발생하며, 기존의 비디오 기반 착용 솔루션은 낮은 시각적 품질과 흐릿한 결과만 생성할 수 있었습니다.
중국 과학기술대학교와 알리바바 그룹의 연구 팀이 공동으로 개발한 ViViD 비디오 가상 착용 기술의 목적은 비디오 합성을 통해 이 문제를 해결하여, 소비자가 자신의 몸에 입은 의류의 실제 효과를 볼 수 있도록 하는 것입니다. 이 비디오 프레임워크는 확산 모델(Diffusion Models)을 활용하여 고품질이고 일관성 있는 착용 비디오를 구현합니다.
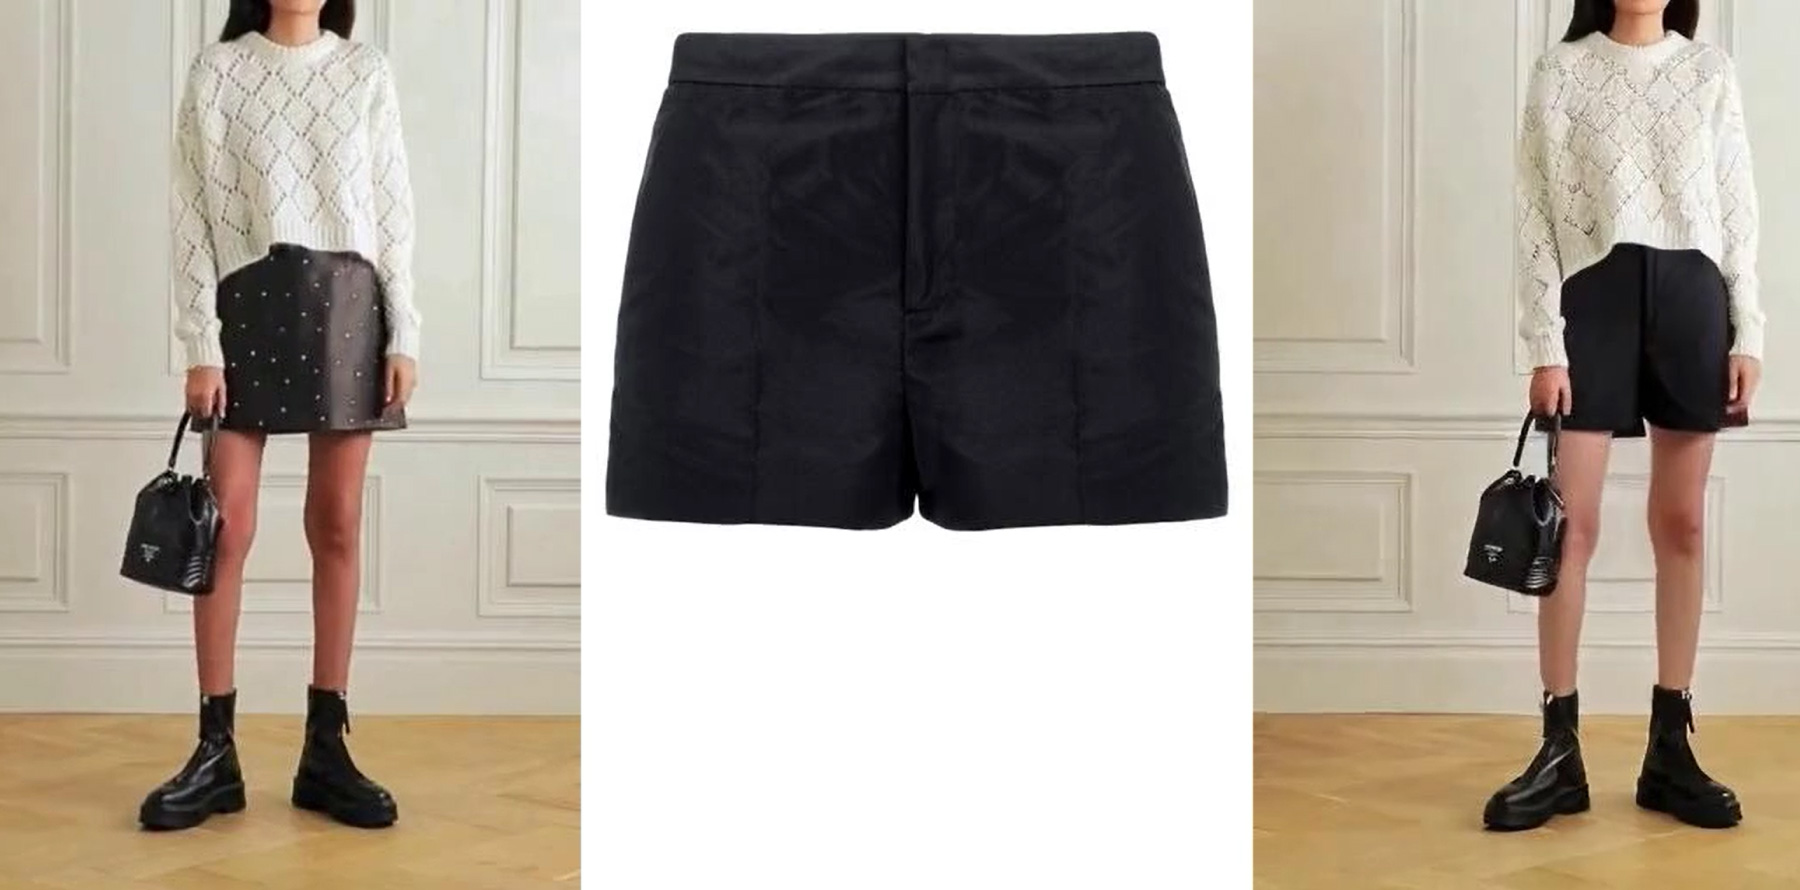
구체적으로, 우리는 의상 인코더를 설계하여 세밀한 의상 의미 특징을 추출하고, 모델이 의상 세부 사항을 포착하도록 안내하고, 제안된 주의 특징 융합 메커니즘을 통해 이를 대상 비디오에 주입합니다. 시공간 일관성을 보장하기 위해, 우리는 경량의 포즈 인코더를 도입하여 포즈 신호를 인코딩하여 모델이 의상과 인간 포즈 간의 상호 작용을 학습할 수 있도록 하고, 계층적 시간 모듈을 텍스트-이미지 안정 확산 모델에 삽입하여 더욱 일관되고 사실적인 효과 비디오 합성을 얻습니다.
또한, 우리는 지금까지 비디오 가상 착용 작업에서 가장 크고, 의류 유형이 가장 다양하며, 해상도가 가장 높은 새로운 데이터 세트를 수집했습니다. 광범위한 실험을 통해 우리의 방법이 만족스러운 비디오 착용 결과를 생성할 수 있음이 입증되었습니다. 데이터 세트, 코드 및 가중치는 공개될 예정입니다.









