
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
SignLLM: 최초의 다국어 수어 생성 모델
小编 ·

SignLLM: 최초의 다국어 수어 생성 모델
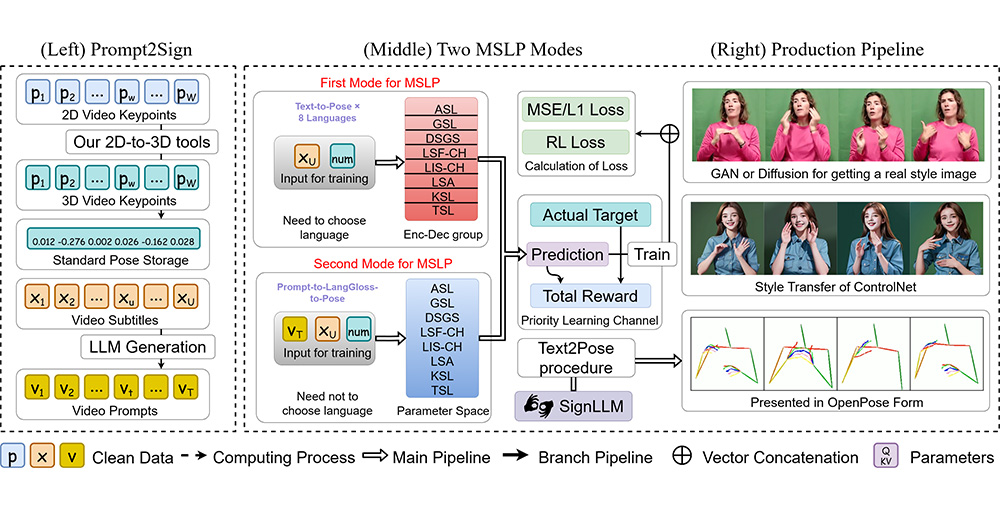
SignLLM은 최초의 다국어 수화 생성 모델로, 입력된 텍스트나 프롬프트를 해당 수화 제스처 동영상으로 변환할 수 있습니다. SignLLM은 고급 ai 기술을 통해 다양한 수화를 생성하고 번역합니다. SignLLM은 Prompt2Sign이라는 최초의 다국어 수화 데이터셋을 도입했으며, 이 데이터셋을 기반으로 수화를 생성하는 다양한 모델을 개발했습니다. 이 데이터셋은 대량의 동영상을 모델 학습에 용이한 형식으로 변환하여 seq2seq 및 text2text와 같은 번역 모델의 학습을 최적화했습니다. 이러한 데이터셋을 기반으로 SignLLM의 벤치마크 결과를 보여주며, 우리의 모델이 8개 수화의 수화 생성 작업에서 최첨단 성능에 도달했음을 보여줍니다.
광범위한 다국어 텍스트 코퍼스에서 학습된 대규모 언어 모델(LLMs)의 강력한 번역 능력에서 영감을 받은 SignLLM은, 기성 LLMs를 활용하여 SLT를 처리하는 것을 목표로 합니다. 본 논문에서, 우리는 수화 동영화를 구어의 언어적 특징을 반영하도록 정규화하고, 기성 LLMs의 가독성을 높이기 위해 수화 동영상을 언어 유사 표현으로 변환하는 새로운 SignLLM 프레임워크를 제안합니다.
SignLLM은 두 가지 핵심 모듈을 포함합니다:
1. 벡터 양자화 시각 기호 모듈은 기호 동영상을 일련의 이산 문자 단위 기호 토큰으로 변환합니다.
2. 코드북 재구성 및 정렬 모듈은 이러한 문자 단위 토큰을 최단거리 수송 방정식을 사용하여 단어 단위 기호 표현으로 변환합니다. 기호-텍스트 정렬 손실은 기호와 텍스트 토큰 간의 격차를 추가로 메워 의미적 호환성을 향상시킵니다. 우리는 두 가지 널리 사용되는 SLT 벤치마크에서 최첨단의 무광택(gloss-free) 결과를 달성했습니다.
SignLLM GITHUB 주소: https://signllm.github.io/









