
 脚本プランナー▸
 AIアプリ
 AIニュース
UCloud:AI向け高コスパGPUコンピュートレンタル
UCloud:AI向け高コスパGPUコンピュートレンタル紹介
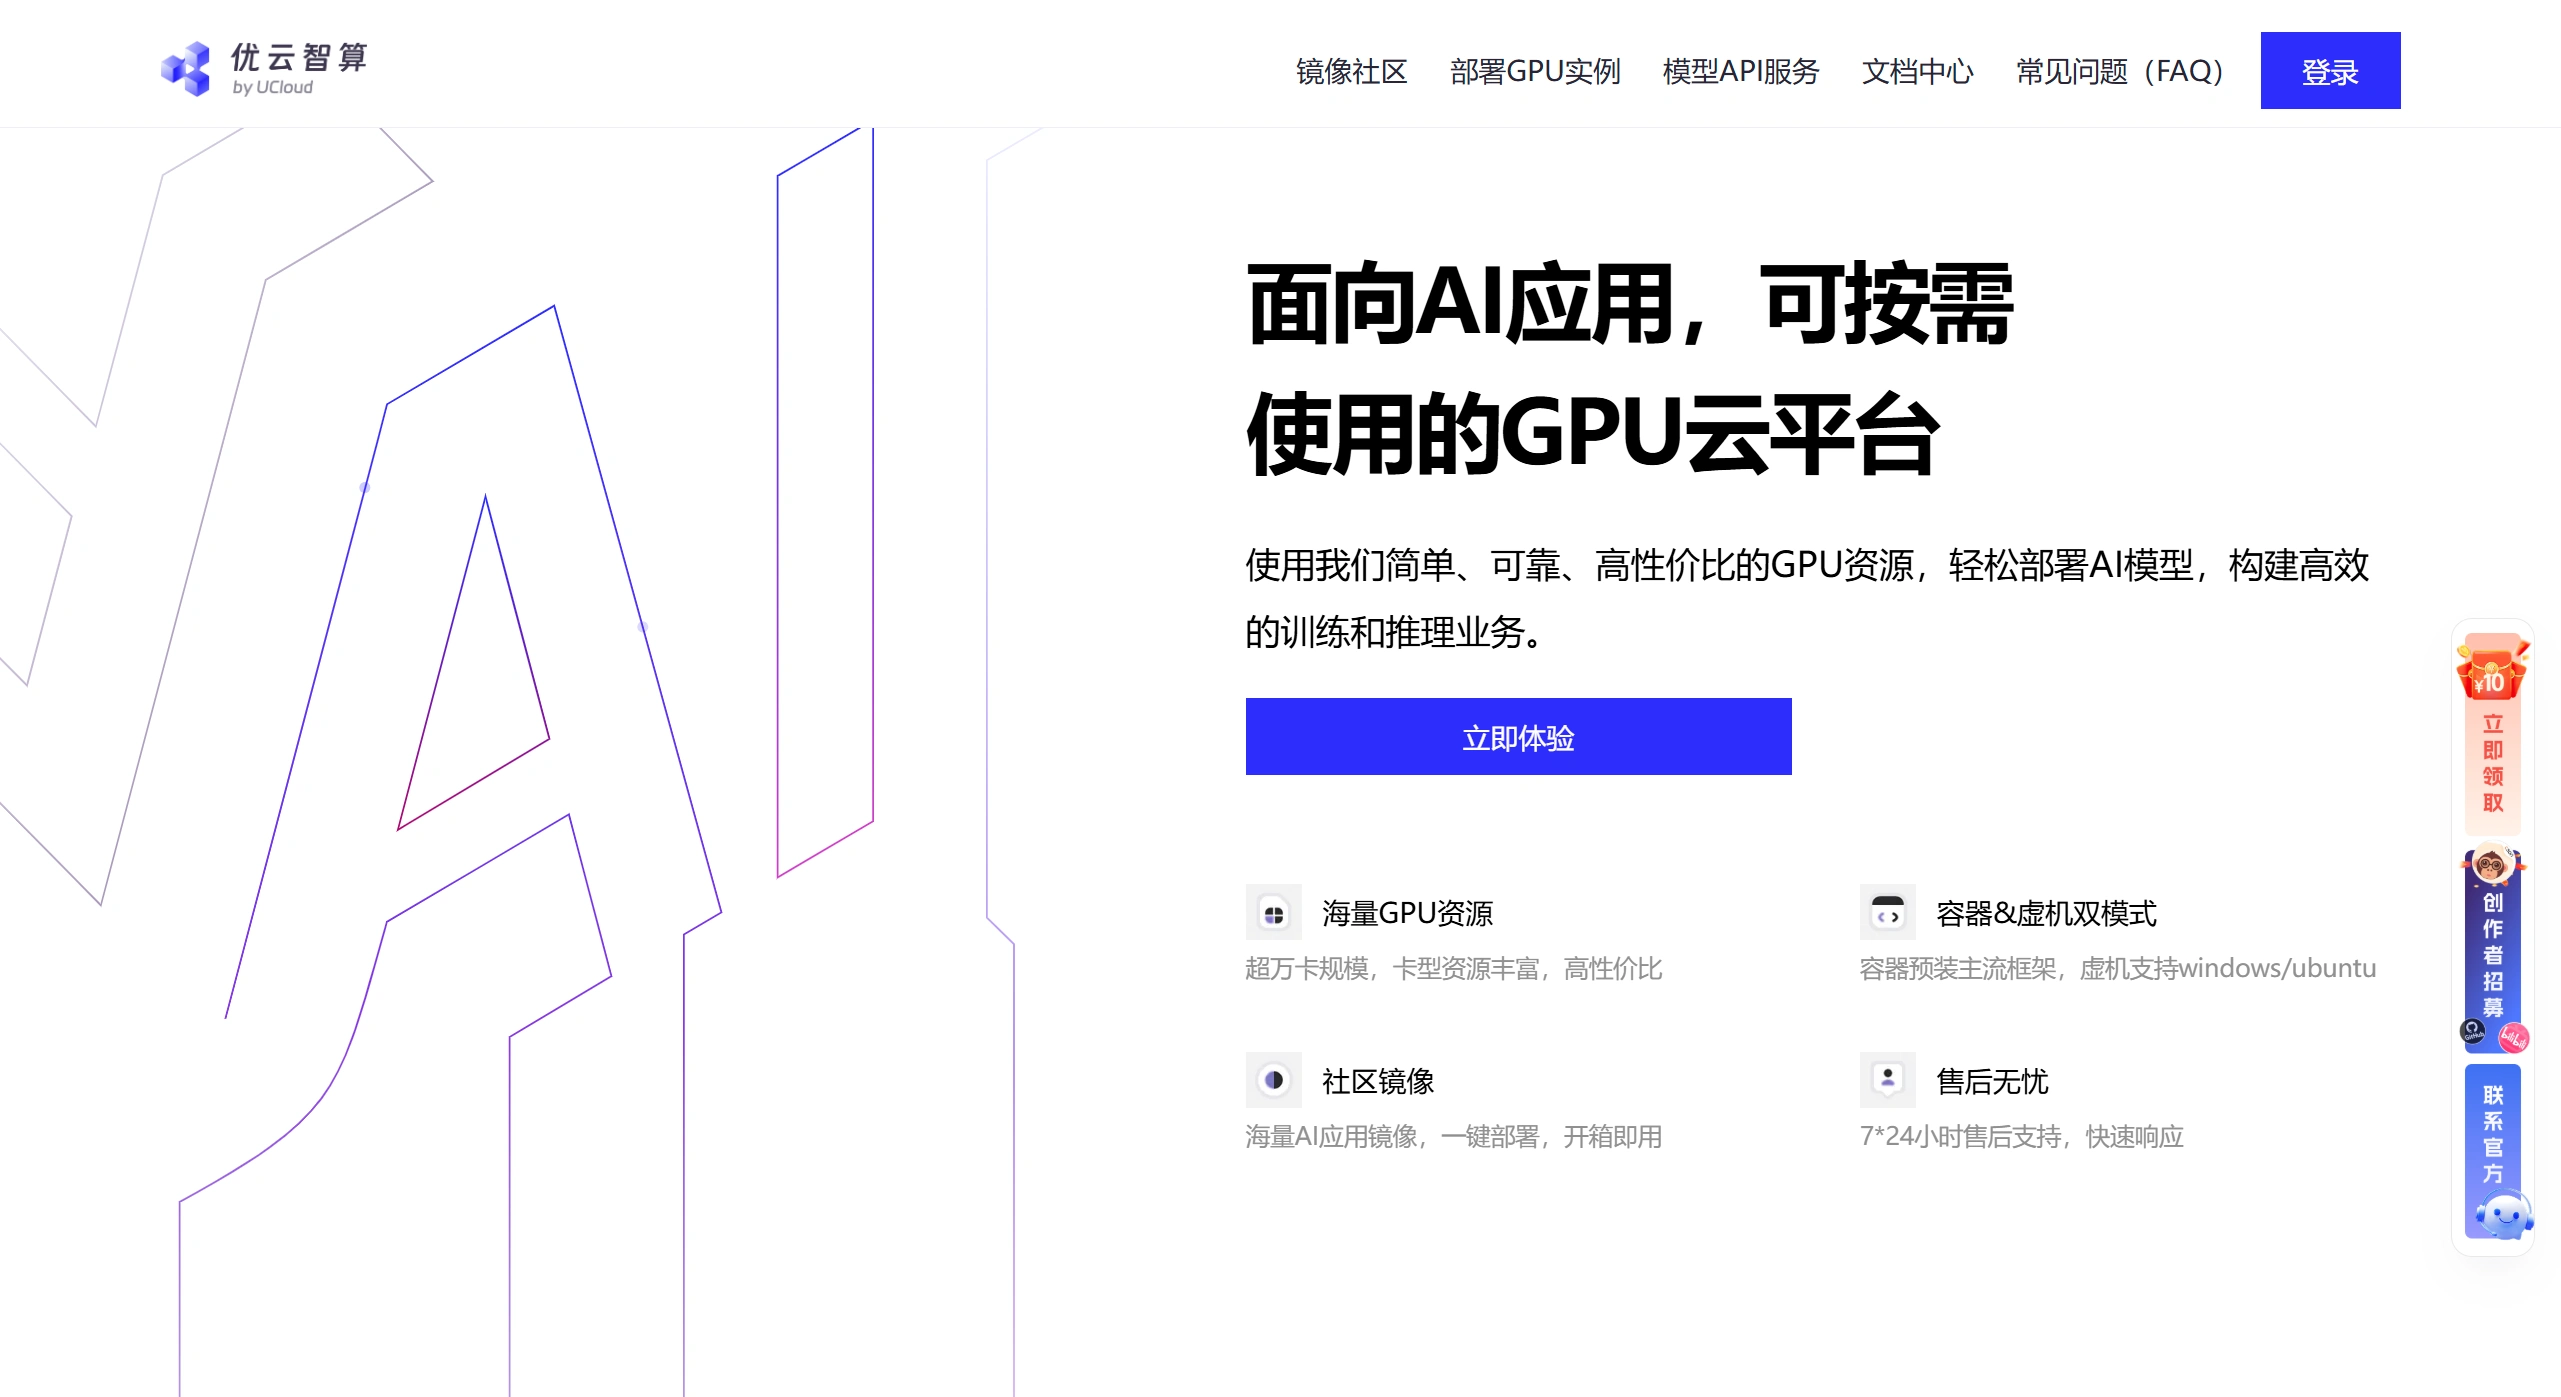
優雲智算はUCloud優刻得旗下的算力プラットフォームで、数万枚の高性能GPUを保有し、グローバルなモデルAPIサービスも提供しています。主にGPUリソースレンタル、aiフルリンクツール、イメージコミュニティを運営しており、研究機関、企業、開発者のAIモデル学習・推論を支援します。研究の成果創出を加速し、利用もシンプルにします。個人から企業まで誰でも利用可能で、登録で無料算力を獲得できます。
優雲智算のコア機能
GPUリソースが豊富で価格も手頃。万単位のカードがあり、型番は5090(32G)、4090(48G/24G)、3090、A100、A800、H20などをカバーしています。会員または校企認証で5%オフになり、最低0.38元/時(2080 8Gなど)。各インスタンスに200Gの無料システムディスクと1.5G帯域幅が付属し、独立した外部IPを取得でき、ポートも自分で設定できます。ディスク容量が不足すれば追加も可能で、起動すればすぐに使え、基本的に待ち時間がありません。
コンテナまたは仮想マシンが利用可能。コンテナにはTensorFlow、PyTorchなどの一般的なフレームワークがプリインストールされており、仮想マシンはWindows、Ubuntuシステムをサポートし、利用感はパブリッククラウドとほぼ同等です。また、学術リソースのダウンロードを加速でき、Github、Hugging Faceなどからのダウンロードが高速になります。
コンピュートスペックは自由に選択でき、1~8カードに対応し、1台のマシンで複数カードを装着することも可能。独立した外部IPがあるため、外部サービス提供やデバッグに便利です。
イメージコミュニティにはLLamaFactory、SD-webUI、LLM、DeepSeekなど多くの既存イメージが揃っており、数分で環境を構築でき、すぐに推論やファインチューニングを開始できます。
リソースのスケジューリングが高速で、起動すればすぐに使えて待ち行列もほぼ発生しません。AI推論、ディープラーニング学習、科学計算など高いパフォーマンスを必要とするタスクに適しています。
アフターサポートは24時間体制で、真夜中でもテクニカルサポートがオンラインで対応し、反応が速いため、研究機関や企業のいつでも利用したいニーズに応えます。
AIフルリンク生産性ツール
モデルAPIサービスはOpenAI、GeminiのAPIと互換性があり、1つのキーで世界中の人気モデルを呼び出せます。LLM、テキストから画像生成、テキストから動画生成などのタイプに対応し、反応が速く、多くのリクエストを同時処理でき、様々なアプリプラットフォームに迅速に連携できます。
その他にも多数のツールが利用可能。公共モデルライブラリが搭載されており、ダウンロード不要で使えます。また、JupyterLab、ComfyUIなどのツールも利用でき、Lora学習、字幕配音、音声からテキストへなどのAI操作を実行でき、学習から推論までをカバーします。
優雲智算の代表的なシナリオ
学習とファインチューニング:大規模モデルの事前学習、垂直領域でのSFT/RLHF、マルチモーダルアラインメントなど。
推論とデプロイ:LLM対話、テキストから画像生成、デジタルヒューマン、音声クローン、レコメンドシステムなどのオンラインサービス。
研究・教育:大学や研究機関が短期間でコンピュートリソースを必要とするケース、コンペティションや授業の実験など。
業界別アプリケーション:エンボディド・インテリジェンス、自動運転、バイオメディカル、金融クォンツ、映画・映像レンダリングなど。
優雲智算の利用フロー
事前準備:アカウント登録と特典受け取り。利用前にアカウント登録が必要で、新規ユーザーにはコンピュート特典があります。手順は以下の通りです:
アカウント登録:Compshare.cn公式サイト(または特別リンクを使用。一部ではより多くのコンピュートクレジットを獲得可能)にアクセスし、携帯番号入力、SMS認証コード受信、パスワード設定(8~24文字、大文字・小文字・数字・アンダースコアのうち少なくとも3種を含む)、規約同意で登録完了です。
新規ユーザー特典受け取り:一般ユーザー登録後はイベントに参加可能です。例えば、指定リンクでの登録で20元のコンピュートクレジット付与(4090クラウドコンピュートを10時間無料利用可)、ブログ投稿で最大500元のクレジットと交換できるイベントも。一部もあります。校企ユーザー認証後は5%オフが適用され、よりお得です。
主要シナリオの利用フロー
優雲智算プラットフォームには主に2つの用途があり、1つはAIコンピュート計算(モデル学習、ディープラーニングなど)、もう1つはクラウドゲーム(例:『黒神話:悟空』)で、フローはそれぞれ異なります。
シナリオ1:AIコンピュート計算(LLAMA3環境の構築を例に)
GPUインスタンスの選択:ログイン後、リソース作成ページに入り、必要に応じてカードタイプを選択します(例:4090 24G/48G、3090、A100など)。4090はコストパフォーマンスが高く、時間単位で最低1.88元/時、月単位ならさらに安価(1.7元/時)で、各インスタンスには200Gの無料システムディスクと1.5G帯域幅が付与されます。
課金方式の選択:時間単位、日単位、月単位が選択可能で、状況に応じて選びます。長期不使用時も課金されないよう注意が必要です。独立した外部IPの有無など設定を確認し、TCP/UDPポートを自分で設定することでリモート管理が容易になります。
インスタンスと環境のデプロイ:コンテナまたは仮想マシンをサポート。コンテナにはTensorFlow、PyTorch、condaなどのフレームワークとCUDA環境がプリインストールされており、自分で設定する手間は不要です。仮想マシンはUbuntuシステム(Python 3.11.7、gcc 11.4.0インストール済み)をサポートし、GUIが必要な場合は、プラットフォーム提供のVNC可視化Docker(例:ImageID:compshareImage-16gb9we1sib0)でワンクリック構築するか、手動でXFCE4デスクトップをインストール(コマンド:apt install -y xfce4 x11vnc)できます。
コミュニティイメージまたは公共モデルライブラリの利用:プラットフォームには300以上のAIイメージがあり(例:LLaMA-Factory、DeepSeek、YOLOv13など)、ワンクリックでデプロイ可能で、環境構築にコストをかけずに済みます。公共モデルライブラリは直接モデルを呼び出せてダウンロード不要で、Hugging Face、Githubへの高速アクセスも提供されるため、データセットやモデルのダウンロードがさらに高速になります。
インスタンスへの接続と操作:リモート接続ツールは多数あります。例えば、FinalShellやVSCodeでターミナル接続、JupyterLab、FileZillaでファイル転送が可能です。ブラウザでUhostにアクセスすれば、操作感はVMwareローカル仮想マシンとほぼ同様で、Linuxへのテキスト貼り付けは「Ctrlを連続3回押し→Ctrl+Vで貼り付け→再度Ctrlを連続3回押して終了」で対応できます。
コンピュートタスクの開始:環境構築後はモデル学習、ディープラーニングなどの作業が可能です。例えば、プリインストール済みのLLaMA-Factoryを使えば、CUDAを自分で設定せずに直接LLAMA3学習を起動できます。特別なソフトウェア(例:Java、Node.js)のインストールが必要な場合は、公式サイトドキュメントを参照し自分で対応可能です。
リソース管理とコスト管理:利用後は必ず手動でシャットダウンしリソースを削除してください。プラットフォームのデフォルトでは期限切れで接続は切断されますが、シャットダウンしていないと課金が継続します(シャットダウンを忘れ10時間空回しして26元請求された事例あり)。シャットダウンすれば課金されないため、無駄な出費を防げます。
学術アクセラレーションの活用:プラットフォームはGithub、Hugging Face、C Stationなどのアクセスを加速でき、追加設定不要でアクセスするだけで高速化されるため、効率が向上します。
シナリオ2:クラウドゲーム体験(『黒神話:悟空』を例に)
ゲームインスタンスの選択:ログイン後、トップページで「クラウドゲーム」を探し、『黒神話:悟空』がプリインストールされたインスタンスを直接選択できます。自分でダウンロード・インストールする必要はありません。
ゲームの起動:「起動」をクリックすると、プラットフォームがクラウドの高性能GPUでゲームを実行し、ブラウザでプレイ可能です。ローカルデバイスの性能に左右されず、フレームレートが安定し、カクつきやフレームドロップの心配がありません。
重要な操作テクニックと注意事項
リモート接続とファイル転送:
ターミナル接続:FinalShellにインスタンスIP、ポート、アカウント・パスワードを入力すればリモート操作が可能。VSCodeはSSHプラグインで接続すれば、コーディングやデバッグがより便利になります。
ファイル転送:JupyterLabでファイルを直接ドラッグ&ドロップするか、FileZilla、XFTPでFTP経由で大容量ファイルも高速転送できます。
環境の追加:インスタンスに必要なソフトウェアがインストールされていない場合(例:Java、Node.js)は、自分でインストールする必要があります(JavaはOracle公式サイト、Node.jsは公式ドキュメントを参照)。インストールしないとプロジェクトに影響を及ぼす可能性があります。
認可が必要なモデルライブラリ(例:Hugging Faceの一部プライベートモデル)にアクセスする場合は、プラットフォームで事前に認可手続きを行ってください。手続きしないと「access denied」と表示されます。
li>料金とリソース管理:使用時間や消費した金額をリアルタイムで確認し、アラームを設定して使いすぎを防ぎましょう。長期的に利用する方には月額プランがお得でおすすめです。
「カードなし起動」を活用する:データ送信時はカードなしモードを選択し、GPUの演算能力を使わずにストレージ料金のみを支払うことで、より節約できます。















