脚本プランナー▸
 AIアプリ
 AIニュース

Scrapeless:AI駆動のWebスクレイピングツール
Scrapeless:AI駆動のWebスクレイピングツール紹介
Scrapelessとは?
Scrapelessは、ai駆動のウェブスクレイピングツールで、ウェブサイトから構造化データを効率的に抽出します。ヘッドレスブラウザモードをサポートし、自動的にCAPTCHAやIPブロックを回避します。また、世界195カ国以上をカバーする高品質なプロキシサービスを搭載しています。そのスクレイピングAPIはシンプルで使いやすく、企業や開発者の大規模データ収集に適しています。データクリーニングと変換機能を備え、データの正確性と可用性を確保します。Scrapelessは無料トライアルを提供しており、効率的なデータ収集を支援します。
Scrapelessのコアツール
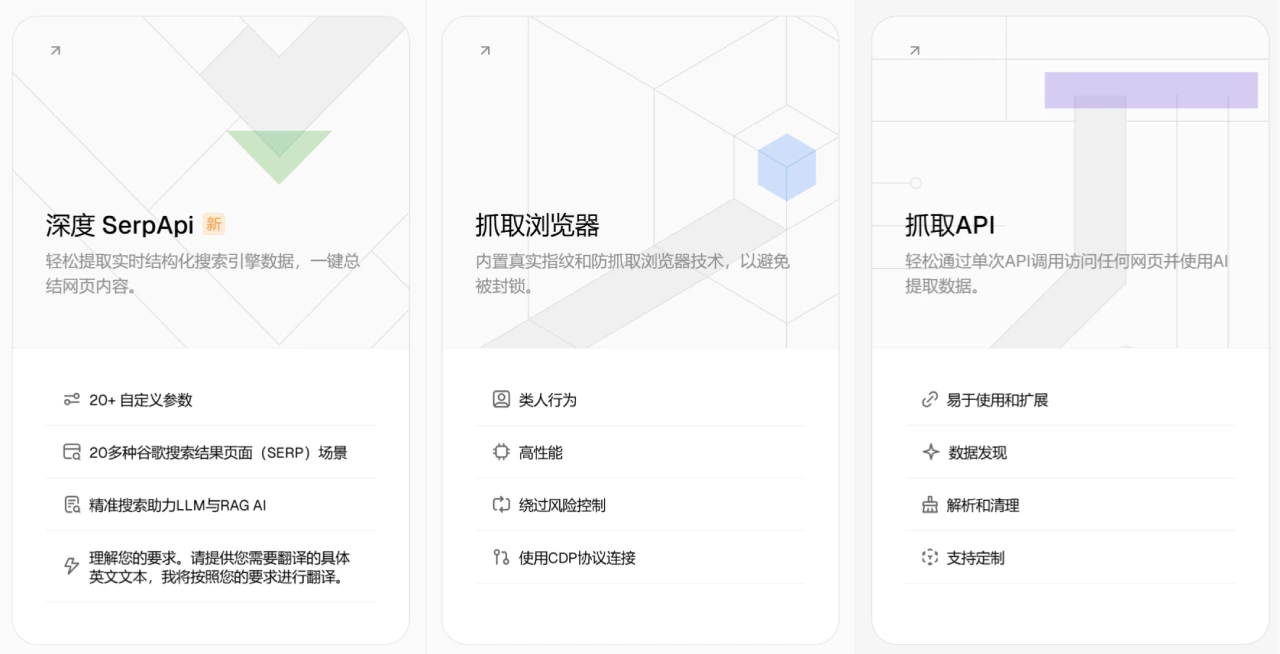
スクレイピングAPI:1回のAPI呼び出しで任意のウェブサイトから構造化データを取得でき、大規模データ抽出に適しています。
スクレイピングブラウザ:AI駆動で、ヘッドレスブラウザモードをサポートし、実際のユーザー行動をシミュレートして動的コンテンツを簡単にスクレイプできます。
ウェブアンロッカー:CAPTCHA、IPブロック、動的コンテンツの制限を自動的に回避し、データ収集を中断なく行います。
プロキシサービス:高品質でローテーション可能なプロキシを提供し、世界195カ国以上をカバーしてIPブロックを回避します。
CAPTCHAソルバー:reCAPTCHAやCloudflareなど、さまざまなCAPTCHAを自動的に解決し、スクレイピングプロセスをスムーズにします。
Scrapelessの優位性
効率的なデータ抽出:複雑なウェブサイトから迅速かつ正確にデータを抽出し、高同時実行と高性能なスクレイピングをサポートします。
柔軟なカスタマイズ:企業の要件に応じてカスタマイズソリューションを提供し、さまざまなビジネスシナリオに対応します。
データクリーニングと変換:データの正確性と可用性を向上させ、生のデータを価値ある情報に変換します。
セキュリティとプライバシー:高度なセキュリティ対策を採用し、厳格にコンプライアンス基準を遵守してユーザーデータを保護します。
コスト効率:成功したリクエストに対してのみ料金が発生し、柔軟な価格プランを提供します。
Scrapelessの使用シナリオ
エンタープライズレベルのデータスクレイピング:重要なビジネスプロジェクトに高品質でカスタマイズされたウェブスクレイピングソリューションを提供します。
リアルタイムデータプッシュ:強力なAPI統合により、アプリケーションと最新情報を同期させます。
自動化ワークフロー:データ収集プロセスを簡素化し、手作業を減らして作業効率を向上させます。
Scrapelessの対象ユーザー
企業:大規模で効率的なデータ収集が必要な企業。
開発者:迅速かつ簡単にウェブからデータを取得したい開発者。
データ分析専門家:信頼性が高く効率的なデータ抽出ツールを必要とする専門家。
Scrapelessの使用チュートリアル
1. アカウント登録:Scrapeless公式サイトにアクセスし、無料トライアルアカウントを登録します。トライアル期間中はクレジットカードは不要です。
2. APIキーの取得:登録してログインしたら、ダッシュボードからAPIキーを取得し、リクエストの認証に使用します。
3. ツールの選択:ニーズに応じて、スクレイピングブラウザ、スクレイピングAPI、ウェブアンロッカー、CAPTCHAソルバー、プロキシなどのツールを選択します。
4. SDKのインストール:プログラミング言語用のScrapeless SDKをインストールします(例:Python、Node.jsなど)。
5. リクエストの送信:APIキーを使用してリクエストを送信します。基本リクエストにはターゲットURLと認証資格情報が含まれます。例えば、PythonでスクレイピングAPIを呼び出すコードは以下の通りです:
import requests
import json
API_KEY = "your_api_key"
host = "api.scrapeless.com"
url = f"https://{host}/api/v1/unlocker/request"
payload = json.dumps({
   "actor": "unlocker.webunlocker",
   "input": {
      "url": "https://httpbin.io/get",
      "redirect": False,
      "method": "GET",
   },
   "proxy":{
       "country": "ANY",
   }
})
headers = {
   'Content-Type': 'application/json',
   'x-api-token': f'{API_KEY}'
}
response = requests.request("POST", url, headers=headers, data=payload)
print(response.text)
6. レスポンスの処理:JSON形式で返されるスクレイピングデータはすでにクリーニングされ構造化されているため、すぐに利用できます。
7. スクレイピング規模の拡大:必要に応じて同時実行リクエストとスクレイピング量を増やします。Scrapelessは自動的にアンチボット対策を処理します。
8. 使用状況の監視:ダッシュボードを通じてAPIの使用状況、成功率、残りのクレジットを追跡します。
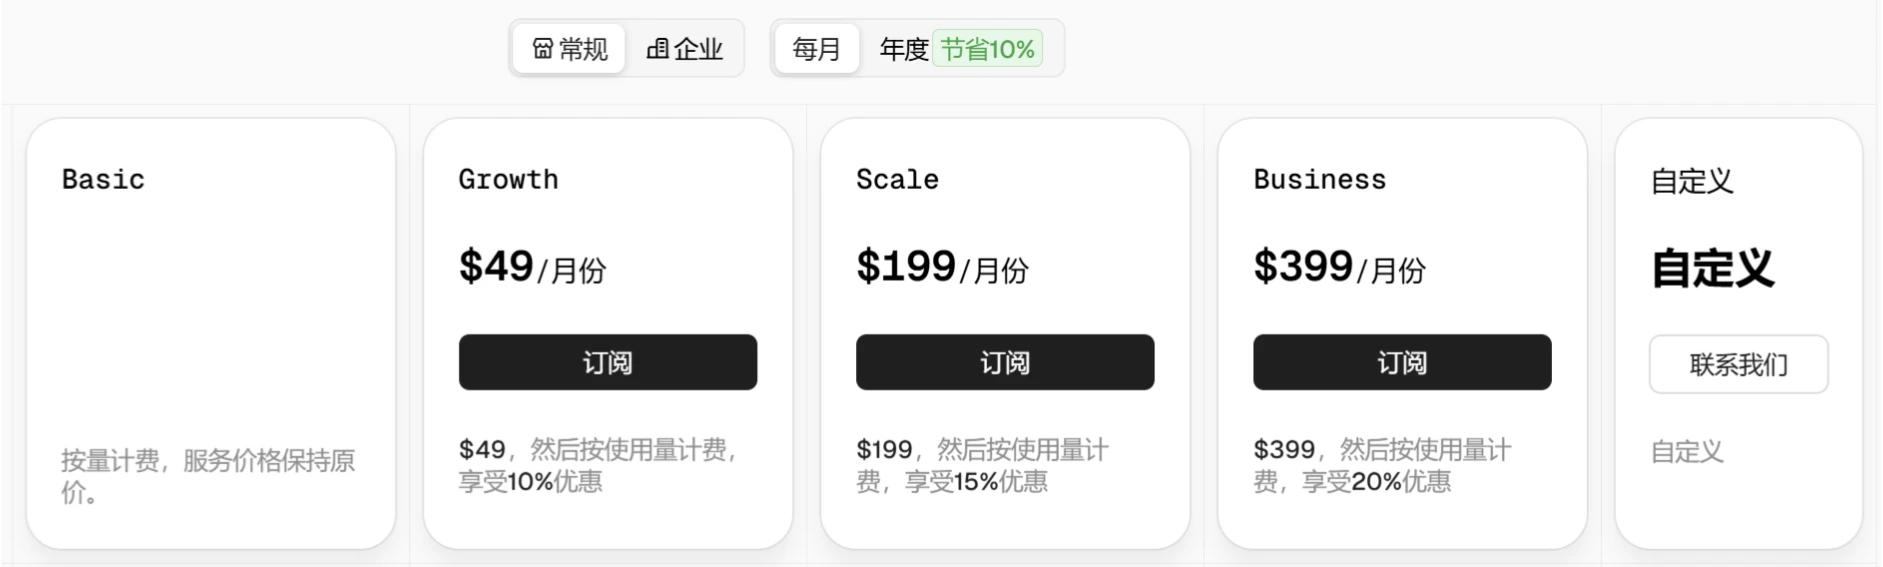
Scrapelessの価格